开源模型进企业:CIO关注点转向数据流向
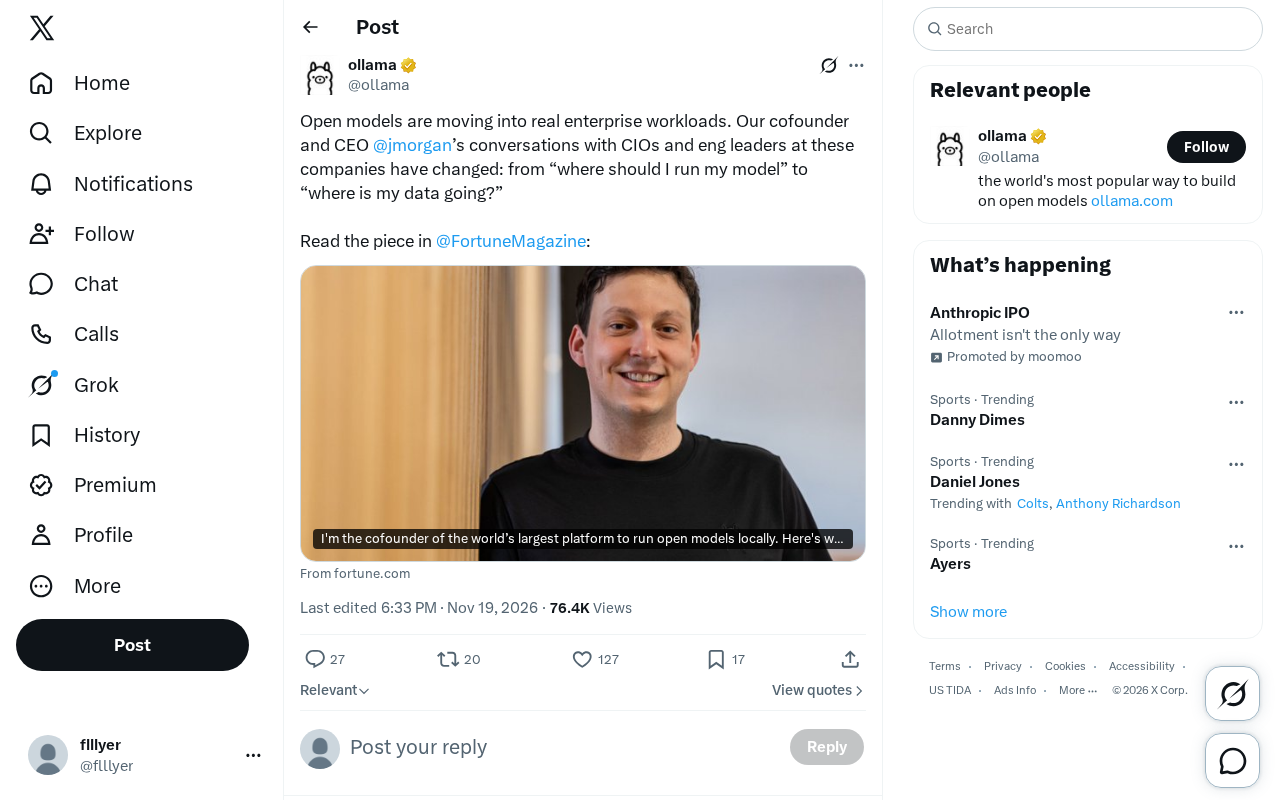
企业CIO对开源模型的提问从部署位置转向数据流向,标志其进入生产工作负载阶段。
文章基于某开源模型公司CEO与多家企业CIO的对话观察,指出企业关注点已从“模型跑在哪里”转向“数据要去哪儿”,标志着开源模型跨过试验田进入生产系统。数据流向担忧集中在合规审计、知识产权和内部治理三个层面。开源模式将数据治理责任从供应商转移给企业,部署自主权伴随治理义务。文章认为这是开源模型企业化的拐点信号,竞争维度将从性能与成本扩展到信任与可控。模型厂商需提供数据链路透明度与审计能力,才能通过企业采购评估。该观察来自单一来源,尚需更广泛调研验证。
从部署位置到数据流向:企业AI焦虑的迁移
开源模型正在进入真实的企业工作负载——这不是一句口号,而是来自一线对话的真实变化。某开源模型公司联合创始人兼CEO在与多家企业的CIO和工程负责人交流后发现,问题变了:过去大家问的是"我的模型应该跑在哪里",现在问的是"我的数据要去哪儿"。
这个转变看似微妙,实则标志着一个阶段性的跨越。当开源模型还处于概念验证阶段时,企业最关心的是基础设施可行性:本地部署还是云端、GPU够不够、推理延迟能不能接受。而当模型真正嵌入业务流程,数据治理、隐私边界与合规风险就成了绕不开的议题。问题从"能不能跑"变成"跑起来之后数据怎么管",说明开源模型已经跨过了试验田,进入了生产系统。
据该CEO在《Fortune》杂志撰文中的观察,这一变化在与多家公司CIO和工程领导者的对话中反复出现。尽管原文未披露具体企业名称与行业分布,但"工作负载"一词的使用本身已说明问题:这些不是演示项目,而是承载业务逻辑的真实系统。
为什么数据流向成了首要问题
企业将开源模型部署到自有环境,初衷往往是数据不出域。但现实比初衷复杂。一个模型在训练、微调、推理、日志记录、监控等环节都可能产生数据流动,开源模型虽然权重开放,却不等于数据链路自动可控。
CIO们的追问反映出三层担忧。第一层是合规:行业监管对数据跨境、敏感信息处理有明确要求,模型调用链路上的任何外部依赖都可能成为审计缺口。第二层是知识产权:企业输入模型的数据是否会被用于改进服务、是否可能泄露给第三方,需要合同与技术双重保障。第三层是内部治理:当多个业务团队各自接入模型,数据流向的可见性和可追溯性会迅速下降。
这些问题不是开源模型独有的,但开源模型让企业获得了部署自主权,也就同时接过了数据治理的责任。闭源API模式下,数据流向由供应商定义;开源模式下,企业需要自己画出数据地图。责任转移了,焦虑自然也跟着转移。
数据跨境与合规审计:在许多司法辖区(如欧盟GDPR、中国《数据安全法》与《个人信息保护法》),数据跨境传输需要满足特定条件,如标准合同条款、安全评估或认证机制。企业使用开源模型时,若推理请求经过境外托管的依赖服务(如模型下载源、遥测上报、第三方API),就可能触发跨境合规审查。审计缺口通常出现在非显性数据流上——例如推理框架默认开启的使用统计上报、日志聚合服务的外部同步、微调过程中上传至公共模型库的检查点。CIO需要绘制完整的“数据流地图”,逐一确认每个环节的接收方、存储位置与保留期限,才能通过合规评估。
模型权重开放与数据链路可控的区分:开源模型通常指模型权重和推理代码以开放许可证发布,企业可下载并在自有基础设施上运行。但“权重开放”仅保证模型参数可获取,并不保证运行时的数据链路封闭。实际部署中,模型可能依赖外部包管理器拉取依赖、调用云端分词服务、向监控平台发送指标,或在微调时使用第三方数据标注平台。这些环节构成隐性数据出口。因此,企业需要将开源模型视为一个需要独立审计的软件组件,而非天然安全的数据孤岛。
开源模型的企业化拐点
从"在哪里跑模型"到"数据去哪里",这个问题的切换可以看作开源模型企业化的一个拐点信号。拐点之前,技术选型的核心是性能与成本;拐点之后,核心是信任与可控。
这对开源模型生态提出了新的要求。模型提供方需要更清晰地说明数据处理边界,工具链需要内置更细粒度的数据流向审计能力,企业架构团队则需要把模型纳入既有的数据治理框架,而不是另起一套。那些只强调模型能力、不谈数据链路的方案,在企业市场的说服力会越来越弱。
值得强调的是,这一观察来自单一来源的CEO对话总结,尚未有更广泛的行业调研数据交叉验证。但问题本身的指向是明确的:开源模型要真正承载企业工作负载,数据流向的透明度与可控性将与模型能力同等重要。
企业数据治理框架的对接要点:将开源模型纳入既有数据治理框架时,企业通常需要完成几项映射工作:一是数据分类分级,明确输入模型的业务数据属于哪一级别、是否含个人敏感信息;二是访问控制,确保只有授权团队能调用模型接口并记录调用者身份;三是日志与审计,统一推理日志的格式、存储位置与保留周期,使其与既有审计系统兼容;四是供应商管理,对模型提供方及任何第三方依赖进行安全评估。另需注意,开源许可证(如Apache 2.0、MIT)通常不涉及数据使用条款,企业需自行通过内部政策和技术手段约束数据流向,而不能依赖许可证提供数据保护。
常见问题
开源模型部署后,数据还会外流吗? 取决于部署方式和配套工具。模型权重开源不等于数据链路自动封闭,推理日志、监控上报、依赖服务等环节都可能产生数据流动,需要企业逐一确认。
CIO应该先关注模型能力还是数据治理? 从一线对话看,当模型进入生产工作负载后,数据治理的优先级会快速上升。两者不是二选一,但数据流向不清会直接阻碍模型落地。
这一变化对开源模型厂商意味着什么? 意味着竞争维度扩展:除了模型性能,还需要提供数据流向的清晰说明与审计能力,否则难以通过企业采购的数据合规评估。
相关推荐
Yung Pueblo谈自我觉察:一本365天的心灵变革指南
Yung Pueblo在Talks at Google访谈中分享新书《Journey》的365天自我觉察结构,探讨冥想、直觉、关系共同领导与感恩实践,提出与改变做朋友的日常行动建议。
黎曼猜想被Lean形式化验证?联合声明引发热议
Lean社区博客发布黎曼猜想形式化验证联合声明,在Hacker News引发359分、263条评论的热议。本文解析Lean与mathlib的形式化验证背景、社区两极反应,以及为何在读到原文前不宜断言黎曼猜想已被证明。

FBI与USDA遭黑客攻击:关键基础设施安全再响警报
FBI与USDA据报遭黑客攻击,FBI近几个月内第二次被入侵,本次目标为国家犯罪信息中心(NCIC)。本文分析事件细节、NCIC的战略价值及政府机构面临的共性安全挑战。