开源AI模型崛起:生态协作如何驱动技术创新

一条推文背后的开源信号
近日,一条简短却充满力量的推文在AI圈引发关注:"Congrats to the team! Bullish on open models and all the partners we make along the way!"(祝贺团队!看好开源模型以及一路走来结识的所有合作伙伴!)。这句话虽短,却折射出当前AI行业一个愈发清晰的趋势——开源模型正在从边缘走向主流,而生态协作成为其核心驱动力。
在过去两年里,AI领域的竞争格局经历了显著变化。从最初闭源大模型一枝独秀,到如今开源阵营的强势崛起,行业的话语权正在被重新分配。这条推文中"bullish"(看好)一词,恰恰代表了越来越多从业者、投资人和技术团队对开源路线的信心。
为什么开源AI模型值得看好?
技术民主化降低准入门槛
开源模型最大的价值在于打破了技术壁垒。过去,只有少数科技巨头才有能力训练和部署顶尖大模型。而随着 Llama、Mistral、Qwen、DeepSeek广告 等一系列开源模型的发布,中小企业、研究机构乃至个人开发者都能够在此基础上进行二次开发和定制。
这些开源模型各有其技术特色和行业意义。Llama系列由Meta发布,从Llama 1到Llama 3经历了多次迭代,参数规模从7B扩展到405B,其采用的GQA(分组查询注意力)等架构创新大幅提升了推理效率。GQA是对标准多头注意力(MHA)和多查询注意力(MQA)的折中方案——在标准Transformer中,每个注意力头都有独立的Query、Key、Value投影矩阵,带来巨大的显存开销。MQA让所有头共享同一组Key和Value,虽然大幅降低了成本,却可能损失表达能力。GQA将注意力头分成若干组,组内共享Key-Value对,在效率和性能之间取得了更好的平衡,这项技术对长上下文推理尤为重要,因为KV Cache的显存占用会随序列长度线性增长。
Mistral由前DeepMind和Meta研究员创立的法国公司推出,其Mixtral系列采用了稀疏混合专家(Sparse MoE)架构——这种架构允许模型在推理时只激活部分参数,在保持高性能的同时显著降低了计算成本。MoE架构的核心思想源自"分而治之":模型包含多个专家子网络(通常是前馈网络),每次推理时由一个门控网络(Router)选择最相关的少数专家来处理输入。例如Mixtral 8x7B拥有约47B总参数,但每个token只激活约13B参数,这意味着模型的总容量可以非常大,但实际计算成本得到有效控制。MoE架构的训练挑战包括负载均衡问题(避免某些专家被过度使用而其他专家闲置)和分布式训练中的通信开销。
Qwen(通义千问广告)由阿里巴巴推出,是中文开源大模型的重要代表,在多模态能力上持续发力。DeepSeek则以其高效训练策略和极具竞争力的性能引发行业震动,其在DeepSeek-V2/V3中进一步引入了细粒度专家分割和共享专家机制,将MoE架构推向新的高度,其训练方法论为业界提供了重要参考。这些模型的集体涌现,标志着开源AI已经进入百花齐放的成熟阶段。
这种技术民主化带来的直接效应,是创新速度的指数级提升。当模型权重公开、社区可以自由改进时,整个行业的迭代节奏被大大加快。一个团队的突破,能够迅速被全球开发者验证、优化和扩展。
值得注意的是,AI模型的"开源"与传统软件开源存在重要差异。传统开源软件公开源代码即可完整复现功能,而AI模型的开源涉及多个层面:模型权重(weights)、训练代码、训练数据、数据处理流程以及对齐/微调方法等。目前大多数"开源模型"实际上主要公开了模型权重和推理代码,但训练数据和完整训练流程往往并未完全公开。这也引发了业界关于"真正开源"定义的持续讨论——OSI(开源促进会)正在制定AI领域的开源定义标准,试图厘清哪些组件必须公开才能称为"开源AI"。此外,不同模型采用的许可证差异很大,从完全宽松的Apache 2.0到附带商业限制的自定义许可证,使用者需要仔细甄别。
成本与数据安全的双重优势
对于企业用户而言,开源模型意味着更低的使用成本和更强的数据可控性。相比调用闭源API所产生的持续费用,本地部署开源模型可以显著降低长期运营成本。同时,数据无需上传至第三方服务器,满足了金融、医疗等对隐私要求极高行业的合规需求。
企业本地部署开源模型的可行性,很大程度上得益于近年来模型压缩和推理优化技术的快速发展。其中,模型量化(Quantization)是最关键的技术之一——它将模型参数从32位浮点数压缩为8位、4位甚至更低精度的整数表示,使得原本需要多张高端GPU才能运行的大模型可以在消费级硬件上流畅推理。量化的本质是用更少的比特数来表示模型参数,这是一种有损压缩过程。以INT4量化为例,将FP32参数压缩为4位整数可以将模型体积缩小约8倍,显存需求和计算带宽需求也相应大幅降低。
GPTQ、AWQ、GGUF等量化格式和方法各有优劣。GPTQ基于二阶信息(Hessian矩阵的近似)逐层量化权重,精度较高但量化过程需要校准数据;AWQ(Activation-aware Weight Quantization)观察到不同权重通道对模型输出的重要性差异巨大,通过保护关键通道来维持性能;GGUF是llama.cpp项目开发的格式,支持混合精度量化和CPU推理,极大拓展了可用硬件范围。量化不可避免地带来一定的性能退化,但在4-bit甚至3-bit量化下,许多模型仍能保持90%以上的原始性能,这一发现极大推动了开源模型在消费级硬件上的普及。而社区工具如llama.cpp更是让在CPU上运行大模型成为可能。
推理框架层面,vLLM引入的PagedAttention技术大幅提升了显存利用效率。PagedAttention借鉴了操作系统中虚拟内存的分页管理思想,解决了LLM推理中KV Cache显存管理的核心瓶颈。在传统实现中,每个请求的KV Cache需要预分配连续显存空间,由于生成长度未知,系统通常按最大长度预分配,导致大量显存浪费(碎片化率可达60-80%)。PagedAttention将KV Cache分割为固定大小的块,按需分配并通过块表映射,将显存浪费降低到4%以下,还天然支持请求间的KV Cache共享,极大提升了批处理吞吐量。TensorRT-LLM提供了深度硬件优化,SGLang等新兴框架也在持续提升推理吞吐量并降低延迟。这些技术突破使得本地部署从理论可行变为实际可行,成为企业选择开源模型的重要推动力。
合作伙伴生态:开源模型的核心竞争力
推文中特别强调了"all the partners we make along the way"(一路走来结识的所有合作伙伴),这一点尤为值得深思。在开源时代,单打独斗的模式难以持续,构建繁荣的合作生态才是真正的竞争力所在。
从单一模型到完整生态系统
一个成功的开源模型,背后往往是一整套生态系统的支撑:包括推理框架、微调工具、部署平台、云服务商,以及围绕它构建应用的开发者社区。以 Hugging Face 为代表的模型托管平台,正是这种生态协作的典型体现——它连接了模型发布者、工具开发者和终端用户,形成了正向循环。
Hugging Face成立于2016年,最初是一家聊天机器人公司,后转型为AI模型托管和协作平台,目前估值已超过45亿美元,在开源AI生态中扮演着类似GitHub之于软件开发的角色。平台上托管了超过50万个模型、10万个数据集,以及大量的Spaces(在线演示应用)。其核心开源库Transformers已成为NLP和多模态AI开发的事实标准,支持PyTorch、TensorFlow和JAX等多个深度学习框架。此外,Hugging Face还推出了Accelerate(分布式训练工具)、PEFT(参数高效微调库)、TRL(基于人类反馈的强化学习工具)等一系列配套工具,大大降低了模型微调和部署的技术门槛。围绕它形成的开发者社区和工具链,已经成为开源AI不可或缺的基础设施。
协作创造的复利效应
每一个新加入的合作伙伴,都可能为整个生态带来新的能力和用户。芯片厂商优化硬件适配,云平台提供算力支持,工具团队打磨开发体验,应用开发者创造实际价值。这种多方协作产生的复利效应,是闭源体系难以复制的。
在硬件层面,这种生态协作正在催生一场围绕AI推理芯片的激烈竞争。NVIDIA凭借CUDA生态长期主导AI训练和推理市场。CUDA不仅是编程接口,更是包含cuDNN、cuBLAS、TensorRT等数百个优化库的完整工具链,开发者的迁移成本极高。但开源模型的标准化正在削弱这种锁定效应。AMD通过ROCm软件栈和MI300系列加速器积极争夺市场份额,Intel推出的Gaudi系列AI加速器也在寻求突破。
更值得关注的是,专注于推理场景的新兴芯片公司正在开辟全新的技术路线。Groq采用LPU(Language Processing Unit)架构,抛弃了传统GPU的缓存层级和动态调度,以硬件流水线的方式执行推理,实现了可预测的超低延迟(首token延迟可低至数毫秒)和极高的单流吞吐量。Cerebras的WSE(Wafer Scale Engine)将整个晶圆做成一块芯片,拥有数十万个核心和巨大的片上存储,特别适合处理大模型的参数密集型计算。在端侧,高通的Hexagon NPU、苹果的Neural Engine正推动3B-7B参数的小型开源模型在手机上实时运行,从离线助手到实时翻译,为开源模型打开了全新的应用场景。这种硬件层面的多元竞争,反过来推动了开源模型在部署效率和可及性上的持续提升。
正如推文所传递的情感——对合作伙伴的感激和对未来的期待,开源社区的凝聚力本身就是一种宝贵资产。
开源与闭源:互补而非对立
说个细节,看好开源并不意味着否定闭源。当前行业正在形成一种更成熟的认知:开源与闭源并非零和博弈,而是各有适用场景的互补关系。
闭源模型在顶尖能力、安全对齐和商业化服务上仍有优势,而开源模型则在灵活性、成本和可定制性上更胜一筹。许多企业选择混合策略——用闭源模型处理最复杂的任务,用开源模型承担大规模、高频次的常规工作。
从量化指标来看,开源与闭源模型之间的能力差距正在以超出预期的速度缩小。在MMLU(大规模多任务语言理解)、HumanEval(代码生成)、GSM8K(数学推理)等主流基准测试中,顶尖开源模型的得分已经逼近甚至在部分维度上超越了GPT-4等闭源模型。MMLU涵盖57个学科的约16000道多选题,从高中到专业水平不等,是衡量模型知识广度的重要指标;HumanEval包含164个Python编程任务,测试代码生成和逻辑推理能力;GSM8K包含8500道小学数学应用题,看似简单但需要多步推理。然而,业界对这些基准的质疑也在增加:部分模型可能在训练数据中见过测试题(数据污染),高分不一定代表真实能力的提升。更实际的评估方法如Chatbot Arena采用真人盲评和Elo评分系统,让用户对匿名模型的回答进行两两比较,更接近真实使用场景的体验。
以2024年为例,Llama 3.1 405B和DeepSeek-V3在多个基准上展现出与闭源领先者相当的水平。值得注意的是,"安全对齐"(Safety Alignment)是闭源模型仍然保持优势的领域——OpenAI、Anthropic等公司在RLHF(基于人类反馈的强化学习)、Constitutional AI等对齐技术上积累了大量专有经验和数据。RLHF的标准流程包括三个阶段:监督微调(SFT)、奖励模型训练和PPO(近端策略优化)强化学习,这个过程需要大量高质量的人类偏好标注数据和复杂的训练流程,成本极高且不稳定。Anthropic提出的Constitutional AI则引入了一套明确的规则体系("宪法"),让模型通过自我批评和修正来实现对齐,减少了对人类标注的依赖。
但开源社区也在迎头赶上。DPO(直接偏好优化)的突破在于证明了可以绕过奖励模型训练,直接用偏好数据对策略进行优化,将对齐过程简化为一个标准的分类问题——这使得训练流程更稳定、计算成本更低,也更容易被开源社区复现和采用。后续的变体如IPO(Identity Preference Optimization)、KTO(Kahneman-Tversky Optimization)进一步降低了数据要求,有的方法甚至只需要正面示例即可进行对齐训练,正在从根本上降低安全对齐的技术门槛。
随着开源模型能力持续逼近甚至在部分任务上超越闭源模型,这场竞争正在进入一个更加精彩的新阶段。
结语:拥抱开放的长期主义
这条简短的推文,本质上是一次对开放理念的公开表态。它所代表的,不仅是对某个团队成果的祝贺,更是对整个开源AI运动的坚定信心。
在AI技术加速演进的今天,选择开放、拥抱协作,或许正是通向可持续创新的正确路径。当越来越多的团队和伙伴汇聚在开源的旗帜下,这个行业的边界将被不断拓展。
正如那句充满斗志的收尾——Let's go。开源的故事,才刚刚开始。
相关推荐
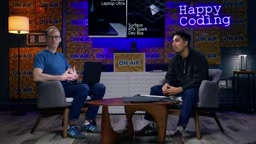
Surface RTX Spark Dev Box 离线跑通 120B 模型:Intelligent Terminal 实战
微软 Surface RTX Spark Dev Box 实机演示:通过开源 Intelligent Terminal 离线运行 120B 参数本地模型,一句话自动构建可启动 Hyper-V 虚拟机,展示 Project Zemuth 设备的本地 AI 能力。

平权法案终结后,黑人新生入学率骤降与HBCU的崛起
最高法院终止种族敏感录取后,美国前50所最具选拔性大学黑人新生入学率下降27%,哈佛从18%降至11.5%,耶鲁从9.5%降至8%,更多黑人学生转向HBCU。

Claude全面加水印:付费用户也无法关闭,检测权限却只给少数人
Anthropic 将 Claude 隐形文本水印扩展至 Mythos 5、Opus 4.7 等模型,全球适用且付费用户无法退出。校对、翻译等轻量使用同样被标记,但检测权限仅开放给监管机构和企业,普通用户既无法自查也难以申诉。