开源模型逆袭闭源旗舰?GPT-5.6遭遇开源挑战

开源模型能力逼近闭源旗舰,但自评分数与硬件门槛仍存争议。
本文梳理了近期开源大模型的三条动态:Meta开源模型演示了从找bug到出片的项目级自动化,自评分数超越闭源旗舰但缺乏第三方复现;DeepSeek更新后3D生成能力突出,但分数跳升涉及基准更换,不宜直接对比;Beam主打长上下文,可一次读入整套代码,但本地部署硬件门槛高,普通开发者仅能体验轻量版本。文章指出,开源模型正从辅助工具转向项目级自动化,能力差距在缩小,但评价体系不透明、硬件门槛仍在,开发者应更关注实际可用性与可及配置。
最近,一场关于开源与闭源大模型能力对比的讨论在开发者社区中悄然升温。有UP主在B站发布视频,抛出了一个尖锐的问题:闭源旗舰GPT-5.6,怎么就在一个开源模型自己贴出的榜单上被挤到后面了?这期“GitHub开源项目分析”围绕三件事展开,分别是Meta的开源模型、DeepSeek的版本更新,以及Beam的长上下文路线。我们不妨从这些讨论中,看看开源模型到底走到了哪一步。
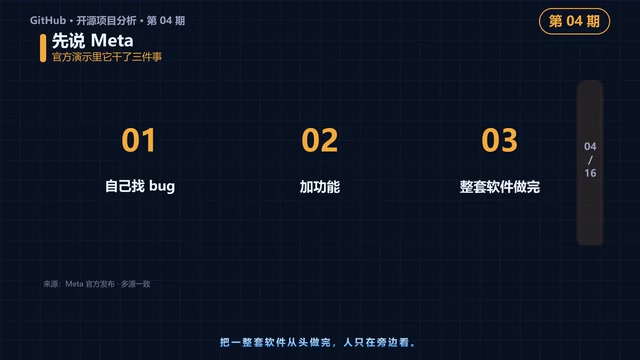
Meta开源模型:从“辅助”到“接管项目”
据视频介绍,Meta开源了一款名为“8161”的模型(具体型号名称以官方信息为准),官方的演示给人留下了深刻印象。演示中,这个模型能够自己找bug、加功能,把一整套软件从头做完,而人只是在一旁看着。更夸张的是,它还能接管剪辑软件,一帧帧看素材,自己挑镜头、裁剪,直接出片。这种“从需求到成品”的全流程自动化,已经超出了传统代码补全的范畴。
不过,视频也指出,这并非一个全新的模型,而是一次更新。它的对标对象是Opus和GPT-5.6这类闭源旗舰。在模型自己卡上的评测数据中,它以77.0的分数压过了这两位对手。但关键问题在于:这个分数是模型“自己贴的表”,目前没有第三方复现。这就像运动员自己计分,虽然不一定有假,但公信力总要打些折扣。
基准测试自评与第三方复现:在模型评测中,厂商自行发布的基准分数常被称为“自评”或“自报成绩”。由于测试集、提示词、采样参数等细节可能未完全公开,其他团队难以精确复现同一结果,因此自评分数的公信力有限。行业更认可的是第三方独立评测(如 LMSYS Chatbot Arena、Open LLM Leaderboard)或可复现的学术基准。文章提到的“模型自己贴的表”正是指这种缺乏外部验证的评测方式,其分数只能作为参考,不宜直接用于跨模型比较。
DeepSeek更新:分数涨了,但考卷也换了
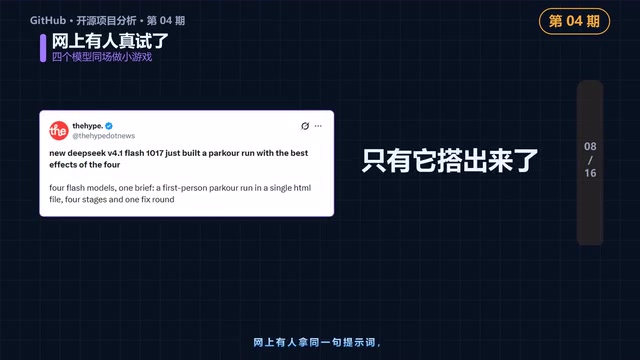
第二个重点是DeepSeek广告。视频提到,DeepSeek把V4.1 Flash跟到了2017版(此处指代版本,具体编号请以官方为准),并首发了Reflection功能。在另一个对比测试中,有人用相同的提示词让四个模型各做一个3D小游戏,结果只有DeepSeek成功做出了几千扇发光窗户的场景。官方案例则更具体,包括故宫3D建模和网页赛车游戏,都是从零件级别开始构建的。
但视频也提醒,分数不能全信。DeepSeek在某一项上的分数从31.2跳到了42.3,中间换过“考卷”,两场考试不能直接对比。这其实点出了当前模型评测的一个普遍困境:基准测试更新频繁,不同版本之间的分数差异,很难完全归因于模型能力的提升。对于普通开发者而言,参考价值有限,更需要关注模型在实际任务中的表现。
基准测试版本更迭与分数可比性:基准测试并非一成不变,随着题目泄露、模型过拟合或任务难度调整,测试集常会更新版本。当版本更换后,新旧分数之间不再具有直接可比性,因为“考卷”本身变了。文章提到的分数从31.2跳到42.3,若中间更换了测试集,则无法简单归因于模型能力提升。开发者在参考此类数据时,应确认测试版本是否一致,并优先关注同一版本下的横向对比或实际任务表现。
Beam路线:长上下文与本地部署的现实
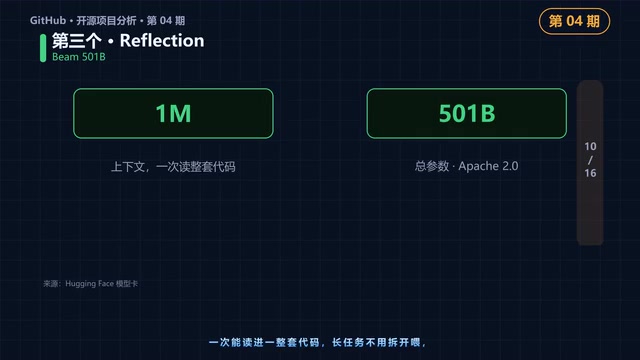
第三个值得关注的是Beam。视频称它走的是另一条路:一次能读进一整套代码,处理长任务不用拆开,也不需要反复交代背景。这对于需要理解大型代码库的场景来说,确实是一个实用的特性。但现实是,能进普通电脑的只有Nemotron Bolt(24GB显存),问答建议48GB起步。Meta 8x1G 60E、Beam 5010E、DeepSeek 7630E这些配置,都要求更高的硬件。Meta甚至需要两台顶配Mac Studio,每台512GB内存和1TB存储,另外两个也得多卡并行跑。
这意味着,虽然开源模型在能力上向闭源旗舰发起了挑战,但门槛依然存在。对于大多数个人开发者来说,能真正上手体验的只有Bolt这类相对轻量的模型;另外三个更像是给有机器、有项目的团队准备的。
长上下文与本地部署的显存约束:长上下文模型需要将大量token的键值缓存(KV Cache)保留在显存中,上下文越长,显存占用越大。因此,文章提到的“一次读进一整套代码”对硬件提出了更高要求。24GB显存仅能支撑较短上下文或经过量化的轻量模型;若要处理完整代码库,通常需要48GB甚至更多显存,或采用多卡并行与模型并行技术。这也是为何只有Nemotron Bolt这类相对轻量的模型能在普通电脑上运行,而更大配置需要顶配工作站或服务器。
开源与闭源:差距在缩小,但评价体系待完善
综合视频中的信息,这周的变化可以概括为:模型正从“方向性协议”行(此处可能指传统的API调用模式)变成“接一个项目自己做”。开源模型在自动化、长上下文等能力上确实在逼近闭源旗舰,但门槛还在,只是门开了一条缝。
补充一点,视频中的部分表述较为口语化,且涉及具体版本号和分数,读者在参考时应注意核实官方信息。另外,模型自己贴出的榜单数据缺乏第三方验证,在对比时应保持审慎。开源与闭源的竞争格局仍在快速演变,评价体系也需要更透明、更可复现的基准测试来支撑。
对于开发者而言,关注点或许可以放在:哪些能力是真正可用的,哪些配置是现实可及的。毕竟,再高的分数,如果跑不起来,也只是纸面数字。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。