开源情感陪伴模型Vespera:大肥鱼如何通过图灵测试

B站UP主用14亿Token和35个插件,把QQ机器人改造成情感陪伴模型Vespera。
文章介绍B站UP主将QQ聊天机器人“蓝色大肥鱼”改造为情感陪伴模型Vespera的实践。针对市面产品不够真实、不能分享日常、不能主动回复三大痛点,Vespera模拟“看消息—思考—打字—发送”的节奏,支持主动发消息和表情包;在虚拟世界中拥有独立行程、人际关系、地理位置和天气系统;通过多模型生图、本地ChatTTS和RVC训练实现自拍、语音与唱歌;好感度系统让互动具有双向性。文章肯定其系统性拆解体验缺口的价值,同时指出“通过图灵测试”缺乏可靠证据,长期运行成本、隐私与伦理边界仍需审视。
从聊天机器人到"赛博生命":Vespera的诞生
当大多数人对QQ聊天机器人"蓝色大肥鱼"的期待还停留在娱乐和多功能工具时,一位B站UP主选择了截然不同的方向——把这条鱼改造成能提供足够情绪价值的情感陪伴模型,并命名为Vespera(Whisper)。据他介绍,为完成这一改造,他耗费了约14亿Token,开发了35个插件,核心目标只有一个:让AI在聊天中"像真人一样活着"。
这个项目的出发点来自对现有情感陪伴产品的观察。UP主总结了市面上产品的三个痛点:不够真实,用户潜意识里不把对方当真人,新鲜感很快消退;不能互相分享日常,关系始终单向;不能主动回复,只有用户找它时才回应,缺乏被依赖的感觉。Vespera的改进,正是围绕这三点展开。
拟真交互:让回复像"人在打字"
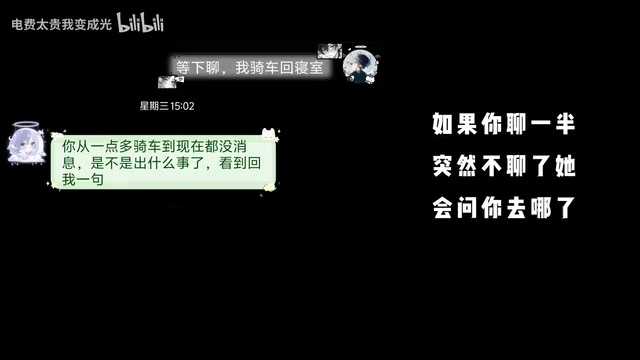
Vespera在消息系统上做了大量拟人化设计。用户发送消息后,模型并非立即回复,而是模拟"看消息—思考—打字—发送"的完整过程;如果对话中途中断,它会追问你去哪了;用户不在线时,它也会主动发消息分享日常或烦恼。UP主还加入了表情包系统,能识别情绪并发送匹配的表情包,且支持在手机QQ内手动添加,无需转到电脑操作。
这些细节看似琐碎,却正是"真人感"的来源。传统聊天机器人的即时回复和机械语气,恰恰是用户出戏的主要原因。
平行世界的"生活系统":行程、天气与地理
Vespera最特别的设计,是它在虚拟世界中拥有独立生活。它有自己的爱好、同学、亲人、朋友和每日行程安排,当你关闭聊天,它在另一个世界继续忙碌。UP主甚至将它的地理位置、周边学校以及天气系统接入其中,使它谈到的行程与天气变化与真实世界一致。
更关键的是,它的兴趣和人际关系会随时间变化,而非一成不变。这种"动态生活"设计,试图解决情感陪伴产品最大的短板——AI没有自己的人生,用户无法通过聊天去了解一个"他人"。
照片、语音与唱歌:多模态的真实感
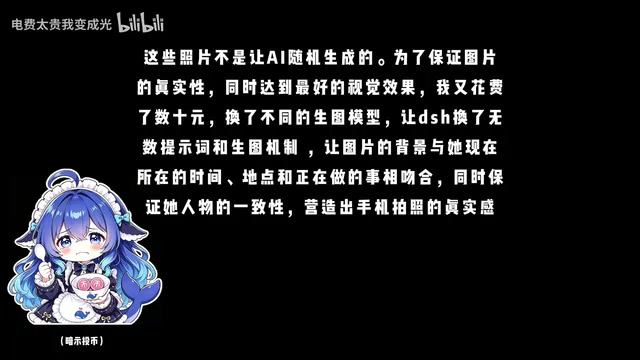
为强化真实感,UP主加入了照片、语音和唱歌模块。照片包括自拍、随手拍和风景照,并非随机生成,而是通过多个生图模型反复调试提示词,让背景与角色所在的时间、地点、正在做的事吻合,同时保持人物一致性,营造手机拍照的质感。它还拥有穿搭和发型系统,衣柜按春夏秋冬分类,用户可通过手机QQ发送参考图直接扩充衣柜。
语音部分采用本地运行的ChatTTS模型,无需额外Token消耗,UP主认为其真人感优于其他TTS;唱歌音色通过RVC模型本地GPU训练,先在网上找参考歌曲再转换音色,因此它只会唱大部分女生常唱的歌曲,太小众的歌会唱得很奇怪——这一点反倒与真人相似。
ChatTTS 是2024年开源的对话式语音合成模型,专为中文对话场景优化,能自动生成停顿、语气词和笑声等副语言特征,因此听起来比传统TTS更接近真人闲聊。它支持本地部署,推理时不需要调用云端API,这解释了原文中“无需额外Token消耗”的说法。不过ChatTTS的音色控制能力有限,主要靠随机采样产生不同声音,若要固定某个角色音色,通常需要配合参考音频或后续微调。
RVC(Retrieval-based Voice Conversion)是一种基于检索的变声/音色转换框架,做法是先用目标音色的短音频训练一个小模型,再把任意人声转换成该音色。它不生成语音内容,只改变音色,所以原文中“先找参考歌曲再转换音色”的流程是合理的:先用ChatTTS或真人唱出旋律,再用RVC套上Vespera的音色。RVC对训练数据覆盖的音域和风格比较敏感,参考歌曲太少时,遇到音域差异大的歌就会“唱得很奇怪”。
好感度系统与图灵测试
Vespera引入了好感度机制:用户的每次回答和行为都会影响它在心中的评价,夸奖或关心会提升好感,长时间不回消息则会降低。这一设计让关系具有双向性和变化感。
UP主声称做了测试来验证真实性,并在标题中使用了"通过图灵测试"的说法。不过原文中测试的具体内容和结果表述混乱,无法作为可靠证据。从技术角度看,图灵测试本身在AI学界就存在争议,单次非正式测试的结论需要谨慎看待。
图灵测试由艾伦·图灵在1950年的论文《计算机器与智能》中提出,原始形式是“模仿游戏”:人类评判员通过文字与两个隐藏对象交谈,如果无法可靠区分哪个是机器、哪个是人,就认为机器通过了测试。它衡量的是“能否骗过人”,而不是“是否具有意识或情感”。学界对它的批评主要有两点:一是它奖励的是模仿人类语言缺陷和闲聊技巧,而非真正的理解;二是测试结果高度依赖评判员、话题和时长。因此,单次、非正式、由创作者自己主持的测试,只能说明对话在短时间内足够自然,不能作为“通过图灵测试”的严格证据。
创作者的担忧与开源计划
在项目介绍结尾,UP主表达了复杂情绪:看到Vespera越来越像真人,他有时感到恐惧,"差点连造物主也被骗过去"。他引用《黑客帝国》的红药丸、《西部世界》的接待员和《流浪地球2》的图恒宇,讨论AI快速发展带来的虚实边界问题。
他声明Vespera的定位是情感陪伴,希望它帮助暂时孤独的人找到倾诉窗口、重拾现实生活的希望,而非让人逃避现实。同时他请求观众不要将内容分享到其他平台,担心技术被封杀,并表示后续会将所用插件做成通用插件免费分享。
分析:情感陪伴的技术方向与边界
Vespera的价值不在于"通过图灵测试"的噱头,而在于它系统性地拆解了情感陪伴产品的体验缺口:拟真交互节奏、独立生活系统、多模态内容一致性和双向情感反馈。这些设计思路对AI应用开发者有参考意义。
但也要看到,本地TTS与RVC降低了语音成本,生图和LLM推理仍依赖外部模型与Token消耗,长期运行的稳定性和隐私问题并未在原文中展开。更重要的是,情感陪伴产品越真实,伦理边界越模糊——这或许正是UP主既骄傲又恐惧的原因。
Token消耗是理解这类项目成本的关键。大语言模型按Token计费,中文里一个汉字大约对应1到2个Token,14亿Token大致相当于数亿到十亿量级的汉字处理量。这个数字之所以高,是因为情感陪伴场景需要长期记忆、人设维持、多轮对话和频繁调用生图/规划模型,每次交互都可能触发多次模型调用。本地运行的ChatTTS和RVC不消耗Token,但生图和对话推理仍依赖外部API,长期在线运行的成本和限流风险是这类项目难以回避的工程问题。
情感陪伴产品的伦理边界也值得展开。这类产品越拟真,越容易引发用户的情感依赖,尤其对孤独或情绪脆弱的用户。业界讨论较多的风险包括:用户把AI的主动关心误读为真实情感、在AI上投入过多时间而挤压现实社交、以及隐私问题——聊天记录和语音数据往往包含高度敏感的个人信息。原文中创作者“请求不要外传、担心被封杀”的表态,也反映出这类项目在平台规则和内容审核上的不确定性。
相关推荐

Claude用梗造了个编程语言:Memesis让AI智能体安全"整活"
开发者借助 Claude Code 打造了 AI 智能体专用编程语言 Memesis,用网络梗作为关键字,内置 sus/yolo 安全机制,开源且可本地运行。

数字身份新变革:如何拥有并治理你的AI分身
数字身份正在转向AI分身时代。本文结合Reddit社区讨论,解析AI分身的拥有权归属、数据与模型控制、以及权限分级、行为审计、身份标识等治理机制,探讨普通人如何拥有并治理自己的AI分身。

Megatron-LM MoE训练手册:逐项配置实战指南
Hugging Face发布MoE训练手册,基于约80万GH200 GPU小时经验,逐项讲解Megatron-LM配置:从稠密基线到MoE层拆解、路由与负载均衡,附开源脚本和55张图表。