开源生图模型MOSS-Image本地部署评测:二次元与速度实测

MOSS-Image本地部署快、人物与文字审美佳,但缺编辑能力难替代成熟模型。
MOSS-Image 是一款新开源的文生图模型,可通过 ComfyUI 整合包本地部署,搭配 8 步加速 Lora 后采样约 30 秒,双模型同时出图整轮约一分钟。与通义千问 Image 2.1 对比,MOSS-Image 在人物柔和美感、文字排版审美上更优,且为无审查模型,创作自由度更高;但真实材质、细节表现和角色训练充分度不及千文 Image 2.1,且完全缺失图片编辑能力(图生图、局部重绘、扩图),因此只能作为工作流中的第二出图引擎,无法替代全能型模型。适合二次元、生活写真、电商文字排版等场景。
开源文生图赛道最近又多了一个值得关注的选手——MOSS-Image。B站UP主在最新视频中完整演示了这款模型的本地部署流程、加速Lora搭配方案,以及与通义千问Image 2.1(下称千文Image 2.1)的横向出图对比。结论先摆在这里:MOSS-Image在人物美感和文字排版审美上表现抢眼,速度也不算慢,但它缺一个关键能力——图片编辑,这决定了它暂时还无法完全替代成熟模型的工作流位置。
部署门槛并不高:ComfyUI拖入工作流即可跑通
UP主给出的整合包思路很直接:模型下载后按目录对应放入ComfyUI根目录下的Models文件夹,打开ComfyUI把工作流拖进界面,重新选择模型路径就能出图。工作流被拆成两个区块——MOSS-Image出图模块和千文Image 2.1对比模块,日常使用时关掉不需要的一侧,避免显存浪费。
模型选择上,UP主用的是MOSS-Image的SFT版本。这个版本基于Base版本微调而来,在多数场景下表现强于Base。加速Lora方面搭配的是8步加速Lora,由社区作者Cook优化,对出图逻辑和画面美化都有正向作用;千文Image 2.1那一侧则使用6步加速Lora。参数层面只需要在提示词区块输入内容、调整比例和分辨率即可开跑,没有复杂的节点改造。
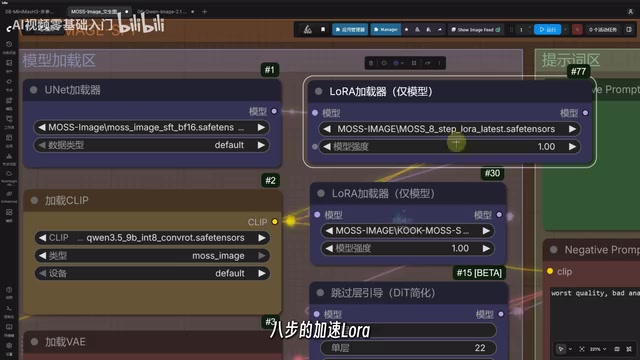
对熟悉ComfyUI的用户来说,这套流程几乎零学习成本;对新手而言,整合包把模型放置路径和工作流都提前配好了,门槛主要卡在显存和模型文件体积上。
ComfyUI 是一个基于节点的图形化界面,用于构建和运行 Stable Diffusion 等生成式 AI 模型的工作流。用户通过拖拽节点(如加载模型、编码提示词、采样、解码图像)并连接它们来定义生成过程,而非编写代码。其优势在于高度可定制、可视化强,并支持保存和分享工作流(通常为 .json 文件)。社区常发布整合包,包含预设工作流和模型路径,降低新手门槛。ComfyUI 对显存有一定要求,但优化良好,适合本地部署。
加速 Lora(Low-Rank Adaptation)是一种轻量级微调技术,通过低秩分解注入可训练参数,大幅减少训练成本。在文生图领域,加速 Lora 特指经过蒸馏或专门训练的适配器,用于减少采样步数(如从 20-50 步压缩到 4-8 步),从而显著提升出图速度,同时尽量保持画质。这类 Lora 通常由社区作者训练并分享,需与基础模型配合使用。8 步加速 Lora 意味着模型能在 8 步采样内生成可用图像,相比标准步数提速数倍,适合本地快速出图场景。
速度实测:双模型同时出图约一分钟
速度是这次测试里比较有说服力的数据。两个模块同时开启出图,整轮耗时稳定在80多秒到92秒之间,也就是一分钟左右。拆开看采样时间更清楚:千文Image 2.1采样完成约43秒,MOSS-Image采样完成约30多秒。
这个成绩建立在双方都挂载加速Lora的前提下。8步和6步的步数压缩让采样阶段大幅缩短,实际体验接近"输入提示词后等一杯咖啡"的节奏。需要说明的是,这是本地消费级显卡环境下的表现,不同硬件配置会有浮动,但相对关系——MOSS-Image采样略快于千文Image 2.1——具备参考价值。
画质横评:柔和审美 vs 细节质感
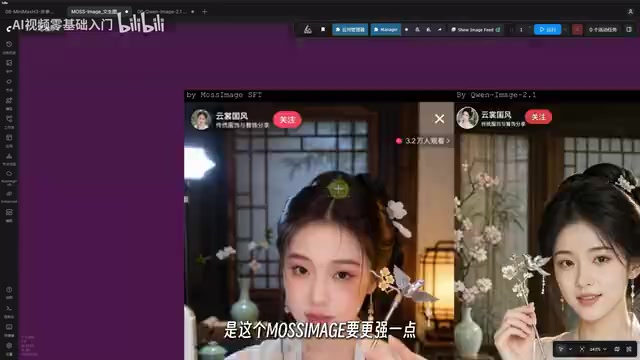
第一组人物对比就能看出两个模型的性格差异。MOSS-Image出图更柔和,画面有轻微的柔化倾向;千文Image 2.1细节更多,真实感和质感更扎实。UP主的判断是:MOSS-Image更适合生活写真、温柔甜美风格的人像;千文Image 2.1在真实摄影和材质表现上更占优。
电商详情页场景里,两款模型对小字的处理都没有出现明显错误,但MOSS-Image的文字排版审美更好。有意思的是语义理解上翻了车——千文Image 2.1把"电极帽"理解成了球,画出了一个球体,这类提示词遵循度的偏差在商品图场景里代价不小。
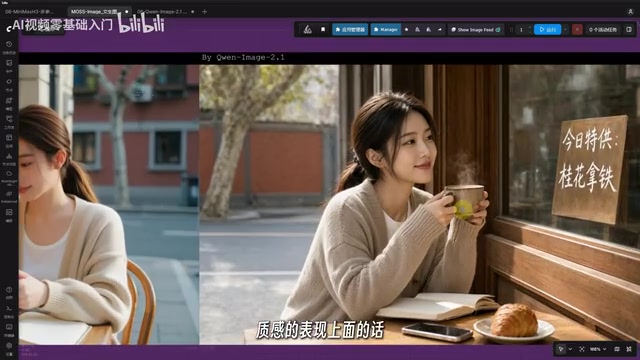
直播间场景的对比更微妙。MOSS-Image生成的画面更自然、AI感更弱、人物更真实;千文Image 2.1的人脸颜值更高、更讨喜,但小字出现了崩坏。UP主的总结是:文字处理方面两边都强,但综合来看MOSS-Image略胜一筹,尤其是排版搭配的协调感。
动漫角色与场景细节:各有取舍
游戏和动漫角色的测试揭示了两款模型的训练数据侧重。两者对热门游戏、动漫角色都有认知,但千文Image 2.1对《老头环》(艾尔登法环)等作品的角色训练更充分,生成的菈妮形象更贴近原作。
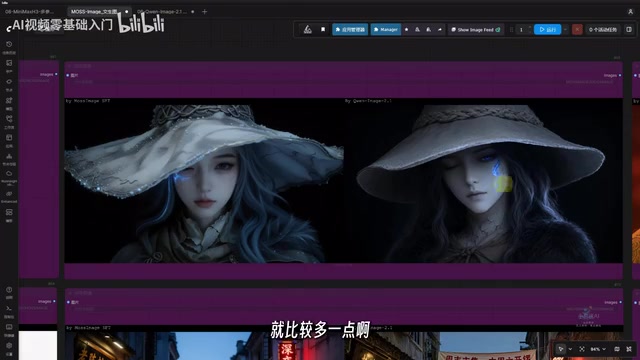
画面风格上延续了前面的规律:千文Image 2.1喜欢往图里塞细节,信息密度高;MOSS-Image走简约路线,画面更干净、看着更舒服。在1K分辨率下,千文Image 2.1小字出错的概率比MOSS-Image高一些。场景对比里千文Image 2.1的质感优势很明显,而MOSS-Image在细节要求高的场景会显得"简陋"。
值得一提的是,MOSS-Image属于无审查模型,提示词约束宽松,这在创作自由度上是加分项,但也意味着使用边界需要用户自己把握。
短板与结论:编辑能力缺失是硬伤
MOSS-Image最致命的问题是没有图片编辑能力。这意味着它无法承担图生图修改、局部重绘、扩图这类任务,在完整工作流里只能充当"从零出图"的一环,替代不了千文Image 2.1的全能定位。UP主对此的态度是开放性的:后续开源社区可能会补上这块能力。
综合来看,MOSS-Image的定位很清晰——出图速度够快、人物美感和文字排版审美在线、无审查带来创作自由度,适合二次元、生活写真、电商文字排版类需求;但真实材质、高细节场景和图像编辑任务,仍然要交给千文Image 2.1这类更成熟的模型。对本地部署玩家来说,把它作为ComfyUI工作流里的第二出图引擎,是个性价比不错的补充方案。
图片编辑能力通常指图生图(Image-to-Image)、局部重绘(Inpainting)、扩图(Outpainting)等任务。图生图以输入图像为起点,结合提示词进行修改;局部重绘允许用户指定区域重新生成;扩图则扩展画布并智能填充。这些能力依赖模型对图像上下文的理解和编辑专用训练。缺少这些功能,模型只能从零生成,无法融入需要迭代修改的工作流(如电商修图、设计迭代)。因此,编辑能力是评估文生图模型实用性的关键指标之一。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。