Kun开源Agent:为DeepSeek深度优化的国产AI编程助手

国内开发者想用AI编程工具,长期面临三重门槛:网络访问不便、第三方模型接入配置复杂、Token成本高企。最近一个在GitHub上接近5000星的开源项目「Kun」(坤)进入视野,它专为国内用户和DeepSeek模型做了深度优化,试图一次性解决这些痛点。本文结合B站UP主的实测演示,拆解这个项目背后的工程化设计思路。
为什么国内需要本土化的AI编程Agent
AI编程Agent是近年来兴起的一类自主编程工具,其核心能力不仅限于代码补全,而是能够理解任务目标、自主规划执行步骤、读取和修改本地文件、调用外部工具,最终完成端到端的开发任务。代表性产品包括GitHub Copilot Workspace、Cursor、Devin等。
与传统代码补全工具相比,Agent模式的关键突破在于多步骤推理和工具调用能力。这依赖于两项关键技术的成熟:其一是Function Calling接口,允许模型以结构化JSON格式输出「工具调用请求」,由外部运行时执行后将结果返回模型,形成「感知-决策-执行」的闭环——这一接口由OpenAI在2023年随GPT-4率先标准化,本质上是将「可调用函数」的JSON Schema嵌入模型的输出空间,使模型的决策能力得以与任意外部系统对接;其二是ReAct(Reasoning + Acting)架构,由Google Research于2022年提出,将推理和行动交替进行——模型每一步先输出思考过程(Thought),再决定下一个行动(Action),观察执行结果(Observation)后进入下一轮循环。这种链式推理不仅显著提升了复杂任务的成功率,更形成了可审计的推理轨迹,让开发者在调试时能够追溯每一步决策的依据。然而,Agent模式也带来了新挑战:每次任务执行需要将大量上下文(项目代码、对话历史)送入模型,Token消耗呈指数级增长,这使得成本控制成为工程化设计的核心命题。
过去使用主流AI编程工具,国内用户往往在第一步就被劝退——网络门槛直接挡住大多数人。即便有人为了省钱在国内接入第三方模型,也难逃各种代理转换工具的复杂配置,光是把环境跑通就足以让人血压飙升。
Kun的出发点正是针对这些真实痛点。它对DeepSeek广告做了深度适配,让国内用户能以相对低廉的成本、相对顺畅的网络环境,获得一个本地待命的AI编程助手。DeepSeek是深度求索公司推出的大语言模型系列,其R1和V3版本在技术路线上各有创新:R1采用纯强化学习路线,通过GRPO(Group Relative Policy Optimization)算法仅用数学和编程题的结果信号作为奖励,无需监督微调即涌现出类似「思维链」的强大推理能力,证明了复杂推理能力可以完全从强化学习中自发习得;V3则通过混合专家架构(MoE)在参数效率上取得突破——其拥有约6710亿总参数,但每次推理仅激活约370亿,实际计算量远低于同等规模的稠密模型,这是其低成本运营的根本原因。两者在HumanEval、MBPP等编程基准测试中达到或超越GPT-4级别,而API价格约为OpenAI同等模型的1/20至1/30——这一价格差异在高Token消耗的Agent场景中被进一步放大。更重要的是,DeepSeek提供了完整的国内可访问API端点,免去了代理和中转的需求。项目名字和UI设计带有明显的国内网络文化色彩——连AI助手都以「鸡哥」的形象出现,这种接地气的设计拉近了用户的心理距离。
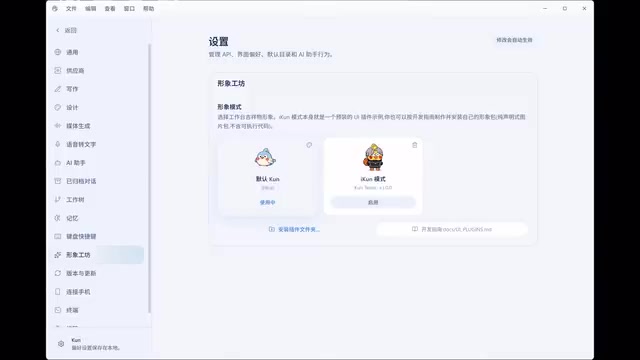
抛开娱乐化的外壳,Kun真正值得关注的是它背后的工程化思维,这才是区别于普通Agent工具的核心所在。
需求草稿:让AI先想清楚再动手
需求管理不清是软件项目失败的首要原因,这一结论在软件工程领域有大量实证支撑。Standish Group的CHAOS报告长期追踪显示,需求不明确和需求变更是项目延期、超支甚至失败的最主要根源,占比通常超过40%。在AI编程场景中,这一问题被进一步放大——模糊指令不仅导致方向偏差,还会触发多轮纠错对话,每一轮都意味着额外的Token消耗和等待时间。
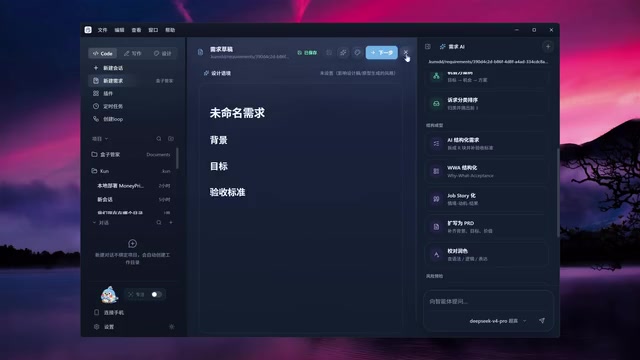
很多Agent工具有一个通病——拿到一句话指令就开始盲目写代码,结果方向跑偏、反复返工,既浪费Token又浪费时间。Kun提供的「需求草稿」功能正是为了解决这个问题。
在真正开始编码之前,Kun会引导用户先把背景、目标和验收标准规划清楚。界面右侧内置了AI辅助的结构化需求整理能力,帮助用户把模糊的想法转化为清晰的开发规格。这一设计借鉴了敏捷开发中的「用户故事」和「验收标准」概念,以及产品设计中的PRD(产品需求文档)结构,将「背景-目标-验收标准」三要素前置,本质上是将软件工程的最佳实践内嵌进AI交互流程。这个前置环节看似增加了步骤,实际上带来双重收益:一方面减少无效的Token消耗,另一方面大幅降低后期返工和验收的时间成本。
这种「谋定而后动」的设计,体现了开发者对真实开发流程的深刻理解——需求不清是软件项目失败的首要原因,把这一步做扎实,后面的自动化才有真正的价值。
内联代码对比:AI改动一目了然
需求理清后,Kun会直接进入本地项目,自主翻阅源码进行分析和修改。这里最直观的亮点是它的内联代码对比(Diff)功能。
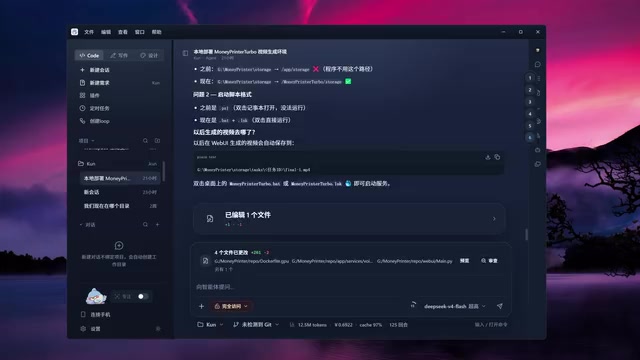
Diff(差异对比)是版本控制系统的核心概念,源于Unix工具diff命令,后被Git等现代版本控制系统广泛采用。在AI编程场景中,内联Diff展示具有特殊的工程价值:AI修改代码时可能同时涉及数十个文件、数百行变更,若没有结构化的差异呈现,人工审查几乎不可能高效完成。这不仅是用户体验问题,更是安全和质量控制的底线——开发者必须能在批准前快速理解AI「做了什么」,防止AI引入难以察觉的逻辑错误或安全漏洞。研究表明,代码审查效率与差异可视化质量高度相关,清晰的Diff展示可将审查时间缩短50%以上。
AI改动了哪几个文件、哪一行新增、哪一行删除,都用红绿标记清晰标注,类似GitHub Pull Request的Changes标签页。用户不需要在多个文件间来回切换比对,只需扫一眼diff、点击批准,代码就自动合并到项目中。这种设计把「Review AI代码」的成本降到最低,也让用户始终掌握控制权,而不是把项目完全交给黑盒。
成本控制:缓存命中率才是关键
让AI大批量读取本地文件,很多人第一反应是——Token消耗会不会失控?理解这个问题需要先了解大语言模型的计费逻辑:在多轮Agent对话中,每次调用模型都需要将完整的对话历史和项目上下文重新发送,产生大量重复计费的「前缀Token」。
**上下文缓存(Context Caching)**技术的底层实现依赖于KV Cache(键值缓存)机制。Transformer模型在处理每个Token时会生成对应的Key和Value向量,这些向量在注意力计算中记录了该Token对整个上下文的「理解状态」。当多次API调用的Prompt前缀完全相同时,服务端可以直接复用已计算并缓存的K/V向量,跳过这部分的重复计算——这正是vLLM、TensorRT-LLM等主流推理框架的核心优化之一。DeepSeek、Anthropic(以「Prompt Caching」命名)等服务商将这一优化暴露为计费层面的「缓存命中」折扣——DeepSeek对缓存命中部分收取约1/10的标准价格,甚至在某些套餐下完全免费。要最大化缓存命中率,Prompt的结构设计至关重要:必须确保高频复用内容(系统提示、代码文件)在Prompt中的位置稳定不变,其哈希值保持一致,而动态内容(用户新指令)始终追加在末尾。
这正是Kun对DeepSeek深度优化所带来的核心价值。Kun通过精心设计的调用策略,将稳定不变的内容(系统提示、文件内容)置于Prompt前缀,将动态变化的对话内容置于末尾,最大化缓存复用率。
据UP主实测数据,单次会话跑了125个回合、消耗1250万Token,但由于缓存命中率高达97%,最终只花了6毛9。这个数字相当惊人。项目还提供全局使用统计面板:累计运行1.1亿Token,因为维持了98%的缓存命中率,总费用仅5块多。
面板下方还有一个类似GitHub贡献图的活跃度热力图,把「省了多少Token、花了多少钱」全部可视化呈现。对于成本敏感的国内开发者来说,这种透明的成本追踪能力,比单纯宣称「便宜」更有说服力。
手机远程监控:赛博包工头模式
手机远程监控功能背后折射出AI编程工具演进的一个重要趋势:从「同步交互」走向「异步监督」。早期的AI编程工具需要用户持续在场等待每一步输出,这与长时间运行的复杂开发任务存在根本矛盾。随着Agent任务复杂度提升,单次任务执行时间从秒级延伸到分钟甚至小时级,持续在场等待变得不现实。LangGraph的持久化工作流、Anthropic的Claude Projects等现代异步Agent框架开始将任务状态持久化到外部存储,支持中断、恢复和跨设备续接。异步工作流的设计理念将人的角色从「操作者」转变为「审批者」——AI持续施工,人在关键节点介入决策,类似现代企业中「授权而非微观管理」的最优实践。
技术实现上,这套系统需要解决三个核心问题:任务状态持久化、实时进度推送和跨设备会话同步。Kun的方案是在服务端维护状态机(记录当前执行步骤、等待输入等状态),通过WebSocket长连接向客户端推送增量进度,并在需要人工确认时触发移动端推送通知。二维码扫描关联机制本质上是将桌面端的会话Token绑定到移动端,实现同一任务上下文在不同设备间的实时镜像,针对代码审批场景做了轻量化裁剪。
Kun的手机远程监控功能正是这一理念的具体落地。遇到复杂的开发任务,可以让电脑在工位上持续运行,自己扫码后躺在沙发上用手机查看进度;当AI提交代码时,在手机上点一下确认即可直接执行。
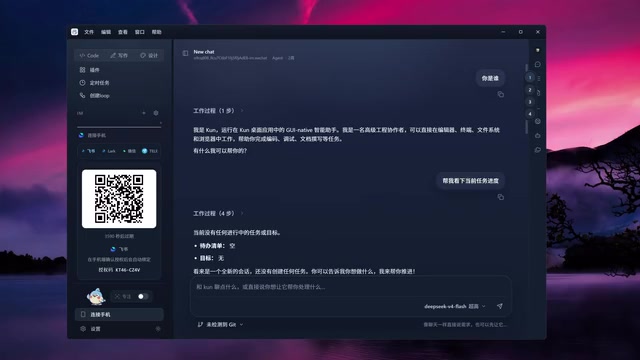
UP主戏称这是「真正的赛博包工头」——你负责决策和审批,AI负责具体施工。这种异步、远程的工作模式,对需要长时间运行的自动化任务确实实用,也预示着AI编程助手正在从「工具」向「协作者」的角色转变。
此外,即便完全不懂编程,Kun也内置了「Write写作模式」,可分析资料并生成电商选品报告、排版短视频口播脚本等内容。所有数据均在本地处理,速度快、隐私有保障。
总结:国产AI编程助手值得一试吗
Kun完全免费开源,支持macOS、Windows和Linux三大平台,各平台安装包均已打包提供。从实测演示来看,它的核心竞争力在于:针对DeepSeek和国内使用场景做了扎实的本土化优化,并在需求管理、代码审查、成本可视化等工程化环节上有清晰的产品思路。
需要提醒的是,本文数据主要来自单一UP主的演示,缓存命中率、实际成本等指标可能因项目类型和使用方式有所不同,建议感兴趣的用户亲自下载体验后再做判断。对于希望拥有一个24小时本地待命、成本可控的国产AI编程助手的开发者来说,Kun值得认真了解。
核心要点
相关推荐

Meta重返开源:30B模型Muse Glimmer单张24G显卡可跑
Meta重返开源,推出30B参数的开放权重模型Muse Glimmer,单张24GB显卡即可运行,采用Apache 2.0许可证,支持多模态与推测解码加速。海外博主实测其编程、建模与前端设计能力,带你了解这款亲民本地大模型的真实表现。

AI+SRC自动化挖洞实战:用AI智能体重构漏洞挖掘三步法
本文详解AI+SRC自动化漏洞挖掘的完整思路,对比传统挖洞三步法与AI智能体加持后的变化,涵盖资产盘点、误报筛选、报告生成及AI Agent选型要点,助你高效入门SRC漏洞挖掘。

实测DeepSeek桌面Agent:0.35美元自动生成视频
海外博主实测DeepSeek桌面Agent(DeepSeek Harness):仅0.35美元自动生成完整视频,设置每日自动简报,两分钟从大白话构建可运行App。三项任务全部完成仅花0.59美元,附详细表现与成本分析。