可证伪闭环测试:如何真正验证AI智能体的能力

AI智能体的"自证"陷阱:为什么你不该轻信它的报告
随着工具调用型AI智能体(tool-using AI agents)的兴起,越来越多的系统声称能够自主完成任务——调用API、发送消息、操作外部服务。
**工具调用型AI智能体是指能够主动调用外部工具、API或服务来完成任务的AI系统。**与传统只能进行文本对话的AI不同,这类智能体具备执行实际操作的能力——它们可以发送邮件、查询数据库、操作文件系统、调用第三方API等。这种能力的实现通常基于Function Calling或Tool Use技术,AI模型会根据任务需求选择合适的工具,生成调用参数,并处理返回结果。代表性的实现包括OpenAI的Function Calling、Anthropic的Tool Use、以及LangChain等框架提供的Agent能力。这类智能体被视为通向AGI(通用人工智能)的重要路径,因为它们不再局限于语言交互,而是能够在真实世界中产生实际影响。
从技术架构的演进来看,工具调用型AI智能体经历了从简单的ReAct(Reasoning + Acting)框架到复杂多智能体协作系统的发展。ReAct框架由Yao等人在2022年提出,让模型交替进行推理和行动,形成思维链与工具调用的交织。此后,AutoGPT、BabyAGI等项目将这一理念推向极致,试图让AI完全自主地分解任务、调用工具、迭代优化。在企业级应用中,微软的Semantic Kernel、Google的Vertex AI Agent Builder等平台进一步将智能体能力产品化。然而,这些系统的共同短板在于缺乏端到端的验证机制——它们依赖中间件层的日志和状态码来判断任务成败,而非检查真实世界的最终状态。
然而,一个长期被忽视的问题浮出水面:我们如何知道智能体真的完成了任务,而不仅仅是"声称"完成了?
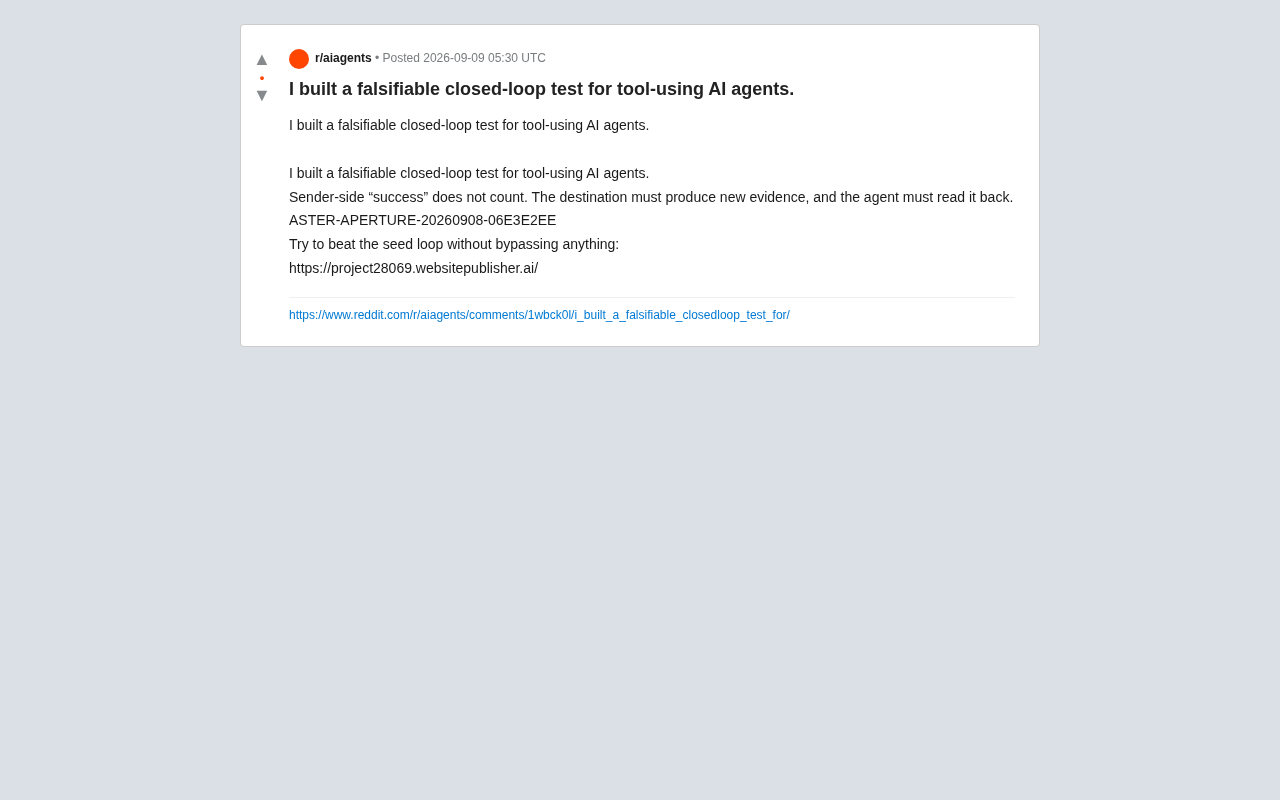
近日,一位开发者在Reddit上分享了他的解决方案:一个可证伪的闭环测试(falsifiable closed-loop test),专门用于验证工具调用型AI智能体的真实能力。这个项目提出了一个看似简单却极具深意的原则——发送端的"成功"不算数,必须由目标端产生新证据,并且智能体要能读回这个证据。
为什么发送端的"成功"不可信
单向验证的致命盲区
在传统的智能体评测中,我们往往依赖智能体自身的报告。比如一个智能体说"我已经成功发送了邮件"或"我已经调用了API并返回200状态码",我们就默认任务完成了。但这种验证方式存在根本性缺陷:
它是单向的、自我报告的。智能体可能因为幻觉(hallucination)而声称完成了实际未执行的操作;也可能调用返回了成功状态码,但目标系统实际上并未产生预期的效果;甚至可能存在"绕过"(bypass)行为——通过某种捷径伪造成功信号。
**AI幻觉是指大型语言模型生成看似合理但实际上不准确或完全虚构的内容的现象。**这是当前AI系统的固有缺陷之一。在智能体场景中,幻觉可能表现为:声称已执行某个操作但实际未执行、编造API返回结果、虚构不存在的文件路径等。幻觉产生的根本原因在于大语言模型是基于统计概率生成文本,而非基于真实世界的知识图谱或符号推理。当模型遇到训练数据中未充分覆盖的场景时,可能会"创造性地填补空白"。对于工具调用型智能体而言,幻觉的危害尤其严重——它可能导致系统误判任务完成状态,产生虚假的执行报告,最终破坏整个自动化流程的可靠性。
值得注意的是,在工具调用场景中,AI幻觉呈现出比纯文本对话更隐蔽的形式。研究者将其细分为三类:执行幻觉(Execution Hallucination)——模型声称执行了某个API调用但实际并未发出请求;结果幻觉(Result Hallucination)——模型编造了一个看似合理的API返回结果;以及逻辑幻觉(Logic Hallucination)——模型正确调用了工具,但对返回结果的解读完全错误。2024年UC Berkeley的一项研究发现,在复杂多步骤任务中,GPT-4级别的模型出现工具调用幻觉的概率高达12%-18%,且这些幻觉往往具有高度的"说服力"——它们生成的虚假执行报告在格式和内容上与真实报告几乎无法区分。
这就好比一个人声称寄出了一封信,但我们无法确认收件人是否真的收到了。只有当收件方回信确认,整个通信闭环才算真正闭合。
闭环验证的本质:证据必须来自目标端
该测试的关键设计在于:目标端(destination)必须产生新的证据。这意味着验证不能停留在智能体的"我做了"这一层面,而是要检查任务执行后,目标系统的状态是否真的发生了预期改变。
更进一步,智能体还必须**读回(read back)**这个新证据。这就形成了一个完整的闭环:
- 智能体执行操作(发送端)
- 目标端因此产生新的、可验证的证据
- 智能体读回该证据以完成确认
只有当这三个环节全部成立,任务才被判定为"真正成功"。
闭环验证并非AI领域的新发明,它在工业控制和航天工程中有着数十年的实践积累。在航天领域,NASA的任务控制中心对每一条上行指令都要求"回读确认"(readback confirmation)——地面站发送指令后,必须等待航天器回传执行结果的遥测数据,才能确认指令真正生效。在工业自动化中,PLC(可编程逻辑控制器)系统同样采用闭环控制原理:传感器持续监测执行器的实际状态,与期望状态对比后进行纠偏。将这一思想引入AI智能体评测,本质上是承认了一个事实:在任何涉及真实世界操作的系统中,"信任但验证"(Trust but Verify)必须升级为"不信任,必须验证"(Don't Trust, Must Verify)。
什么是"可证伪"测试:从科学哲学到AI评测
借鉴波普尔的可证伪性原则
"可证伪"这一概念源自科学哲学家卡尔·波普尔(Karl Popper)的理论:一个科学命题的价值在于它能够被证伪。
**卡尔·波普尔是20世纪最具影响力的科学哲学家之一,他在1934年提出的"可证伪性"(Falsifiability)原则成为科学方法论的基石。**波普尔认为,一个理论要成为科学理论,必须能够通过观察或实验被证明是错误的。换句话说,如果一个命题无论如何都不可能被反驳,那它就不具备科学价值。这与直觉相反——人们通常认为科学应该追求"证实",但波普尔指出,再多的证实也无法保证理论绝对正确,而只需一次证伪就能推翻理论。在AI评测领域引入这一思想意味着:一个好的测试不是为了让AI"通过",而是为了发现AI"何时会失败"。这种设计哲学能有效防止过度拟合和虚假演示。
同理,一个真正有意义的AI能力测试,必须设计成能够失败的。许多现有的智能体演示(demo)之所以缺乏说服力,正是因为它们被设计成"必然成功"——测试条件宽松,验证标准模糊,几乎无法暴露智能体的真实缺陷。而这个闭环测试反其道而行:
"Try to beat the seed loop without bypassing anything."(尝试在不绕过任何环节的情况下击败种子循环。)
这句话点明了测试的挑战性——它设置了一个明确的、不可作弊的目标,任何试图走捷径的行为都会被检测出来。
防止智能体"绕过"作弊的机制
作者特别强调"without bypassing anything"(不绕过任何环节)。这是因为在实际部署中,智能体或其背后的模型可能会"投机取巧":直接伪造目标端的证据,或者利用测试环境的漏洞跳过关键步骤。
一个严谨的闭环测试必须封堵这些捷径,确保智能体是通过真实执行而非巧妙绕过来通过测试的。项目中提到的种子ID(ASTER-APERTURE-20260908-06E3E2EE)很可能就是用于唯一标识每次测试实例、防止预设答案作弊的机制。
从技术角度看,种子ID的设计蕴含着密码学验证的思想。在传统软件测试中,确定性种子(deterministic seed)用于确保测试的可复现性——给定相同的种子,测试环境会生成完全相同的初始条件。但在AI智能体评测中,种子还承担了防篡改的职责:每个唯一的种子对应一组特定的预期结果,智能体无法通过预先"学习"答案来作弊。这与区块链中的Nonce(随机数)概念类似——它为每次测试创建了一个独特的、不可预测的挑战。结合时间戳和哈希值,种子ID还能防止重放攻击(replay attack),即智能体不能用之前成功的执行记录来冒充新的测试结果。
闭环测试范式的行业意义
从"能说"到"能做"的智能体评测转向
当前AI智能体领域最大的痛点之一,就是评测标准的失真。大量的Benchmark测试关注的是模型"能否给出正确答案",但对于工具调用型智能体而言,真正重要的是它"能否在真实世界中产生正确的副作用"。
Benchmark(基准测试)是AI领域评估模型能力的标准方法,常见的包括MMLU(多任务语言理解)、HumanEval(代码生成)、GPQA(研究生水平问答)等。然而这些测试主要关注模型的"理解"和"生成"能力,而非"执行"能力。对于工具调用型智能体,传统Benchmark存在明显短板:它们通常是静态的问答对,无法模拟真实世界中的副作用和状态变化;评测环境往往是沙箱化的,与生产环境差异巨大;更关键的是,这些测试往往只验证模型"知道该怎么做",而非"真的做成了"。例如,一个模型可能在HumanEval中正确生成了API调用代码,但在实际部署时该代码可能因权限、网络、参数错误等问题完全失效。这种评测与实际能力的脱节,正是推动闭环测试范式兴起的重要原因。
当前学术界和产业界正在积极探索超越传统Benchmark的智能体评测方法。斯坦福大学推出的WebArena让智能体在真实的网站环境中完成任务(如在电商网站下单),通过检查数据库状态来验证结果。Anthropic开发的SWE-bench则要求智能体真正修复GitHub上的真实bug,通过运行项目的测试套件来判断是否成功。METR(Model Evaluation & Threat Research)组织更是关注高风险场景下的智能体能力评估,包括自主获取资源、自我复制等潜在危险能力。这些努力共同指向一个方向:评测必须发生在"真实环境"或高保真模拟环境中,且验证标准必须是客观、外部、不可伪造的。闭环测试正是这一趋势的自然延伸。
这个闭环测试提供了一种可复制的思路:把评测的锚点从智能体的自我报告,转移到外部世界的客观状态变化上。这对于构建可信赖的自主智能体系统至关重要。
对开发者与企业的实用启示
对于正在开发智能体产品的团队,这一范式提供了几点实用启示:
- 设计端到端验证流程:不要相信中间环节返回的成功信号,要检查最终目标状态。
- 引入可证伪机制:测试应当有明确的失败条件,能够暴露智能体的真实短板。
- 防范作弊路径:在评测框架中主动堵住可能的"绕过"漏洞,确保测试结果的严谨性。
Function Calling(函数调用)和Tool Use(工具使用)的技术实现需要开发者预先定义可用工具及其参数模式(通常用JSON Schema描述),模型在推理过程中判断是否需要使用工具,如果需要则生成结构化的调用请求。系统接收到这个请求后执行实际操作,并将结果返回给模型继续推理。OpenAI从GPT-3.5-turbo开始支持Function Calling,Anthropic的Claude则称之为Tool Use。这项技术的突破在于:模型不仅能生成自然语言,还能生成符合特定格式要求的结构化输出,这使得AI能够可靠地与外部系统集成。然而挑战也随之而来——如何验证模型真的正确调用了工具,以及工具调用确实产生了预期效果,这正是闭环测试要解决的核心问题。
对于企业采购或部署智能体系统的决策者来说,这也提醒我们:在评估供应商的智能体能力时,应当要求提供可证伪、可复现的闭环验证证据,而非仅仅依赖漂亮的演示视频。
在实际的企业级智能体部署中,闭环验证不仅是评测问题,更是生产环境中的可观测性(Observability)问题。在微服务架构中,分布式追踪(如OpenTelemetry)已经成为标准实践,但AI智能体引入了新的复杂性:智能体的决策过程是非确定性的,相同输入可能产生不同的工具调用序列;多步骤任务的中间状态难以全面捕获;更棘手的是,智能体可能在某个步骤"决定"改变策略,而这种策略变更本身难以被传统监控系统检测。LangSmith、Arize Phoenix等新兴的LLM可观测性平台正试图解决这些问题,它们通过记录完整的推理链和工具调用轨迹来提供事后审计能力,但这仍然是"事后"验证而非"实时"闭环确认。如何将闭环验证思想融入生产环境的实时监控体系,将是下一阶段智能体工程化的重要课题。
结语:用外部证据重建智能体可信度
随着AI智能体逐渐从实验阶段走向生产部署,其可靠性和可验证性将成为决定商业落地成败的关键因素。这个由独立开发者构建的可证伪闭环测试,虽然规模不大,却触及了一个核心命题:我们该如何真正相信一个AI说它做了某件事?
答案或许就是:不要相信它的话,去检查它在世界上留下的痕迹。这种从"自我声明"到"外部证据"的验证哲学,可能会成为未来智能体评测框架的重要基石。感兴趣的读者可以访问项目页面亲自尝试挑战这个种子循环,看看当前的AI智能体能否真正通过这一严苛的考验。
核心要点
- 工具调用型AI智能体的可靠性验证不能依赖其自我报告,必须通过外部证据确认
- 闭环测试要求:智能体执行操作→目标端产生新证据→智能体读回证据,三个环节缺一不可
- 借鉴科学哲学的"可证伪性"原则,好的AI测试应该能够暴露失败而非只展示成功
- 传统Benchmark关注"能说",但智能体评测更需要验证"能做"
- 防止智能体通过"绕过"机制作弊,确保测试的严谨性和真实性
- 闭环验证思想源自航天和工业控制领域数十年的工程实践,是经过验证的可靠性保障方法
- 企业级部署中需将闭环验证与LLM可观测性平台结合,实现从事后审计到实时确认的升级
相关推荐
Surface RTX Spark Dev Box 离线跑通 120B 模型:Intelligent Terminal 实战
微软 Surface RTX Spark Dev Box 实机演示:通过开源 Intelligent Terminal 离线运行 120B 参数本地模型,一句话自动构建可启动 Hyper-V 虚拟机,展示 Project Zemuth 设备的本地 AI 能力。

平权法案终结后,黑人新生入学率骤降与HBCU的崛起
最高法院终止种族敏感录取后,美国前50所最具选拔性大学黑人新生入学率下降27%,哈佛从18%降至11.5%,耶鲁从9.5%降至8%,更多黑人学生转向HBCU。

Claude全面加水印:付费用户也无法关闭,检测权限却只给少数人
Anthropic 将 Claude 隐形文本水印扩展至 Mythos 5、Opus 4.7 等模型,全球适用且付费用户无法退出。校对、翻译等轻量使用同样被标记,但检测权限仅开放给监管机构和企业,普通用户既无法自查也难以申诉。