Keepace.ai:专攻运动健康领域的微调大模型技术解析
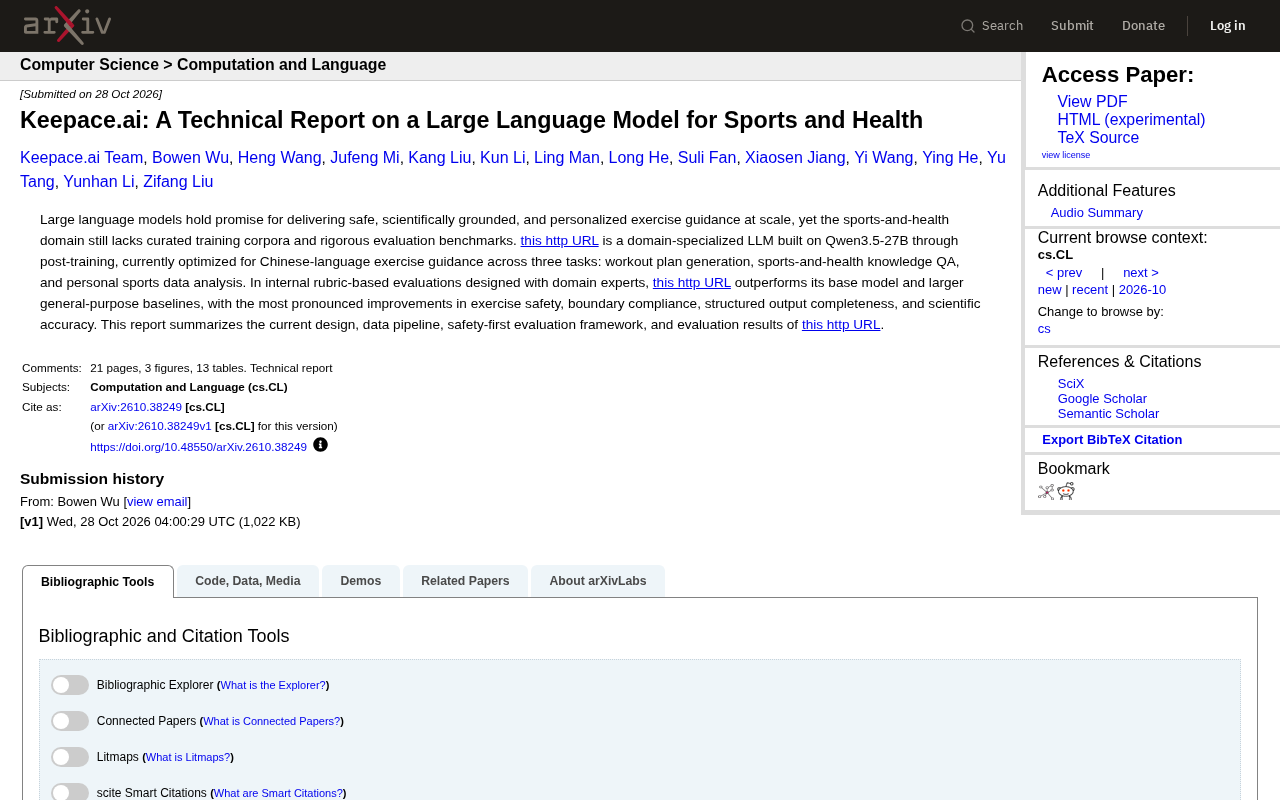
Keepace.ai 基于 Qwen3.5-27B 后训练,专注中文运动健康指导,以安全优先评估超越通用模型。
Keepace.ai 是一个面向中文运动健康场景的领域专用大模型,以 Qwen3.5-27B 为基座进行后训练,覆盖训练计划生成、运动健康知识问答和个人运动数据分析三类任务。其核心思路是弥补通用模型“覆盖面广但专业深度不足”的短板,通过领域数据管道注入专业知识。评估体系由领域专家设计,采用评分量表,将运动安全性与边界合规置于首位。内部评测显示,模型在安全性、合规性、结构化输出完整性和科学准确性上均优于基座模型及更大的通用模型。但技术报告未公开数据规模、微调方法和量化分数,当前也仅支持中文,外部复现与泛化能力仍待验证。
通用大模型在健身指导场景中常显得“什么都懂,但不够专业”——给出的训练计划可能忽略安全边界,健康问答也缺乏科学依据。Keepace.ai 试图解决这一问题:它基于 Qwen3.5-27B 进行后训练,专注中文运动指导,在内部专家设计的评估中超越了基座模型和更大的通用模型。
为什么运动健康需要专用大模型
大语言模型有能力规模化地提供安全、有科学依据且个性化的运动指导,但运动健康领域一直缺乏经过整理的高质量训练语料和严格的评估基准。通用模型虽然覆盖面广,却在专业深度上存在明显短板。Keepace.ai 的出发点正是填补这一空白:通过领域后训练,让模型在运动计划生成、运动健康知识问答和个人运动数据分析三类任务上表现更可靠。
据技术报告描述,Keepace.ai 目前针对中文场景优化,覆盖三类核心任务:生成训练计划、回答运动健康知识问题、分析个人运动数据。这种任务聚焦策略,使得模型能在特定场景下提供更贴合实际需求的输出,而非泛泛而谈。
技术路线:基于 Qwen3.5-27B 的后训练
Keepace.ai 没有从零训练基础模型,而是选择 Qwen3.5-27B 作为基座,通过后训练注入领域能力。这一选择在成本和效果之间取得平衡:27B 参数规模既能承载足够的领域知识,又不会带来过高的推理开销。技术报告强调,后训练过程依赖精心设计的数据管道,但未披露具体的微调方法(如 SFT、RLHF 等)细节。
从结果导向看,后训练后的 Keepace.ai 在多项指标上优于基座模型,说明领域数据管道的质量对最终表现起到了关键作用。
后训练(Post-training) 指在已预训练好的基础模型之上,通过额外的训练阶段注入特定能力或对齐人类偏好。常见手段包括监督微调(SFT)、基于人类反馈的强化学习(RLHF)、直接偏好优化(DPO)等。与从零预训练相比,后训练只需少量高质量领域数据即可显著改变模型行为,成本低、迭代快,是垂直领域模型的主流做法。Keepace.ai 未披露具体采用哪种后训练方法,因此其性能提升究竟来自数据质量还是算法选择,外界无法区分。
安全优先的评估框架
Keepace.ai 的评估体系由领域专家参与设计,采用评分量表(rubric-based)进行内部评测。特别之处在于将“运动安全”和“边界合规”置于核心位置——这意味着模型不仅要给出看似合理的答案,还要避免推荐危险动作、超负荷训练等可能造成伤害的内容。
在评估中,Keepace.ai 相较基座模型和更大的通用模型,在以下维度提升最为明显:运动安全性、边界合规性、结构化输出完整性以及科学准确性。这说明领域后训练不仅提升了知识密度,也强化了模型对输出边界的把控。
评分量表(Rubric-based evaluation) 是一种结构化评测方法:评估者为每个维度预先定义评分标准和档位(如 1-5 分),再对照标准逐项打分。相比“整体感觉好不好”的笼统判断,量表评分能拆解出安全性、准确性等独立维度,减少主观偏差,也便于定位模型短板。其局限在于评分仍依赖专家判断,不同评分者之间的一致性需要额外检验,且量表设计本身可能隐含设计者的偏好。
三类任务的针对性优化
训练计划生成:模型需要根据用户的身体状况、目标和可用器材,输出结构完整、循序渐进的计划。结构化输出完整性的提升直接关系到计划的可执行性。
运动健康知识问答:要求回答有科学依据,避免传播伪科学或过度绝对化的建议。科学准确性的改进在此任务中体现最为直接。
个人运动数据分析:基于用户提供的运动数据给出解读和建议。边界合规性在此尤为重要——模型不应越界做出医疗诊断。
边界合规性 在健康类 AI 中特指模型应清楚自身能力范围:可以给运动建议,但不应做出医疗诊断、推荐处方药物或替代医生判断。这一要求与“有用性”存在张力——回答过于保守会降低实用性,过于积极则可能造成伤害。运动健康场景的风险尤其具体,例如对膝伤用户推荐深蹲、对心血管疾病用户建议高强度间歇训练,都可能带来实际伤害,因此边界把控成为评估的核心维度之一。
局限与待验证之处
技术报告未公开训练数据的具体规模、来源构成以及评估的量化分数,因此外部研究者难以复现或横向对比。此外,当前优化仅限中文场景,多语言能力尚未涉及。评估为内部专家评分,缺乏公开基准上的第三方验证。这些信息缺口意味着 Keepace.ai 的实际泛化能力仍有待观察。
小结
Keepace.ai 展示了领域专用大模型在运动健康场景的可行路径:以中等规模基座模型为起点,通过后训练和专家评估框架,在安全性、合规性和科学准确性上取得可感知的提升。对于关注 AI 在垂直领域落地的从业者,其“安全优先”的评估思路比模型本身更值得借鉴。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。