Keras 社区更新:可插拔后端架构与 MLX/PaddlePaddle 支持将至

Keras 推进可插拔后端架构,拟引入 MLX 与 PaddlePaddle,并全面剥离对 TensorFlow 的隐性依赖。
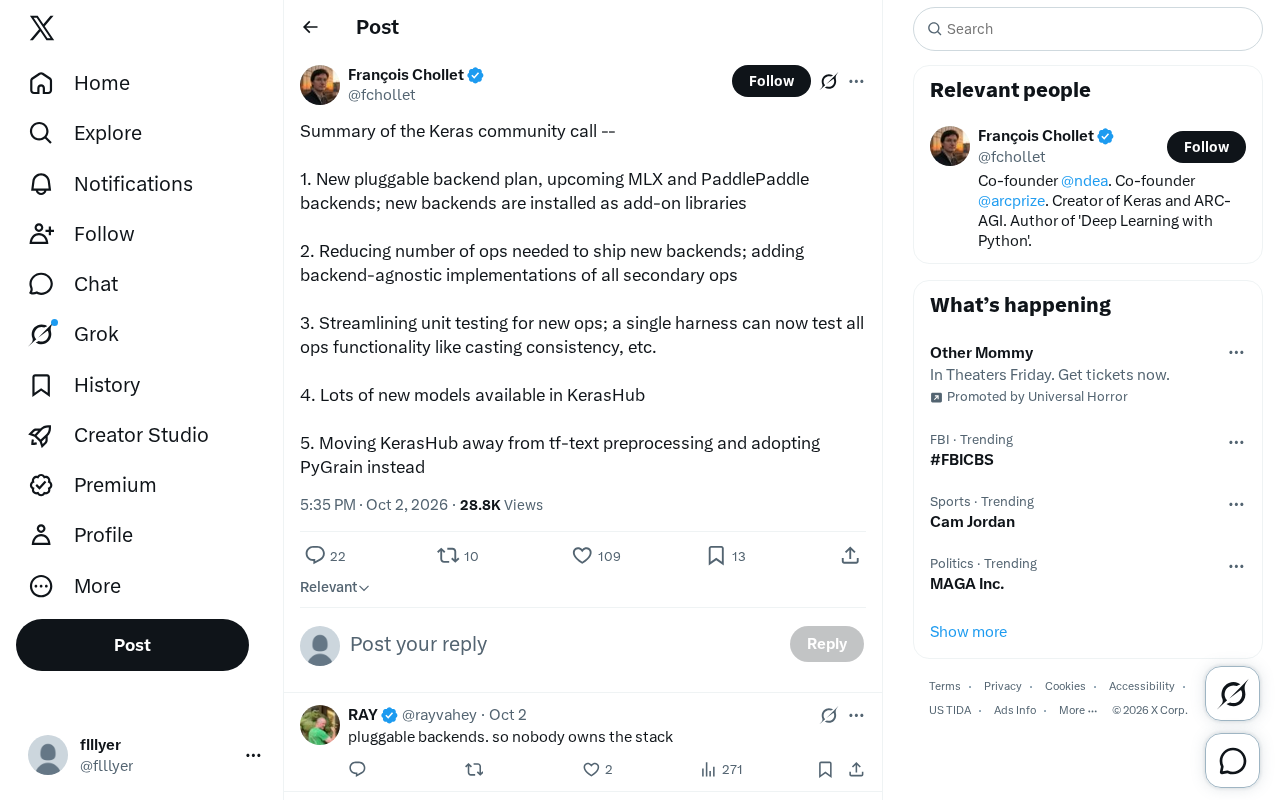
Keras 近期社区会议揭示了框架的系统性架构重构方向:后端将以独立附加库形式安装,MLX(面向 Apple Silicon)和 PaddlePaddle(国内生态)即将成为新后端;通过为二级算子提供后端无关的通用实现,新后端接入成本大幅降低;统一测试框架则确保跨后端行为一致性。模型侧,KerasHub 持续扩充预训练模型库,并将预处理工具链从强依赖 TensorFlow 的 tf-text 迁移至后端中立的 PyGrain。这一系列改动的核心逻辑高度一致:逐步剥离对任何单一后端的历史耦合,将 Keras 真正打造为后端无关的统一高层前端。
Keras 近期的社区会议释放了一系列值得关注的技术信号。从后端架构的重构到预处理工具链的现代化,这些改动不仅影响框架本身的工程质量,也在重新定义 Keras 作为多后端深度学习接口的定位。以下结合会议要点,梳理几项核心变化及其背后的意义。
可插拔后端:从内置到按需安装
此前 Keras 3 已经支持 TensorFlow、JAX 和 PyTorch 三大后端,而这次会议明确了一个更激进的方向——可插拔后端(pluggable backend)架构。新的后端将以附加库(add-on libraries)的形式独立安装,而非打包进 Keras 核心。
会议同时预告了两个即将到来的新后端:MLX 和 PaddlePaddle。MLX 是面向 Apple Silicon 优化的机器学习框架,其加入意味着 Keras 有望在 Mac 生态上获得更原生的加速能力;PaddlePaddle 则扩展了 Keras 在国内深度学习生态中的触达范围。
将后端解耦为附加库的设计有明显的工程价值:核心库体积更可控、后端迭代不再受主版本发布节奏绑定、第三方也更容易贡献新的执行引擎。这实际上是把 Keras 从一个「多后端框架」推向「后端无关的统一前端」。
MLX 由 Apple 于 2023 年底开源,专为搭载 Apple Silicon(M 系列芯片)的设备设计。其核心特点是统一内存模型——CPU 与 GPU 共享同一块物理内存,无需显式数据拷贝,这对于内存带宽受限的 MacBook 类设备尤为关键。MLX 的 API 设计借鉴了 NumPy 和 PyTorch 的风格,并原生支持惰性求值(lazy evaluation)与自动微分,使其具备成为 Keras 后端的完整基础。PaddlePaddle(飞桨)则是百度主导的开源深度学习框架,在国内工业落地场景积累了大量定制化算子与训练优化能力,其接入 Keras 可让国内开发者在熟悉的基础设施上直接使用 Keras 的高层 API,无需重写模型代码。
降低新后端的接入门槛
要让更多后端能够顺利接入,关键在于减少每个后端必须实现的算子(ops)数量。会议提到的做法是为所有二级算子(secondary ops)提供后端无关的实现。
换句话说,新后端只需实现一组最小的核心算子,其余的高阶操作可以复用 Keras 层面与后端无关的通用实现。这种分层策略显著降低了接入成本——后端开发者不必重新造轮子,就能让自己的引擎跑起来大部分功能。对于 MLX、PaddlePaddle 乃至未来更多的后端来说,这是能否快速落地的决定性因素。
「核心算子」与「二级算子」的划分是后端分层设计的关键。核心算子(primary ops)通常是矩阵乘法、逐元素运算、归约操作等数量有限但性能敏感的原语,必须由各后端用原生代码高效实现。二级算子则是基于核心算子组合而成的高阶操作,例如各类激活函数的变体、部分归一化层的计算逻辑等——这些操作在性能上不那么关键,但数量庞大。Keras 为这些二级算子提供用核心算子拼接的通用参考实现,后端只需「实现少量、复用多数」,实质上是把接入成本从 O(全部算子) 压缩到 O(核心算子),对希望快速验证新执行引擎可行性的团队来说门槛大幅降低。
统一的算子测试框架
伴随算子体系的重构,测试流程也在同步简化。会议透露,现在可以用单一测试框架(harness)覆盖所有算子的功能验证,包括类型转换一致性(casting consistency)等关键行为。
在一个要支撑多个后端的框架里,测试的重要性被进一步放大——同一段代码在 TensorFlow、JAX、PyTorch、MLX 上必须给出一致的数值和行为结果。统一的测试 harness 意味着跨后端的一致性可以被系统化地验证,而不是依赖零散的用例。这类看似「不性感」的基础设施投入,恰恰是多后端策略能否长期可信的底层保障。
KerasHub 的模型扩充与预处理迁移
模型层面的进展集中在 KerasHub。会议提到大量新模型已经在 KerasHub 上线,进一步丰富了开箱即用的预训练模型库。
更说个细节预处理工具链的调整:KerasHub 正在从 tf-text 预处理迁移到 PyGrain。tf-text 与 TensorFlow 深度绑定,在多后端场景下会成为一个尴尬的依赖——用 PyTorch 或 JAX 后端的用户不应被迫拉入一整套 TensorFlow 文本处理栈。PyGrain 作为一个更后端中立的数据加载与预处理方案,其引入与前述「可插拔后端」的整体方向高度一致。
这一迁移再次印证了 Keras 团队的核心思路:逐步剥离对任何单一后端的隐性依赖,让框架真正做到后端无关。
PyGrain 是 Google DeepMind 开源的数据加载与预处理库,设计目标是与具体的机器学习框架解耦,以 Python 原生数据结构为中心,支持高效的随机访问、确定性混洗与多进程预取。相比之下,tf-text 的算子以 TensorFlow op 的形式实现,运行时强依赖 TensorFlow 的计算图和会话机制,即便用户只是想做分词或文本编码,也必须承担 TensorFlow 的全量依赖。将预处理栈迁移到 PyGrain 意味着数据管道可以在任何后端环境中运行,用户可以用 JAX 或 PyTorch 后端训练模型,同时享受相同的预处理逻辑,不会再出现「模型后端是 JAX,数据处理却悄悄运行着一个 TensorFlow 会话」的混乱局面。
整体趋势解读
把这五条要点串联起来看,会议传递的信号相当清晰。Keras 正在系统性地完成一次架构上的「去中心化」:后端可插拔、算子分层复用、测试统一、预处理中立。每一项改动都在削弱对某个特定后端(尤其是 TensorFlow)的历史耦合。
对使用者而言,这带来的是更自由的后端选择和更轻量的依赖;对生态而言,MLX 和 PaddlePaddle 的加入拓宽了 Keras 的适用场景,从 Apple 设备到国内框架都有了着力点。Keras 作为统一高层 API 的价值,可能会因为这些底层工程的夯实而被重新认识。
需要说明的是,以上内容基于社区会议摘要整理,具体实现细节和发布时间以 Keras 官方后续公告为准。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。