Kijai更新MiniMax-H3 VAE:显存占用更低,画质不打折
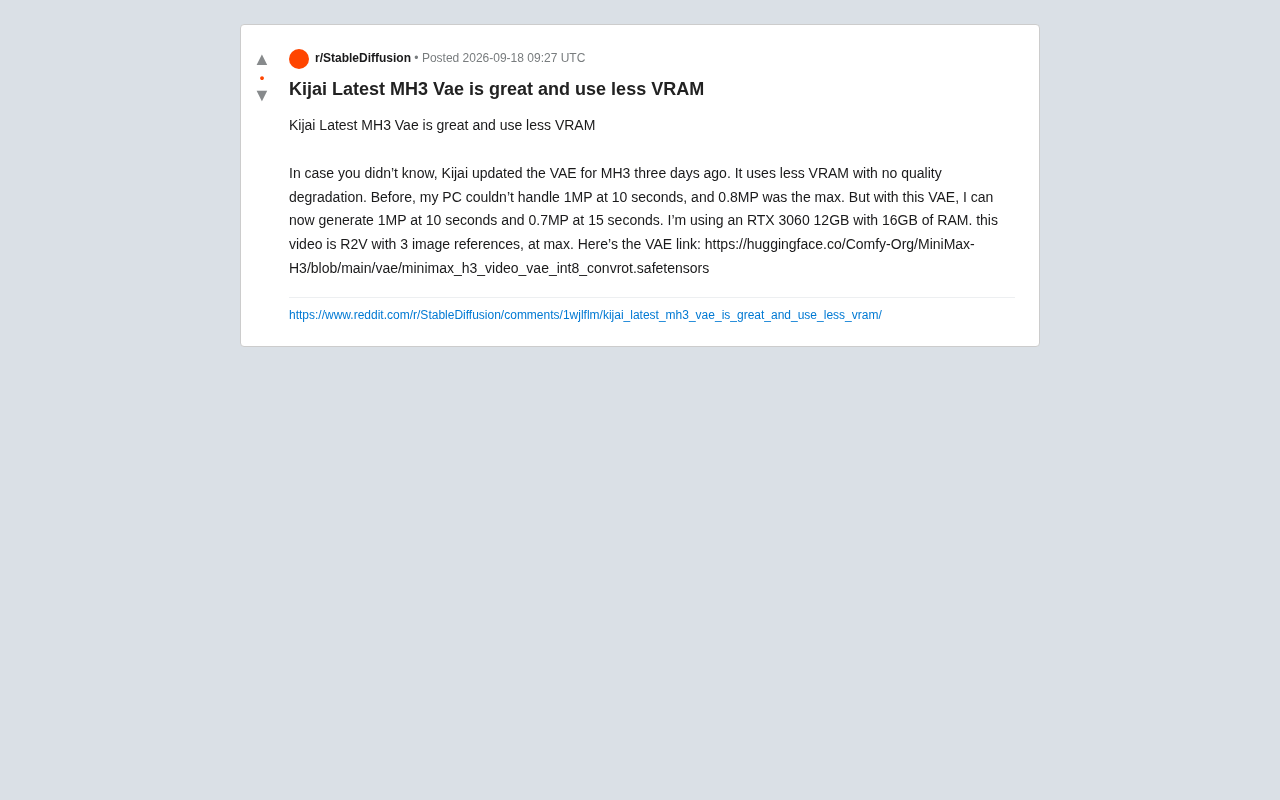
Kijai为MiniMax-H3发布int8量化VAE,RTX 3060 12GB可生成1MP/10秒视频且几乎无画质损失。
开源贡献者 Kijai 为 MiniMax-H3(MH3)视频生成模型更新了 VAE 组件,新版文件采用 int8 量化与 convrot 结构优化,在显著降低显存占用的同时据用户反馈几乎未损失画质。RTX 3060 12GB 用户实测显示,更新前无法完成的 1MP/10 秒生成任务已可正常运行,还可选择以 0.7MP 分辨率换取 15 秒的更长时长。这一优化对消费级显卡用户的实际价值不亚于模型本身的版本升级,也体现了开源社区在模型适配与工程优化层面对官方发布的重要补充作用。新版 VAE 已托管于 Hugging Face 的 Comfy-Org 仓库,可直接替换使用,但性能表现因硬件与配置而异,建议小规模测试后再正式采用。
在AI视频生成社区里,显存(VRAM)始终是绕不开的门槛。对于大量使用消费级显卡的创作者来说,能否在有限的显存下跑出更高分辨率、更长时长的视频,直接决定了工具的可用性。近期,知名开源贡献者 Kijai 更新了 MiniMax-H3(MH3)的 VAE 模型,据 Reddit 用户实测,这次更新在几乎不损失画质的前提下显著降低了显存占用。
更新带来了什么
据 Reddit 社区一位使用 RTX 3060 12GB 的用户反馈,Kijai 在三天前更新了 MH3 的 VAE 组件。这次更新最直接的价值是——用更少的显存实现同等甚至更高的生成规格,且没有出现画质退化。
对于中低端显卡用户而言,这类优化往往比模型本身的能力提升更实用。VAE(变分自编码器)负责在潜空间与像素空间之间做编解码,是视频/图像生成管线中显存消耗的重要环节之一。通过更高效的实现(本次为 int8 量化版本),可以在编解码阶段省下可观的显存。
实测数据:分辨率与时长的提升
这位用户给出的对比很直观:
- 更新前:PC 无法处理 1MP(百万像素)10 秒的生成任务,0.8MP 已是极限;
- 更新后:可以生成 1MP / 10 秒,以及 0.7MP / 15 秒 的视频。
测试硬件为 RTX 3060 12GB 显卡 + 16GB 内存,这是一套非常典型的入门级配置。测试内容是一段 R2V(Reference-to-Video,参考图生成视频)任务,最多使用了 3 张图像参考。
从数据看,更新不仅让此前跑不动的 1MP@10s 变为可行,还能在牺牲部分分辨率的情况下把时长拉长到 15 秒。这意味着同样的硬件,创作空间明显扩大。
这里的「MP(百万像素)」是视频分辨率的面积度量单位,1MP 即约 100 万像素。常见分辨率换算参考:1MP 约对应 1280×800 或 960×1024 等比例,0.8MP 约对应 1024×768,0.7MP 约对应 1280×576。在视频生成任务中,显存消耗与「分辨率 × 帧数」成正比——更高分辨率或更长时长都会线性乃至超线性地增加显存需求,这也是为什么 RTX 3060 在未优化版本下无法处理 1MP@10 秒,却在更新后得以突破这一限制。
为什么 int8 量化 VAE 值得关注
本次更新的模型文件名为 minimax_h3_video_vae_int8_convrot.safetensors,从命名可以读出两个关键信息:
int8 量化
int8 表示将原本的高精度权重压缩为 8 位整数表示。量化是降低显存与计算负担的常规手段,但难点在于如何在压缩精度的同时不明显损失输出质量。用户反馈中「no quality degradation(无画质退化)」的说法,正是这次更新最受关注的地方——如果量化能做到几乎无损,那对显存受限用户几乎是纯收益。
量化的核心原理是将浮点数权重(通常为 float32 或 float16)映射到低比特整数表示。以 int8 为例,每个权重仅用 8 位整数存储,相比 float16 的 16 位减少了一半的内存占用,推理时的带宽压力也随之降低。量化并非简单截断,而是通过校准(calibration)步骤确定每层权重的缩放因子,使得整数值能以最小误差还原原始浮点数的分布范围。对 VAE 这类结构而言,编解码过程涉及大量卷积运算,权重量化带来的显存节省尤为明显。挑战在于 VAE 的解码器对数值精度较为敏感——轻微的量化误差可能在像素空间被放大,产生色块、伪影或细节模糊。因此「无画质退化」并非量化的默认结果,而是依赖精细的量化策略和充分校准才能实现的工程成果。
convrot 结构优化
文件名中的 convrot 暗示了卷积/旋转相关的结构调整,通常是针对推理效率或潜空间表示做的工程优化。虽然原始信息未展开技术细节,但结合社区反馈的实际效果,可以推测这些改动共同促成了显存与质量的平衡。
convrot 这一命名在开源社区通常与「旋转位置编码应用于卷积层」或「卷积权重的旋转变换分解」相关。一种常见做法是将标准卷积核分解为旋转不变的基础结构与可学习的旋转参数,从而在保留表达能力的同时减少有效参数量,降低推理时的计算和显存开销。另一种解读是在潜空间中引入旋转位置表示(类似 RoPE 在 Transformer 中的作用),使模型在时序或空间维度上的泛化能力更强。无论具体实现路径如何,convrot 与 int8 量化的组合暗示这次更新同时在「权重精度」和「网络结构」两个层面做了协同优化,二者叠加才产生了显著的显存降低效果。
对消费级显卡用户的意义
RTX 3060 12GB 是目前大量 AI 创作者的主力卡,显存 12GB 在视频生成任务中并不宽裕。这类由社区贡献者推动的优化,往往能让「跑不动」变成「勉强能跑」,甚至「流畅可用」。
更重要的是,这体现了开源生态的典型价值:模型的原始能力由团队发布,而针对不同硬件的量化、优化、适配则由 Kijai 这样的贡献者持续迭代,最终让更广泛的用户群体受益。对于预算有限、无法上高端显卡的个人创作者,这类更新的实际价值不亚于一次模型版本升级。
如何获取
更新后的 VAE 已托管在 Hugging Face 的 Comfy-Org 仓库中,感兴趣的用户可以直接下载替换原有 VAE 文件:
模型地址:huggingface.co/Comfy-Org/MiniMax-H3
需要提醒的是,以上性能数据来自单一 Reddit 用户在特定硬件与任务(R2V + 3 图参考)下的实测,实际表现可能因显卡型号、驱动、工作流配置及生成参数而异。建议用户在自己的环境中做小规模测试后再投入正式创作。
小结
这次 MH3 VAE 更新是一个「小而实」的典型案例:没有炫目的新功能,但通过 int8 量化和结构优化,实打实地降低了显存门槛,让入门级显卡也能跑出更高规格的视频生成任务。对于关注 MiniMax-H3 及 ComfyUI 视频工作流的用户,这是一个值得尝试的替换升级。
相关推荐
Claude Code国内实战指南:从安装到MCP的完整上手路径
Claude Code 国内使用完整指南,涵盖 Windows 安装、PyCharm/VSCode 等 IDE 集成、内置命令与记忆机制、三种权限模式、MCP 工具自定义及 Skills 技能系统,帮助开发者快速上手 AI 辅助编程。
免费领取一年Google AI Pro:Gemini学生优惠保姆级教程
谷歌Gemini重开学生免费计划,新老用户均可免费领取一年Google AI Pro会员。本文梳理保姆级教程:三种页面情况处理、Plus改Pro技巧、绑卡订阅与取消自动续费全流程及风险提示。
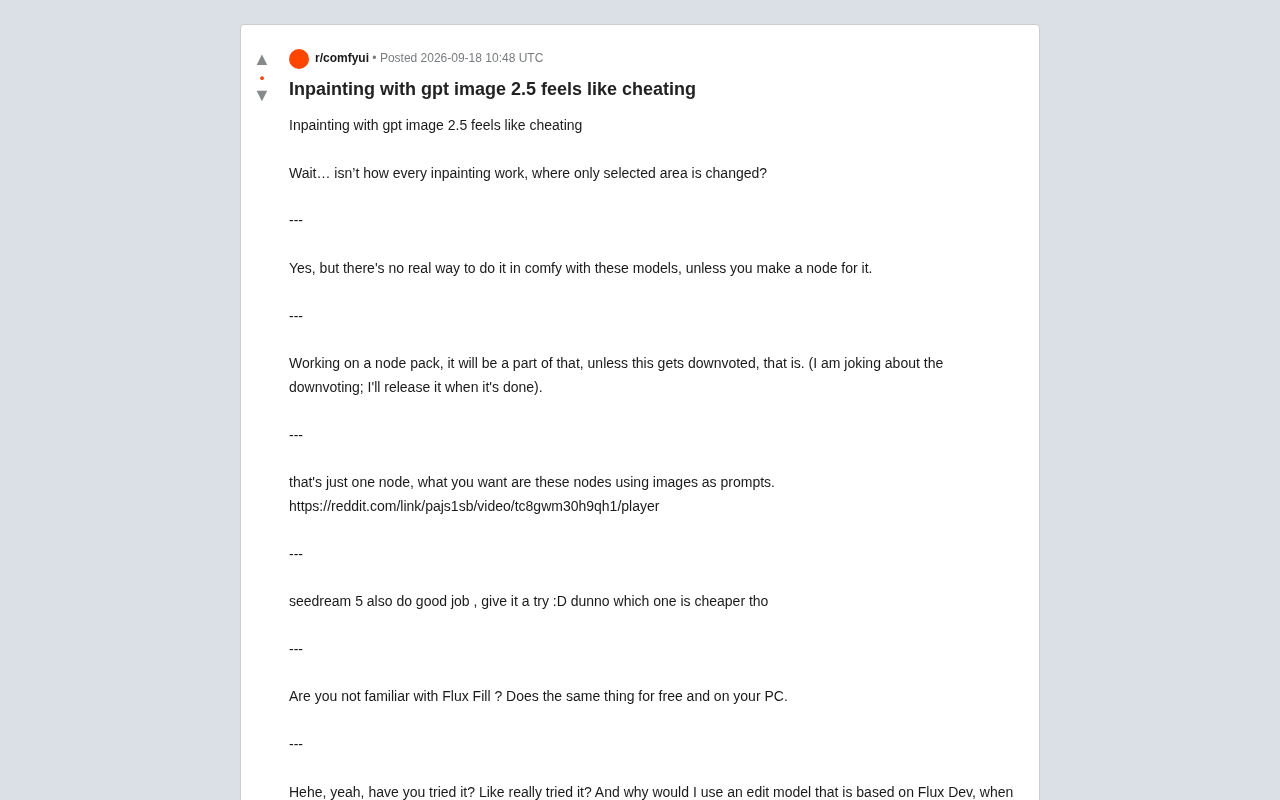
GPT Image 2.5 局部重绘实测:ComfyUI 里像开挂
Reddit 社区热议 GPT Image 2.5 局部重绘(Inpainting)效果惊艳如"开挂",本文对比其与 Flux Fill、Seedream 5 等方案的差异,并探讨如何将商业模型接入 ComfyUI 节点工作流。