Kimi Code安装与实战:免费国产AI编程助手上手指南

为什么需要一款国产AI编程助手?
Claude Code 作为当前最热门的AI编程工具之一,功能确实强大,但对国内用户来说存在几个明显的痛点:配置繁琐、需要科学上网、网络延迟高、上手门槛不低。这些问题让不少开发者和普通用户望而却步。
Claude Code 是 Anthropic 公司推出的基于命令行的AI编程助手,它依托 Claude 系列大语言模型(尤其是 Claude 3.5/4 系列),能够直接在终端环境中理解代码上下文、执行文件操作、运行命令并进行多轮对话式编程。Anthropic 由前 OpenAI 研究副总裁 Dario Amodei 创立,以"AI安全"为核心理念,其 Claude 模型在代码生成、逻辑推理和长文本理解方面表现突出,在 SWE-bench(软件工程基准测试)等权威评测中长期位居前列。Claude Code 的核心优势在于它能深度融入开发者的工作流——不同于 IDE 插件形式的 GitHub Copilot,它以终端原生工具的形态存在,可以直接读写项目文件、执行 git 操作、运行测试脚本,实现从"对话"到"执行"的闭环。正因如此,它在海外开发者群体中迅速走红,但国内用户却因网络和配置问题难以享受到同等体验。
最近,月之暗面团队推出了 Kimi Code——一款专为国内环境打造的AI编程与办公工具。月之暗面(Moonshot AI)成立于2023年,由清华大学教授杨植麟创立,是国内大模型赛道的头部创业公司之一。公司以长文本处理能力起家,其 Kimi 系列模型最早以支持20万字超长上下文窗口而闻名,后逐步扩展至多模态理解、代码生成等领域。Kimi Code 作为其开发者工具生态的重要一环,不仅在代码开发层面对标 Claude Code,还额外集成了视频理解、实时数据查询、批量文档处理等实用功能。这也反映了国内大模型公司从"模型能力竞赛"向"应用工具落地"转型的行业趋势。本文将从安装配置到核心功能,手把手带你快速上手这款国产AI编程助手。
Kimi Code 一键安装与账号配置
安装过程:真正的零门槛
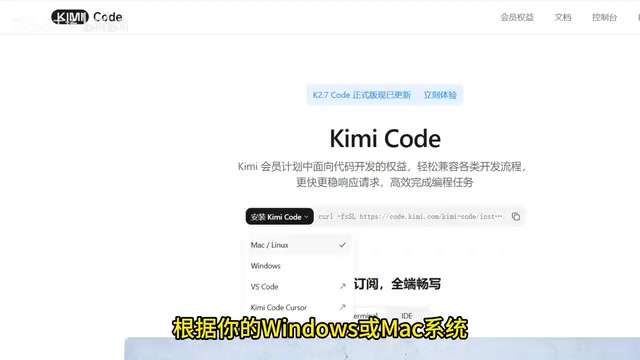
Kimi Code 的安装流程极其简洁。打开 Kimi Code 官网,根据你的操作系统(Windows 或 Mac)复制对应的一键安装命令,粘贴到终端执行即可。全程自动完成,无需手动配置环境变量或安装依赖项。
账号配置:三步搞定
安装完成后,在终端输入 kimi 进入交互界面,再输入 login 进行账号配置。系统会提供三个选项:
- 新用户注册
- 国内版 Kimi(国内用户推荐)
- 海外版
国内用户直接选择第二个选项,输入你的 Kimi 国内 API 密钥即可完成配置。API 密钥(API Key)是大模型服务中最常见的身份认证方式,它本质上是一串由服务提供商生成的唯一字符串,用于标识调用者身份、控制访问权限和计量使用额度。当你在 Kimi Code 中配置 API 密钥时,实际上是在建立本地终端工具与 Kimi 云端模型服务之间的安全通信通道。每次发送请求时,密钥会随请求一起传输到服务器进行验证。与 OAuth 等复杂认证流程相比,API Key 的优势在于配置简单、适合开发者工具场景,但也需要注意妥善保管——泄露密钥可能导致额度被盗用。
整个过程不到一分钟,配置完毕后默认使用最新的 Kimi 2 Pillow 7 大模型,连接稳定且响应速度快,不存在 Claude Code 那种动不动就超时的问题。
Kimi Code 四大核心功能详解
视频理解与内容提取
这是自媒体创作者和内容工作者的福音。传统做法是手动观看视频、记笔记、整理要点,费时费力。Kimi Code 提供了强大的视频解析能力——直接将 B站视频链接丢给它,就能自动解析视频全部内容并梳理核心逻辑。这一能力背后依赖的是多模态大模型技术,即模型不仅能处理文本,还能理解视频中的画面、语音和字幕信息,将多种模态的信息融合后进行语义理解和内容提炼。
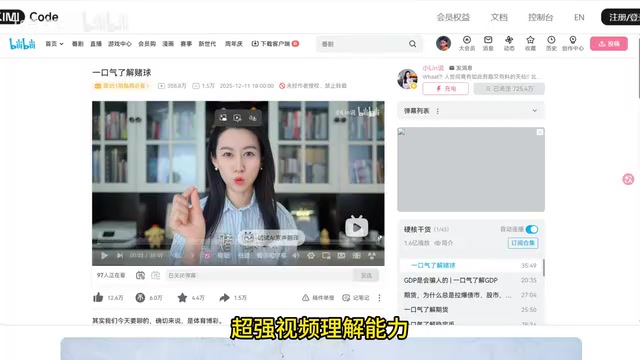
输入 auto 命令可开启全自动运行模式,无需手动干预。等待几秒后,就能生成完整的视频总结文案。你还可以在此基础上进行二次加工:
- 提取重点:快速抓取核心观点
- 文案拆解:分析视频的内容框架
- 二创解说:基于总结生成新的解说稿
- 干货复盘:系统性整理知识点
对于日常需要大量消化视频内容的用户来说,这个功能可以节省大量时间。
灵活切换大模型
不同任务对模型的要求不同——写代码可能需要逻辑推理更强的模型,写文案可能需要语言表达更好的模型。Kimi Code 支持通过 provider 命令一键切换各类主流大模型。
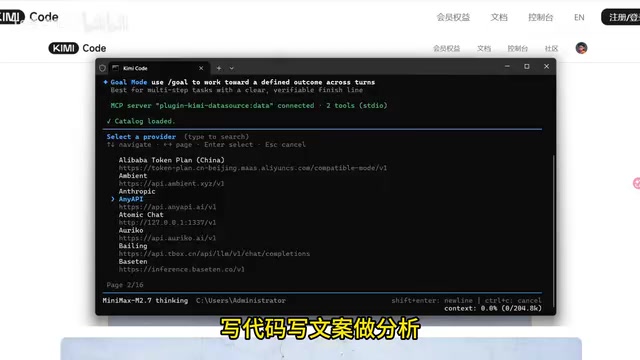
支持多模型切换反映了当前AI工具发展的一个重要趋势——"模型路由"(Model Routing)。不同大模型在不同任务上各有所长:例如 Claude 系列擅长代码生成和长文本推理,GPT-4o 在多模态理解上表现突出,而国内的 DeepSeek广告 在数学推理方面具有优势。单一模型难以在所有场景中都达到最优表现,因此越来越多的AI工具开始采用"模型聚合"架构,允许用户根据具体任务选择最合适的模型。这种架构的底层通常依赖统一的 API 适配层,将不同模型提供商的接口差异抽象化,对用户呈现一致的交互体验。OpenRouter、硅基流动等平台也在做类似的事情,但 Kimi Code 将这一能力直接内置到终端工具中,降低了用户的切换成本。
这种灵活性意味着你不用在多个工具之间反复横跳,一个终端界面就能适配所有场景。无论是代码调试、文案撰写还是数据分析,都能找到最合适的模型来完成任务。
实时数据查询
在终端输入 pagin 可打开插件中心,安装官方的 DataPagesource 插件后即可解锁全网实时数据查询权限。这一功能本质上是通过插件机制为大模型接入了外部数据源,解决了大语言模型的一个核心局限——训练数据存在时间截止点,无法获取实时信息。通过插件调用外部 API 和数据接口,模型可以在推理过程中动态获取最新数据,这种"检索增强生成"(RAG, Retrieval-Augmented Generation)的思路已成为业界主流的实时信息解决方案。
支持的数据类型包括:
- 股市行情:实时股价、K线数据
- 工商信息:企业注册信息、股权结构
- 学术文献:论文检索与摘要提取
- 行业数据:市场报告、趋势分析
对于需要频繁做市场调研和数据分析的职场人来说,这个功能直接省去了翻夜查资料的时间,调研效率可以翻倍。
Swarm 群组并行模式(王牌功能)
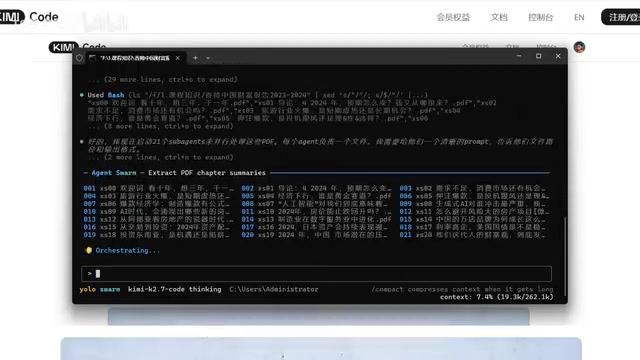
这是 Kimi Code 最具差异化的功能之一。普通AI工具处理文档时只能单文件逐个处理,遇到大量文件时效率极低。而 Kimi Code 的 Swarm(群组并行)模式可以同时处理多个文件。
Swarm 并行模式的核心思想源自分布式计算中的"任务并行"范式。传统的单线程文档处理方式是串行的——处理完第一个文件才能开始第二个,总耗时等于所有文件处理时间之和。而并行模式则同时启动多个处理实例,每个实例独立处理一个文件,总耗时接近于单个文件的处理时间。在大模型应用场景中,实现这一能力需要解决几个关键技术问题:一是并发请求管理,需要合理控制同时发送给模型的请求数量,避免触发速率限制(Rate Limit);二是上下文隔离,确保每个文件的处理互不干扰;三是结果聚合,将多个并行任务的输出整合为统一的结构化结果。这种设计思路与 MapReduce 框架有异曲同工之妙——先"分发"(Map)再"汇总"(Reduce),非常适合批量文档分析、大规模数据提取等场景。
使用方式也很直观:开启 Swarm 模式后,直接导入整个文件夹路径,所有文件会同步并行处理。据实测,一次性处理 21 篇 PDF 文档,Kimi Code 能够同时解析、汇总、整合内容,并自动生成完整的总结文案。
这个功能在以下场景中尤为实用:
- 学术研究:批量阅读和整理文献
- 项目管理:快速消化大量项目文档
- 内容创作:从多份素材中提炼观点
Kimi Code vs Claude Code:该怎么选?
| 对比维度 | Kimi Code | Claude Code |
|---|---|---|
| 安装难度 | 一行命令,零配置 | 需要配置环境,步骤较多 |
| 网络要求 | 国内直连,无需翻墙 | 需要科学上网 |
| 使用成本 | 免费使用 | 需付费订阅 |
| 模型切换 | 支持多模型切换 | 仅限 Claude 系列 |
| 附加功能 | 视频解析、数据查询、批量处理 | 专注代码开发 |
| 代码能力 | 依赖 Kimi 2 模型,中等偏上 | 业界顶尖 |
客观来说,如果你的核心需求是纯粹的代码开发,Claude Code 在编程能力上仍然是第一梯队。Claude 模型在 SWE-bench Verified 等代码评测基准中持续保持领先,其对复杂代码库的理解深度和多步骤编程任务的完成质量目前仍难以被超越。但如果你是学生、自媒体创作者、或者需要一个综合性AI办公助手的职场人,Kimi Code 的零门槛 + 多功能 + 国内适配的组合显然更具吸引力。
值得注意的是,这两款工具并非完全的竞争关系,它们代表了AI编程工具发展的两个方向:Claude Code 走的是"专精深"路线,追求在代码开发这一垂直场景中做到极致;Kimi Code 走的是"广而全"路线,试图成为一个覆盖编程、办公、创作等多场景的综合性终端AI助手。用户完全可以根据不同场景搭配使用。
总结
Kimi Code 的出现填补了国内用户在终端AI工具上的一个空白。它不试图在每个单点功能上都超越 Claude Code,而是通过轻量化安装、本土化适配、多功能集成这三个维度,为国内用户提供了一个更实用的选择。
从更宏观的视角来看,Kimi Code 的推出也标志着国内AI工具生态正在从"模型层竞争"走向"应用层竞争"。过去一年,国内大模型公司的焦点主要集中在基座模型的参数规模和基准测试分数上,而现在越来越多的团队开始意识到,真正决定用户留存的不是模型跑分,而是工具体验——安装是否便捷、功能是否贴合实际需求、生态是否完善。Kimi Code 在这方面迈出了值得肯定的一步。
无论你是零基础的新手还是有经验的开发者,都值得花几分钟安装体验一下。毕竟,一行命令的事。
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。