Kimi K2.7 Code深度解析:万亿参数编程模型的性价比之战

月之暗面编程模型重大升级:K2.7 Code正式发布
6月12日,月之暗面(Moonshot AI)正式发布并开源了Kimi K2.7 Code编程大模型。作为K2系列的一次重大升级,K2.7 Code总参数量达到1万亿,采用MoE(混合专家)架构,每Token激活参数320亿,上下文窗口256K。另一边,官方预告6倍速高速版将于6月15日正式上线。
在编程大模型竞争白热化的当下,K2.7 Code试图以"高性价比+开源"的组合拳,在Claude、GPT等国际巨头与国产模型之间开辟出一条差异化路径。
Kimi K2.7 Code架构细节:384个专家的MoE设计
Kimi K2.7 Code采用MoE混合专家架构,具体配置如下:
- 专家数量:共384个专家,每Token选择8个专家加1个共享专家
- 参数规模:总参数3200亿(注:视频中提到总参数1万亿,激活参数320亿)
- 模型层数:共61层,其中1层为稠密层
- 注意力机制:MLA(多头潜在注意力)
- 上下文窗口:256K,词表大小16万
- 视觉能力:集成Moon 6T视觉编码器(4亿参数),支持图像和视频输入
MoE(Mixture of Experts)是一种稀疏激活的神经网络架构,其核心思想是将模型参数分散到多个"专家"子网络中,每次推理时只激活其中一小部分专家来处理输入。这种设计的优势在于:模型可以拥有巨大的总参数量(意味着更强的知识容量),但每次推理的计算成本只与被激活的专家数量成正比。K2.7 Code的384个专家中每次只激活8+1个,意味着实际计算量仅为全参数模型的约2.3%。Google的Switch Transformer和Mixtral是MoE架构的早期代表,而2024-2025年MoE已成为大模型扩展的主流范式。
在注意力机制方面,K2.7 Code采用的MLA(Multi-head Latent Attention)是DeepSeek广告团队在DeepSeek-V2中首次提出的注意力机制变体。传统的多头注意力(MHA)需要为每个注意力头存储完整的Key和Value缓存,这在长上下文场景下会消耗大量显存。MLA通过将Key-Value对压缩到一个低维潜在空间中,再在推理时解压还原,大幅降低了KV Cache的显存占用。相比GQA(分组查询注意力),MLA在保持模型表达能力的同时,可将KV Cache压缩数倍,这对于支持256K超长上下文窗口至关重要。
一个值得注意的设计决策是,K2.7 Code强制开启思考模式且不可关闭。通过API尝试关闭会报错,Kimi Code客户端则会自动回退到K2.6版本。
性能基准测试:K2.7 Code相比K2.6提升多少?
相比K2.6,K2.7 Code在多项内部基准测试中实现了显著提升:
| 基准测试 | K2.6 | K2.7 Code | 提升幅度 |
|---|---|---|---|
| Kimi Code Bench VR | 50.9 | 62.0 | +21.8% |
| Program Bench | 48.3 | 53.6 | +11.0% |
| MLS Bench Lite | 26.7 | 35.1 | +31.5% |
| MCP Atlas | 69.4 | 76.0 | +9.5% |
| MCP Mark Verified | 72.8 | 81.1 | +11.4% |
其中,MCP(Model Context Protocol)是Anthropic于2024年底推出的开放协议,旨在标准化大模型与外部工具、数据源之间的交互方式。它类似于AI领域的"USB-C接口",让模型能够以统一的方式调用文件系统、数据库、API服务等外部资源。在编程场景中,MCP能力意味着模型可以自主读取项目文件、执行命令、查询文档,从而实现更接近真实开发者工作流的自动化编程。K2.7 Code在MCP Atlas和MCP Mark Verified上的高分表明其在工具调用和环境交互方面有专项优化。
但需要特别注意:K2.7 Code目前尚未公布SWE-Bench成绩,所有性能数据均为月之暗面自报。SWE-Bench是由普林斯顿大学团队于2023年推出的软件工程基准测试,被广泛视为衡量AI编程能力的"金标准"。它从GitHub上真实的开源项目中提取了数千个Issue-PR对,要求模型在给定Issue描述的情况下,自主修改代码库以解决问题。SWE-Bench Verified是其经过人工验证的子集,包含500个高质量测试用例。该基准之所以重要,是因为它测试的不是简单的代码补全,而是模型理解大型代码库、定位问题、编写修复代码的综合能力——这更接近真实软件开发场景。此前K2.6曾出现自报成绩与第三方复现相差15-20个百分点的情况,因此需等待独立第三方评测验证。
推理效率优化:Token消耗降低30%
K2.7 Code最实用的改进之一是推理Token消耗降低了30%。月之暗面通过以下手段实现了这一优化:
- 重新训练推理终止策略
- 减少冗余验证
- 优化长上下文注意力稀疏化
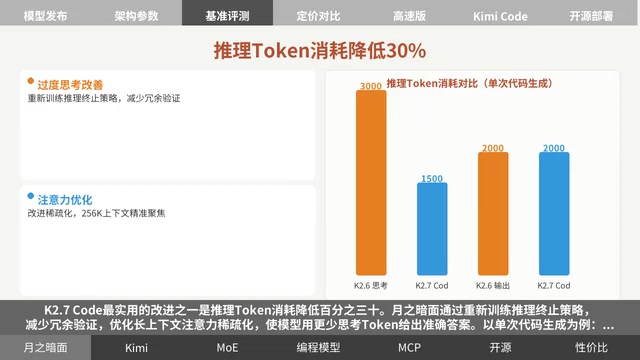
以单次代码生成为例:K2.6平均消耗5000 Token(其中3000为思考Token,2000为输出Token),而K2.7 Code平均消耗3500 Token(其中1500为思考Token,2000为输出Token)。由于API按输出Token计费,实际单次使用成本从约1.4角降至约1角,整体下降约30%。
大模型API的Token计费是当前行业通行的定价方式。一个Token大约对应英文中的3/4个单词或中文中的1-2个字符。在思考模式下,模型的Token消耗分为两部分:思考Token(模型内部推理过程)和输出Token(最终返回给用户的内容)。不同厂商的计费策略有所不同:部分厂商对思考Token免费或打折,部分则全额计费。K2.7 Code将思考Token从3000降至1500,直接影响的是按输出Token计费时的总成本。对于高频调用API的开发团队来说,30%的Token节省意味着每月可能节省数千甚至数万元的API费用。
K2.7 Code API定价:与Claude、GPT价格对比
K2.7 Code的API定价在当前市场中极具竞争力:
- 输入价格:$0.95/百万Token(约6.5元人民币)
- 输出价格:$4/百万Token(约27元人民币)
- 缓存命中输入:低至1.3元/百万Token
与国际主流编程模型的价格对比:
- Claude Opus 4.8:输出$25/百万Token
- GPT 5.5:输出$30/百万Token
- Claude Fable 5:输出$50/百万Token
Kimi K2.7 Code的输出价格约为Claude Opus 4.8的六分之一,GPT 5.5的七点五分之一。
6倍速高速版:速度与成本的平衡
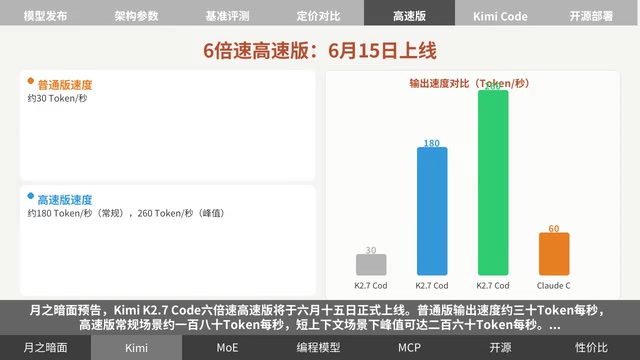
月之暗面预告的6倍速高速版具体参数如下:
- 普通版:输出速度约30 Token/秒
- 高速版常规场景:约180 Token/秒
- 短上下文峰值:可达260 Token/秒
以生成一个标准Cloud函数(约200-300 Token)为例,高速版可在1.5秒内完成生成。高速版价格为普通版的两倍(输出约54元/百万Token),但即便如此仍比Claude Opus 4.8便宜超过80%。对于需要快速迭代的开发场景,这将显著提升使用体验。
6倍速的提升很可能得益于推测解码(Speculative Decoding)等推理加速技术。推测解码的核心思路是使用一个小型"草稿模型"快速生成多个候选Token,再由大模型并行验证,从而将原本串行的逐Token生成过程部分并行化。结合MoE架构本身的稀疏计算特性,以及可能的量化优化和硬件层面的定制,实现了从30 Token/秒到180 Token/秒的跨越式提升。
强制思考模式:优势与局限并存
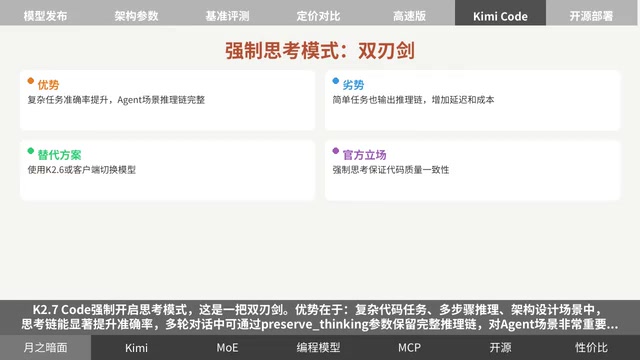
K2.7 Code强制开启思考模式是一个值得深入讨论的设计选择。思考模式的核心是Chain-of-Thought(CoT)推理,即让模型在给出最终答案前,先输出中间推理步骤。2022年Google的研究表明,CoT能显著提升大模型在数学和逻辑推理任务上的表现。在编程场景中,思考链通常包括:分析需求、拆解子问题、设计算法思路、考虑边界条件等步骤。OpenAI的o1系列和DeepSeek-R1将这一范式推向了新高度,通过强化学习训练模型学会何时以及如何进行深度推理。K2.7 Code强制开启思考模式,本质上是将所有编程任务都视为需要深度推理的复杂问题。
优势方面:
- 复杂代码任务、多步骤推理、架构设计场景中,思考链能显著提升准确率
- 多轮对话中可通过
preserve_thinking参数保留完整推理链,对Agent场景非常重要
劣势方面:
- 简单任务(如变量重命名、单行代码补全)也会强制输出推理链,增加延迟和成本
- 用户无法根据任务复杂度灵活选择
月之暗面表示,强制思考是为了保证代码质量的一致性。如果不需要思考模式,用户可使用K2.6或在Kimi Code客户端中切换模型。
编程模型竞争格局:K2.7 Code处于什么位置?
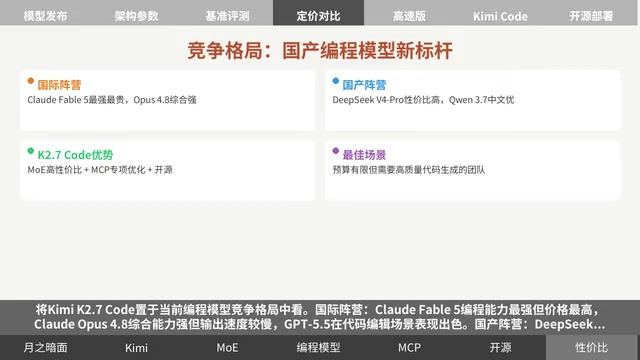
将K2.7 Code置于当前编程模型竞争格局中来看:
国际阵营:
- Claude Fable 5:编程能力最强,但价格最高
- Claude Opus 4.8:综合能力强,但输出速度较慢
- GPT 5.5:在代码编辑场景表现出色
国产阵营:
- DeepSeek V4 Pro:性价比高,但编程专项能力不及K2.7 Code
- Qwen 3.7 Max:在中文、代码场景有优势
K2.7 Code的独特优势在于:MoE架构带来的高性价比、MCP工具调用能力的专项优化,以及开源权重带来的定制化空间。对于预算有限但需要高质量代码生成的团队,K2.7 Code是目前最具吸引力的选择之一。
开源协议与本地部署门槛
Kimi K2.7 Code以Modified MIT协议开放权重,可商用。MIT协议是最宽松的开源许可证之一,允许任何人自由使用、修改和商业化分发代码。Modified MIT(修改版MIT)通常在标准MIT基础上增加了一些额外条款,例如对模型用途的限制、归属要求或特定场景的使用约束。在大模型开源领域,Meta的LLaMA系列采用类似策略,通过宽松但有条件的许可证来平衡开源社区贡献与商业利益。K2.7 Code选择这一协议,意味着企业可以基于其权重进行微调和部署,但需遵守特定的附加条款。
但本地部署门槛极高:
- 全精度模型约600GB
- INT4量化后仍需约240GB显存
- 推荐推理引擎:vLLM、SGLang和KTransformers
- Ollama Cloud已上线支持
在推理引擎方面,vLLM是由UC Berkeley团队开发的高性能大模型推理引擎,其核心创新是PagedAttention技术,通过类似操作系统虚拟内存的方式管理KV Cache,将显存利用率提升了2-4倍。SGLang(Structured Generation Language)同样来自学术界,专注于结构化生成和批处理优化,在多轮对话和复杂推理场景中表现出色。KTransformers则是月之暗面参与的推理框架,针对MoE架构做了专项优化,支持CPU-GPU混合推理,可在消费级硬件上运行超大规模MoE模型。这三个引擎各有侧重,为不同部署场景提供了灵活选择。
个人开发者基本只能通过API使用,本地部署更适合有充足算力资源的企业团队。以INT4量化后的240GB显存需求为例,至少需要3张NVIDIA A100 80GB或5张RTX 4090 24GB才能勉强运行,这对绝大多数个人开发者和中小团队来说仍是不小的门槛。
选用K2.7 Code前需了解的局限
在决定是否采用K2.7 Code之前,以下几点局限值得关注:
- 评测可信度待验证:所有基准成绩均为自报,需等待SWE-Bench等第三方评测
- 仅限编程场景:非编程任务建议继续使用K2.6
- 上下文窗口限制:256K不及Claude的1M,处理超大型代码库时存在差距。以典型的中大型项目为例,一个完整的React前端项目源码可能达到50-100万Token,256K窗口意味着模型一次只能"看到"项目的四分之一到二分之一,而Claude的1M窗口则可以容纳大部分项目全貌
- 强制思考模式:简单任务会增加不必要的延迟
总结:高性价比编程模型的有力竞争者
Kimi K2.7 Code代表了国产编程大模型在性价比维度上的一次重要突破。推理Token消耗降低30%、输出价格仅为国际顶级模型的六分之一到七分之一,加上开源可商用的策略,使其成为中小团队和成本敏感型开发者的有力选择。
不过在实际采用前,建议等待独立第三方评测结果,并根据自身场景(任务复杂度、上下文长度、速度需求)综合评估,再做出最终决策。
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。