Kimi K2.7 Code开源 | 国产图像模型HiDream登顶全球榜单

AI代理工具链集中爆发:三个开源项目重塑开发工作流
随着 AI 代理(Agent)逐步渗透实际开发场景,工具链碎片化成为新的痛点。所谓 AI 代理工程化,是指将大语言模型从单次问答的交互模式,升级为能够持续执行多步骤任务、调用外部工具、并在真实环境中产生副作用的自主系统。不同代理框架(如 LangChain、AutoGen、CrewAI)各自定义了工具调用协议,导致开发者需要为每个框架重复适配相同的外部服务——这正是近期一批开源项目试图解决的核心矛盾。
OpenCLI 是一个能把任何网站变成命令行工具的开源项目,核心创新在于让 AI 代理直接复用用户已登录的浏览器会话。它通过读取结构化的 DOM 快照获取页面内容,而非依赖截图,让代理能像操作本地工具一样精确地与网站交互。
DOM(文档对象模型)是浏览器将 HTML 解析为结构化树形数据的标准接口,包含元素的层级关系、属性和文本内容。相比截图,DOM 快照具有确定性——同一页面的 DOM 结构在不同时刻是稳定可解析的,而截图则依赖计算机视觉模型去"看懂"像素,容易因布局变化、分辨率差异或动态内容而失效。这也是为什么基于 DOM 的自动化测试框架(如 Selenium、Playwright)在工程领域长期占主导地位。对 AI 代理而言,DOM 快照意味着更低的推理成本、更高的可靠性,以及无需额外视觉模型的轻量部署。开发者可以为任意网站快速构建确定性接口,将不可靠的浏览器操作转化为可重复的自动化工作流。
OpenDesign 0.10.0 瞄准 AI 代理时代的设计场景,将素材发现、交互编辑、导出等环节整合进一个本地应用,据介绍支持 259 款技能和 142 套设计系统。它让 CLI 和本地 AI 代理成为设计引擎,直接输出带真实 CSS 和组件的可交付成果,缩短了从创意到交付的链路。

终端优先的编码智能体
CodeWell 是一个集成 DeepSeek广告 与 MiMo 模型的终端编码智能体。它在终端内构建了本地优先的智能体环境,能处理复杂的身份和权限嵌套,并通过本地证据循环确保工作流连贯性。所谓"本地证据循环",是一种让 AI 代理在执行过程中持续验证中间状态的机制:通过将每一步的输出(命令执行结果、文件变更、错误信息)反馈回模型上下文,形成"行动→观察→推理→再行动"的闭环。这与 OpenAI 的 ReAct 框架和 Anthropic 工具调用协议所共同遵循的设计原则一脉相承——在终端场景中,一条命令的失败往往需要代理感知错误码、动态调整策略,而非盲目重试。CodeWell 为命令行开发者提供更集成、更自主的 AI 编码路径。

这三个项目虽然定位不同,却共享同一个方向:把 AI 代理从一次性对话工具,升级为可嵌入现有工作流、可复用、可验证的自动化组件——这正是 Agent 工程化落地的最新趋势。
Kimi K2.7 Code开源:Token消耗降低30%,长程编程能力提升
月之暗面发布并开源了 Kimi K2.7 Code 编程模型,目前已在 Kimi Code 和 API 开放平台上线。相比前代 K2.6,最大亮点在于平均 Token 消耗减少 30%。
Token 是大语言模型处理文本的基本单位,大致对应半个到一个汉字或英文单词。在 API 计费模式下,Token 消耗直接决定调用成本;在本地部署场景中,Token 吞吐量则影响响应速度和硬件利用率。对于编程场景而言,代码补全、多文件重构等任务往往需要携带大量上下文,Token 消耗尤为突出。30% 的效率提升,对于高频调用的企业用户而言可能意味着数十万元级别的年化成本节省。这也反映了当前大模型竞争的一个新维度:在能力接近的前提下,效率和成本成为差异化的关键变量。

除效率提升外,K2.7 Code 在长上下文场景的指令遵循能力和长程编程任务性能上均有改进。跨多文件重构、复杂功能实现等长程任务,历来是编程模型的软肋——它要求模型在漫长推理链条中保持目标一致、不偏离约束。这本质上是一个"注意力衰减"问题:主流 Transformer 架构基于自注意力(Self-Attention)机制,允许模型生成每个 Token 时参考序列任意位置,但实证研究(如"Lost in the Middle"论文)表明,模型对位于上下文中间段的信息存在系统性遗忘倾向。在超长序列中,早期上下文的权重逐渐弱化,导致模型"忘记"初始需求或产生前后矛盾的代码。业界应对路径包括:旋转位置编码(RoPE)的外推扩展、滑动窗口注意力(Sliding Window Attention),以及通过强化学习(如 GRPO 方法)训练模型保持长距离指令遵循能力。K2.7 在这方面的进步,配合更低的 Token 开销,使其在开源编程模型阵营中竞争力显著增强。对于国内开发者而言,一个可自部署、成本可控的开源编程模型,实用价值很明显。
国产图像模型超越Google?HiDream登顶国际权威榜单
视觉生成赛道传来更具冲击力的消息。志向未来推出的商用图像生成模型 HiDream O1 Image 1.5,在 Artificial Analysis 文生图榜单上登顶中国模型第一。
Artificial Analysis 是一个专注于 AI 模型性能独立评测的机构,其文生图榜单综合考量图像质量、提示词遵循度、生成速度和成本等多个维度,被业界视为相对客观的参考基准。文生图模型的评测本身具有相当的复杂性:常见自动化指标包括 FID(Fréchet Inception Distance,衡量生成图像与真实图像分布的统计距离)、CLIP Score(衡量图像与文本提示的语义匹配度)等,但这些指标与人类审美判断之间存在已知的系统性偏差——例如高度锐化的图像往往获得好的 FID 分数,视觉上却可能显得不自然。Artificial Analysis 在此基础上引入了人工评分和多维度综合加权,相对更接近真实使用体验,但仍存在评测集构成和标注者偏好等方面的局限性。不同榜单的侧重点也各有差异:擅长写实风格的模型在艺术创意类任务中可能表现平平。
据报道,该模型在全球榜单上评分仅次于 OpenAI,超越了 Google、NVIDIA 和字节跳动的模型。若这一排名成立,标志着志向未来在视觉生成大模型领域已跻身全球第一梯队。
客观而言,榜单排名往往侧重特定评测维度,与真实使用体验之间可能存在差距,单一榜单第一并不完全等同于全面领先。但即便如此,一个国产商用模型在国际权威评测中压过 Google 与字节,仍是国内视觉生成技术走向成熟的重要信号。继语言模型之后,国产厂商正在图像生成这一高价值领域快速缩小与顶尖玩家的差距。
苹果Core Image RAW9:七年来最大影像处理更新
在专业影像领域,苹果于 WWDC26 上发布了 Core Image RAW9 处理管线及其 API——这是自 2017 年 RAW8 以来的首次重大更新,苹果工程师称之为「有史以来最大的一次更新」。

RAW 格式是数码相机直接输出的未经处理的传感器原始数据,包含了比 JPEG 更丰富的曝光宽容度和色彩信息,是专业摄影后期的核心素材。苹果 Core Image 的 RAW 处理管线负责将这些原始数据转化为可视图像,其算法质量直接影响细节保留和色彩还原。
新版 API 显著提升 App 图像质量,支持多达 784 款相机的 RAW 文件。值得关注的是,RAW9 针对富士 X-Trans CMOS 传感器解决了旧算法中长期存在的伪色和细节丢失问题。要理解这一修复的技术难度,需要了解传感器阵列的基本差异:标准数码相机采用拜耳(Bayer)色彩滤镜阵列,每 4 个像素中包含 1 红 1 蓝 2 绿,形成规则的 2×2 重复图案,去马赛克算法基于这一规律的周期性进行色彩插值,技术相当成熟。富士 X-Trans 传感器则采用了 6×6 的伪随机排列,理论上能减少摩尔纹和色彩噪点,但这种非标准排列使传统去马赛克算法完全失效——算法会将色彩滤镜的图案误识别为真实纹理,产生臭名昭著的"蠕虫纹"(Worm Artifacts)伪色噪点和细节涂抹。Adobe 直到 Lightroom 4.x 版本才初步解决这一问题,部分开源工具(如 dcraw)至今仍存在残留问题。RAW9 专项修复这一顽疾,表明苹果对底层传感器特性进行了深度建模和针对性重新设计,而非简单的参数调整。此次更新意味着,基于苹果平台开发的影像 App 将能提供更接近专业水准的 RAW 处理效果。
总结
综观近期进展,几条主线清晰可见:AI 代理正从对话工具走向可嵌入工作流的自动化组件;国产大模型在编程和图像生成两条战线同时突破——Kimi K2.7 Code 以效率取胜,HiDream 以榜单成绩证明实力;苹果的 RAW9 则提醒我们,底层影像处理技术的持续迭代同样不可忽视。国产模型的稳步进步,正让「硬刚 Google」从口号逐渐变为可被验证的现实。
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
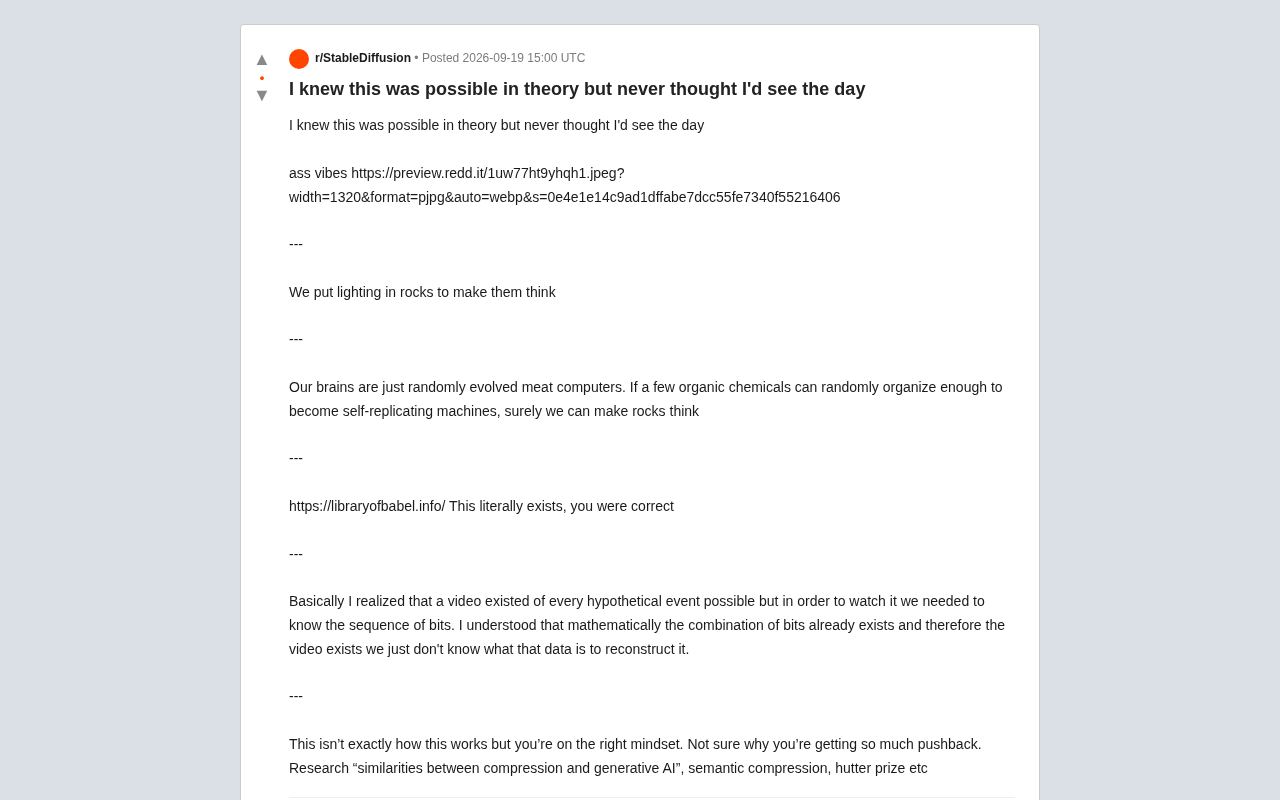
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
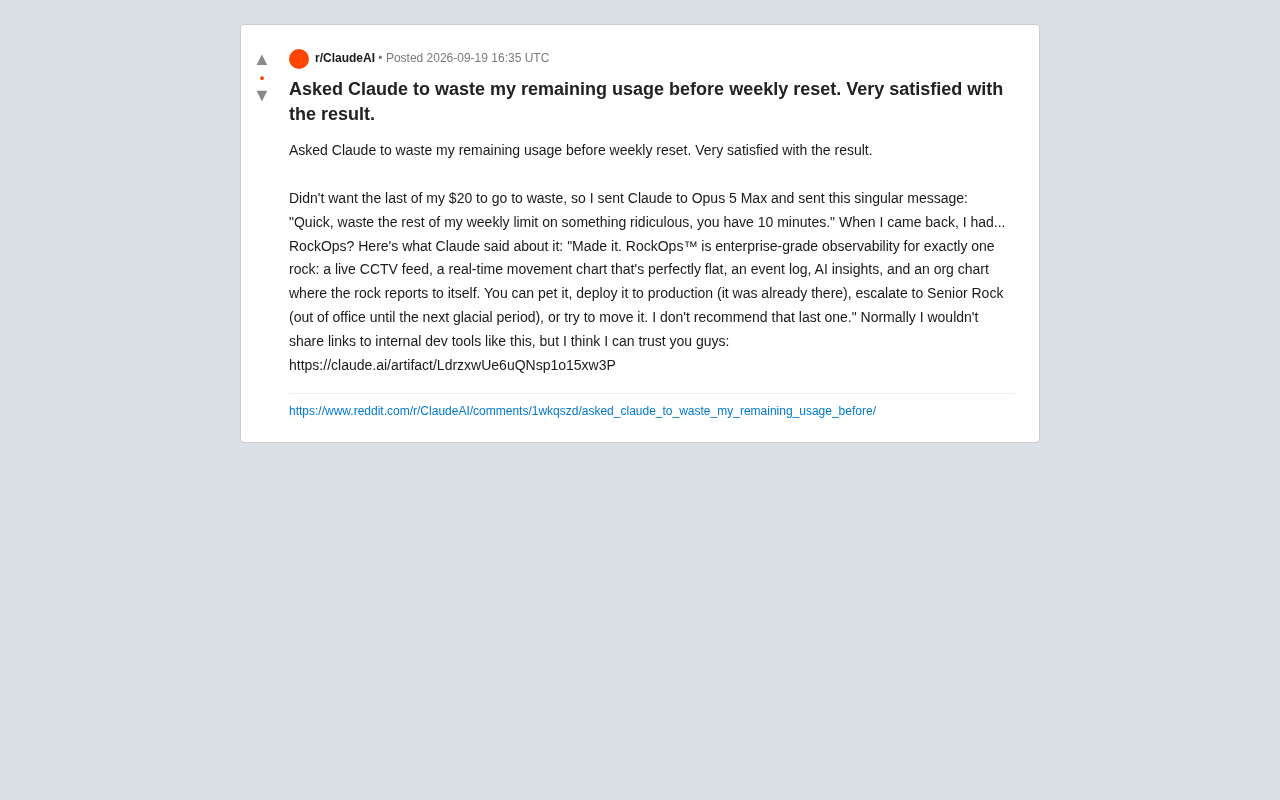
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。