Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus

Moonshot发布开源MoE模型Kimi K3.1 Pro,以三分之一成本逼近闭源前沿。
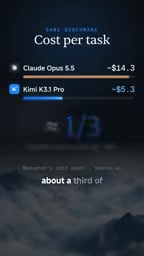
Moonshot 发布开源混合专家模型 Kimi K3.1 Pro,总参数 2.8 万亿、激活参数约 1040 亿,体量与 K3 一致,主要变化是投入更多强化学习训练。其在 Terminal Bench 4.0 上落后 Claude Opus 5.5 不到 1 分并领先 GPT-6 Astra,单任务成本约为 Opus 三分之一,API 价格为一半,开源权重计划 11 月 4 日开放。案例中模型在行走模拟停滞时回头审查模拟器,发现肩部肌肉计算 36 处错误。安全方面,Moonshot 移除网络安全训练数据,但模型解决的 exploit 任务仍是 K3 的两倍以上,显示能力外溢难以靠数据过滤压制。
开源的“准前沿”模型来了
Moonshot 正式发布 Kimi K3.1 Pro。这是一个开源混合专家(MoE)模型,总参数 2.8 万亿,激活参数约 1040 亿,体量与 Kimi K3 保持一致。真正的变化发生在训练阶段:Moonshot 在这版模型上投入了更多强化学习(RL),并声称其表现已经匹配或接近最好的闭源模型。
据 YouTube 频道对该发布的解读,Kimi K3.1 Pro 的定位很明确——用开源权重提供一个“几乎达到 Opus 水准”的选项。这个说法是否成立,可以从基准测试、成本结构和安全取舍三个维度来检验。
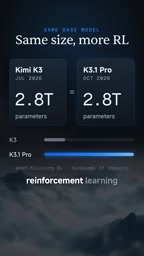
混合专家(Mixture of Experts,MoE)是一种稀疏激活的模型架构:网络中包含多个“专家”子网络和一个路由模块,每个 token 只被路由到少数几个专家进行计算。因此模型的“总参数”可以非常庞大,但单次前向实际参与运算的“激活参数”远小于总参数。以 Kimi K3.1 Pro 为例,2.8 万亿总参数中每次仅激活约 1040 亿,这使得训练和推理的算力开销更接近一个千亿级稠密模型,同时保留了大容量带来的知识存储与表达能力。MoE 的代价是显存占用高、路由均衡与训练稳定性更难处理,这也是各家实现差异较大的地方。
强化学习(RL)在这里指以可验证的任务结果作为奖励信号,对大模型进行后训练。与监督微调模仿标准答案不同,RL 让模型自己尝试多种解法、从成功与失败中学习策略,尤其擅长锻造多步规划、工具调用和错误恢复这类“过程性”能力,这正是终端操作类基准能够逼近闭源前沿模型的主要原因。
基准测试:终端任务只差不到一分
在 Terminal Bench 4.0 上,Kimi K3.1 Pro 落后 Claude Opus 5.5 不到 1 分,同时领先 GPT-6 Astra。这个成绩的意义在于:终端操作类任务对模型的规划、工具调用和错误恢复能力要求很高,历来是闭源前沿模型的优势区。一个开源模型能把差距压缩到 1 分以内,说明 RL 训练带来的提升是实质性的,而不只是跑分优化。
需要提醒的是,Moonshot 没有公布完整的分项成绩和评测配置,单点基准的领先幅度也有限。把它理解为“进入同一梯队”比“已经追平”更准确。
Terminal Bench 是一类面向命令行环境的智能体评测基准,任务通常要求在真实或沙箱化的终端中完成多步操作,例如排查配置、修复脚本、管理文件与进程。评分一般以任务是否最终达成为准,因此模型需要自行拆解目标、调用 shell 工具、读取报错并调整下一步动作,单轮问答能力不足以通过。这类基准之所以被视为前沿模型的“优势区”,是因为它同时考察长程规划、工具使用可靠性和从失败中恢复的能力,任何一环薄弱都会导致任务中断。也正因如此,不到 1 分的差距在终端任务上比在知识问答类基准上更具含金量,但同样更依赖具体的运行环境、重试次数和工具接口设计,横向比较时需留意评测配置是否一致。
成本:约为 Opus 的三分之一
Moonshot 公布的成本曲线显示,K3.1 Pro 完成单个任务的成本大约是 Opus 的三分之一。在 API 侧,它已上线 Kimi API,每 token 价格是 Opus 的一半。对于需要大量调用、对成本敏感的 Agent 工作流来说,这个价差足以改变技术选型。
开源权重计划在 11 月 4 日开放。这意味着团队可以先通过 API 验证效果,再决定是否自部署,迁移路径比较平滑。
案例:它会回头检查“模拟器本身”
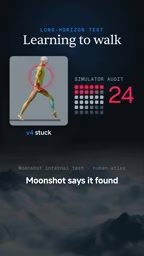
Moonshot 分享了一个有代表性的测试:让模型构建人体行走模拟。当行走效果不再提升时,模型没有继续在策略层面反复调参,而是回头审查模拟器本身的实现,最终在肩部肌肉的数学计算中找出 36 处错误。
这个行为模式值得注意。多数模型在优化停滞时倾向于在原有假设内打转,而主动质疑底层工具、把“环境可能有 bug”纳入搜索空间,是更接近人类工程师的调试策略。这也是 RL 训练强化出的行为特征之一。
安全取舍:删掉网络安全数据, exploit 能力仍翻倍
发布中最值得关注的部分是网络安全。Moonshot 在开源发布前从训练数据中移除了网络安全相关内容,原因是训练过程中模型的漏洞利用(exploit)能力持续上升。
但即便做了数据剔除,K3.1 Pro 解决的 exploit 任务数量仍是 Kimi K3 的两倍以上。据同一来源的分析,这说明两点:一是 exploit 能力可能部分来自通用推理与代码能力的迁移,而非特定领域数据的直接灌输;二是仅靠训练数据过滤,难以有效压制这类能力。
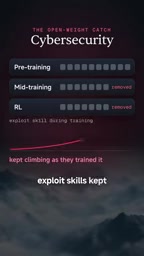
对开源模型而言,这是一个结构性难题:权重一旦开放,能力边界就不再由发布方控制。Moonshot 的做法是事前的数据治理,但结果说明这种治理的效果有限,社区需要更系统的评估与使用规范。
“能力外溢”指模型在某一敏感领域表现出色,却并非来自该领域的专门训练数据,而是通用推理、代码理解与长程规划能力迁移到该领域的结果。漏洞利用(exploit)任务恰好高度依赖阅读代码、定位缺陷、构造输入并迭代验证,这些能力与常规软件工程任务共享同一套底层技能。因此,即便在预训练与后训练阶段剔除网络安全语料,模型仍可能通过通用能力“自行拼装”出可用的攻击思路。这解释了一个看似矛盾的现象:数据过滤降低了直接知识注入,却压不住由推理能力衍生的行为,也意味着以数据为中心的治理手段存在结构性上限。
该怎么看这次发布
Kimi K3.1 Pro 的价值不在于某个单项跑分,而在于它把“接近前沿的开源模型 + 三分之一的成本”组合到了一起。对开发者来说,这意味着 Agent、终端自动化、代码修复这类高调用量的场景多了一个现实可选项。
同时也要保持清醒:基准测试覆盖有限,成本优势建立在厂商自报数据上,安全方面的能力外溢问题也尚未解决。11 月 4 日开源权重放出后,第三方复现评测会给出更可靠的答案。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。