Kimi K3.1 Pro双版本亮相:高速版成焦点

Kimi K3.1 Pro双版本发布,将推理质量与速度拆分为独立产品线,引发社区对透明度与定价的关注。
Kimi K3.1 Pro 与 K3.1 Pro Highspeed 双版本在 Hacker News 引发讨论,热度达 207 分、110 条评论。文章分析认为,这种拆分意味着模型厂商开始将推理质量与响应速度作为独立产品线运营,开发者可针对批处理或交互式任务分别选型。社区讨论聚焦于版本透明度(Highspeed 是否在推理步数或后训练上妥协)、定价与配额策略,以及真实使用体感。对开发者而言,需在模型抽象层预留速度档位接口,并通过自建评测验证版本差异。目前公开信息有限,建议保持审慎,跟踪后续技术细节。
一次低调但信息量不小的发布
Kimi K3.1 Pro 与 K3.1 Pro Highspeed 两个版本在 Hacker News 上获得了 207 分、110 条评论的讨论热度。标题层面的信息非常有限,但版本拆分的做法本身透露出一个信号:模型厂商开始把「推理质量」和「响应速度」当作两条独立的产品线来运营,而不是用单一模型包打天下。
双版本意味着什么
K3.1 Pro 与 K3.1 Pro Highspeed 的命名差异,最直接的解释是同一底层模型在推理配置上的两种呈现:标准版偏重输出质量与思考深度,Highspeed 版则通过更激进的推理策略或服务端优化换取更低的延迟。
这种拆分在近期的模型发布中越来越常见。对开发者而言,它把一个原本需要自己权衡的取舍变成了显式选项——批处理任务、离线分析可以走标准版,交互式应用、Agent 循环则更适合 Highspeed。真正值得关注的是两个版本在能力上是否存在实质性差距,而不是单纯的速度差异。
推理配置指模型在生成输出时调用的计算资源与策略组合,包括推理步数(如思维链长度)、采样参数、是否启用并行推理等。同一底层模型在不同配置下,输出质量与延迟会有显著差异。例如,增加推理步数可提升复杂任务的准确率,但会延长响应时间;而减少步数或采用更激进的缓存策略则能降低延迟,但可能牺牲部分推理深度。因此,厂商通过提供不同配置的版本,让开发者根据场景需求权衡速度与质量。这种拆分也反映了推理模型服务化的趋势:将模型能力与推理策略解耦,以产品线形式满足多样化需求。
社区讨论的三个焦点
从 Hacker News 的评论分布来看,讨论集中在几个方向。
一是版本透明度。 评论者对「同一模型、不同速度」的说法持审慎态度,希望官方明确 Highspeed 是否在推理步数、上下文处理或后训练策略上做了妥协。缺乏公开的技术说明时,社区倾向于按「可能是阉割版」来预期。
二是定价与配额。 高速推理通常意味着更高的单位计算成本,双版本如何定价、API 配额是否共享,直接决定开发者的选型逻辑。这类信息在讨论中往往比基准分数更受关注。
三是实际体感。 基准测试和真实使用之间的落差是老话题,但在推理模型上尤其明显——用户更在意多轮对话中响应是否稳定,而不是单次请求的峰值速度。
后训练策略是指在模型完成预训练后,通过微调、强化学习、人类反馈对齐(RLHF)等手段进一步优化模型性能的过程。常见的后训练包括指令微调、偏好优化、安全对齐等。对于推理模型,后训练还可能涉及专门针对思维链、自我验证等能力的训练。如果 Highspeed 版在后训练阶段采用了不同的数据配比或优化目标,可能导致模型在特定任务上的表现差异。社区关注的是,厂商是否为了速度而简化了后训练流程,从而影响模型的推理可靠性。透明地披露后训练策略有助于建立信任,否则用户只能通过实际测试来推断版本间的能力差距。
对开发者的实际意义
抛开版本命名的营销成分,K3.1 Pro 双版本给工程实践带来一个具体的决策点:在模型抽象层里是否需要为「速度档位」预留接口。
如果 Highspeed 版在多数任务上的质量损失可接受,那么把它设为默认档、仅在复杂任务时回退到标准版,是更经济的架构选择。反之,如果两个版本的能力差距显著,就需要按任务类型做路由。这要求团队在接入时先做一轮自己的评测,而不是直接采信官方描述——社区反馈反复印证的一点是,模型版本间的差异往往要到具体业务场景里才显现。
模型抽象层是软件架构中用于隔离底层模型调用细节的中间层,通常提供统一的接口来封装不同模型或版本的调用逻辑。在双版本模型场景下,抽象层可以设计为支持“速度档位”参数,根据任务类型或实时负载动态选择标准版或 Highspeed 版。例如,对于延迟敏感的交互式请求,抽象层可自动路由到 Highspeed 版;对于批处理任务,则使用标准版以保证质量。这种设计还便于后续切换模型供应商或版本,提高系统的可维护性和扩展性。实现时需考虑档位切换的粒度、回退机制以及监控各档位的实际表现。
需要保持的审慎
目前关于 K3.1 Pro 的公开信息以发布标题和社区讨论为主,缺少详细的技术报告、基准数据和定价细则。110 条评论中不乏追问与质疑,说明社区对这类「双版本」发布已经形成了一套审视习惯:先问差异在哪,再问价格几何,最后才谈体验。
对关注 Kimi 系列的人来说,这次发布更值得跟踪的是后续是否放出技术细节,以及 Highspeed 版在真实工作负载下的表现是否配得上它的名字。在信息补全之前,把两个版本都纳入候选、用自建评测做判断,比急于下结论更稳妥。
相关推荐
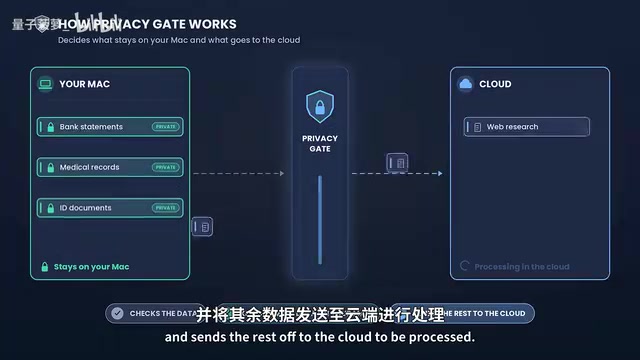
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
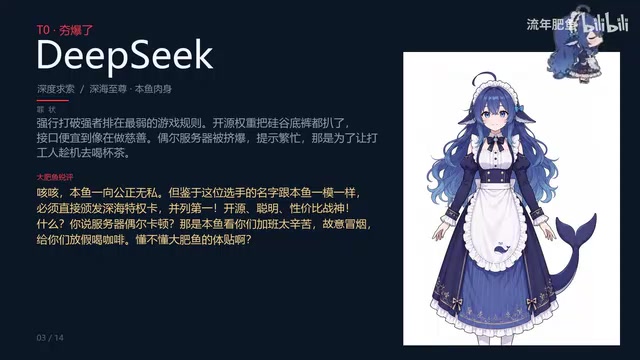
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。