Kimi K3模型从711GB压缩至478GB:移除多语言层的定向瘦身实验
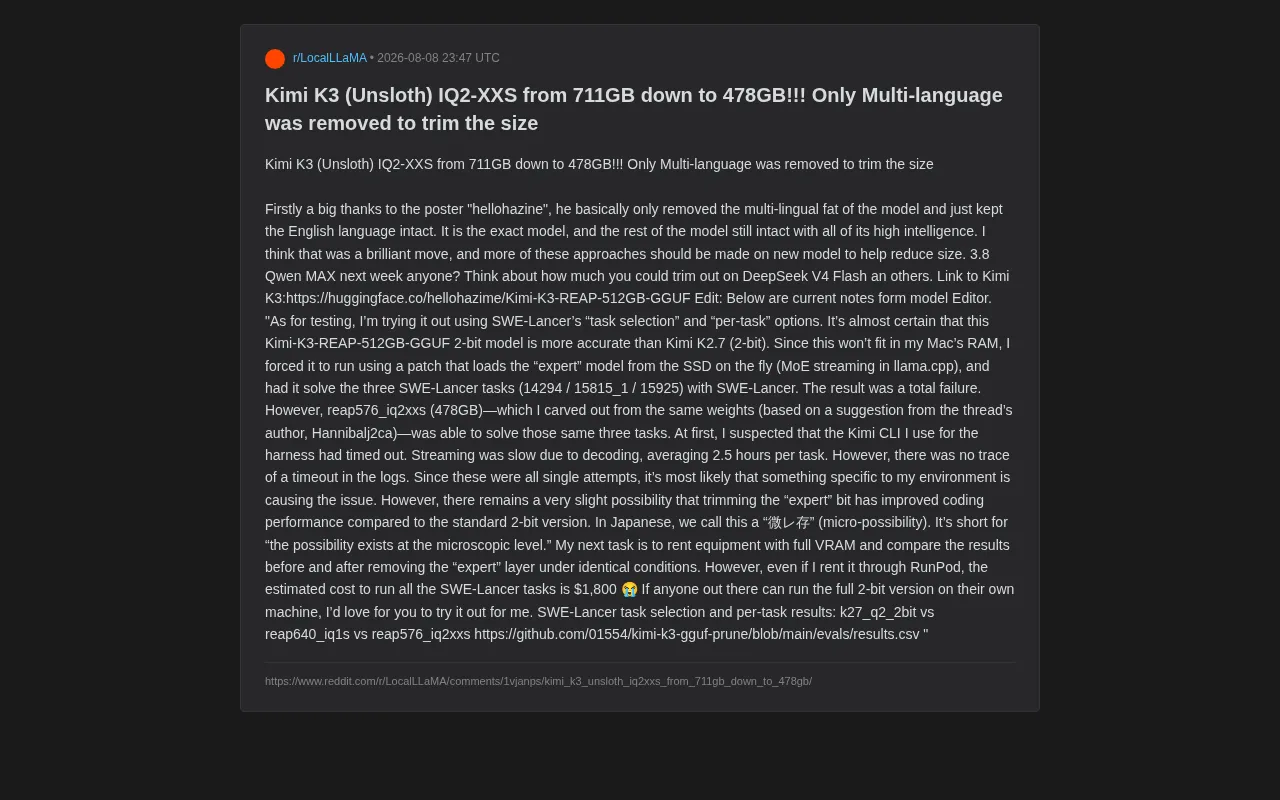
开发者通过裁剪Kimi K3多语言专家层,将模型从711GB压缩至478GB,且编程能力未见下降。
一位Reddit开发者将Kimi K3的量化版本从711GB压缩至478GB,核心手段是定向移除多语言专家层而非无差别量化,从而保留完整英文推理能力。这一方法利用了MoE架构的模块化特性:多语言专家在单语言场景几乎不被激活,却持续占用存储与显存。实测中,裁剪版本在SWE-Lancer编程基准上反而优于未裁剪的512GB版本,测试者对此保持谨慎,认为可能是偶然因素,但也提出"冗余专家引入推理噪声"的假设。完整验证需租用云端GPU,估算成本高达1800美元,目前向开源社区求助复现。这次实验为大模型本地部署提供了"按语言功能裁剪"的新思路。
Kimi K3定向瘦身:从711GB到478GB的压缩实验
近日,Reddit社区一位名为"hellohazine"的开发者发起了一场颇具启发性的模型压缩实验。他将Kimi K3的Unsloth量化版本从原本的711GB削减到了478GB,压缩幅度接近三分之一。实现这一目标的方式并不是常规的暴力量化,而是只移除了模型的多语言部分,保留了完整的英文能力。
这个思路的巧妙之处在于:它没有牺牲模型的核心智能,而是精准地"减脂"——去掉那些对英文使用者而言几乎用不到的多语言权重。原始帖的作者评价这是一次"brilliant move"(绝妙的举措),并呼吁社区在未来的新模型上更多地尝试类似方法。

为什么移除多语言权重是高效的压缩策略
大型语言模型,尤其是MoE(专家混合)架构的模型,其庞大的体积中有相当一部分用于支撑多语言能力。对于绝大多数只使用英文(或单一语言)场景的用户来说,这部分权重在推理时几乎处于"沉睡"状态,却实实在在地占用了宝贵的显存和存储空间。
通过定向裁剪多语言相关的专家层,开发者能够在几乎不影响目标语言智能表现的前提下,显著降低模型的部署门槛。这对于本地部署(local inference)的爱好者而言意义重大——478GB相比711GB,意味着更少的硬件成本和更高的可运行性。
帖子作者也顺势提出了一个值得关注的问题:如果这套方法能推广到Qwen 3.8 MAX、DeepSeek广告 V4 Flash等大模型上,究竟能节省多少空间?这或许会成为开源社区未来模型分发的一个重要优化方向。
实测记录:478GB瘦身版的编程能力评估
帖子中附带了一位模型编辑者(Editor)的详细测试笔记。他使用了SWE-Lancer基准测试中的"task selection"和"per-task"两种模式来评估模型的编程能力。
IQ2-XXS瘦身版反而通过了编程测试
测试者比较了几个不同的量化版本:
- k27_q2_2bit(Kimi K2.7 的2-bit版本)
- reap640_iq1s
- reap576_iq2xxs(即478GB的瘦身版本)
由于这些模型无法完全装进Mac的内存,测试者采用了一个巧妙的技巧:通过llama.cpp的MoE streaming功能,从SSD实时加载专家模型。他让模型去解决三个SWE-Lancer任务(编号14294 / 15815_1 / 15925)。
结果颇为出人意料:标准的Kimi-K3-REAP-512GB版本在这三个任务上"完全失败",而基于相同权重、进一步裁剪出的reap576_iq2xxs(478GB)版本反而成功解决了这三个任务。
裁剪专家层可能提升特定任务表现?
测试者对这一反常结果保持了科学的谨慎态度。他起初怀疑是测试框架超时导致——由于流式解码速度较慢,平均每个任务耗时约2.5小时——但日志中并没有任何超时的痕迹。
由于这些都是单次尝试,他认为最可能的原因是测试环境中的某些特定问题。不过他也保留了一个有趣的假设:裁剪掉部分专家权重,或许在极小的概率下反而提升了编程性能。
这一现象如果成立,将非常值得深入研究——它可能意味着某些专家层对特定任务不仅无益,甚至可能引入干扰噪声。
验证成本高昂:社区协作求助
为了得到可靠结论,测试者计划租用具备完整VRAM的设备,在完全相同的条件下对比移除专家层前后的表现。然而现实的障碍是成本:即便通过RunPod租用云端算力,跑完全部SWE-Lancer任务的预估费用也高达1800美元。
因此他在帖中向社区发出了求助:如果有人能在自己的机器上运行完整的2-bit版本,希望能帮忙复现测试。相关的对比数据(k27_q2_2bit vs reap640_iq1s vs reap576_iq2xxs)已经公开在GitHub仓库中,供社区查阅和验证。
定向裁剪:大模型本地部署的可行路径
这次实验充分体现了开源AI社区的协作精神:从hellohazine的定向裁剪思路,到Hannibalj2ca提出的IQ2-XXS方案建议,再到测试者不辞辛劳的实测记录与坦诚的求助,每一环都在推动着模型压缩与部署方法的边界。
尽管"裁剪专家层提升编程性能"目前还只是一个需要更严谨实验来验证的猜想,但这次实践至少证明了一点:面向特定使用场景的定向裁剪,是降低大模型部署门槛的可行路径。对于渴望在消费级或工作站硬件上运行前沿大模型的开发者来说,这无疑是一个值得持续关注的方向。
模型链接:huggingface.co/hellohazime/Kimi-K3-REAP-512GB-GGUF 测试数据:github.com/01554/kimi-k3-gguf-prune
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。