KITE框架:用关键层KV通信让多智能体协作更高效

KITE框架通过只传输对任务最关键的单层KV状态,让多智能体通信量减少最高36倍、准确率反而提升。
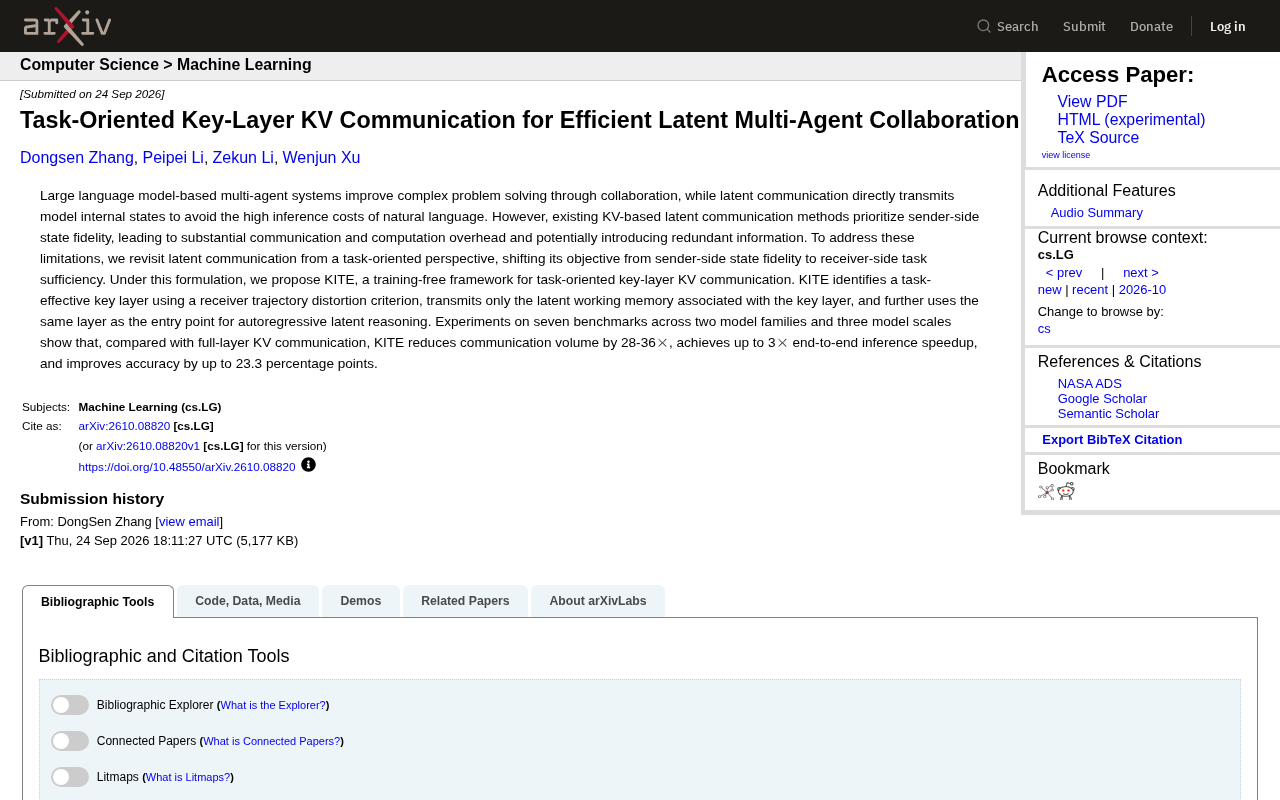
多智能体系统中智能体间的通信效率是规模化落地的核心瓶颈。现有基于KV缓存的潜在通信方案以「还原发送方状态」为目标,导致传输全部层KV带来的巨大开销,以及冗余信息对接收方推理的干扰。KITE框架将优化目标重新定义为「接收方任务充分性」,通过「接收方轨迹扭曲准则」识别出对任务最关键的单一层,只传输该层的潜在工作记忆,并以此为入口展开后续自回归推理。这一免训练框架无需修改模型,可直接部署于现有系统。实验横跨两个模型家族、三种规模、七个基准,结果显示通信量减少28至36倍、端到端推理提速最高3倍、准确率提升最高23.3个百分点,验证了「任务导向筛选」优于「信息完整传递」的核心洞见。
多智能体协作的通信瓶颈
基于大语言模型的多智能体系统,通过让多个AI模型分工协作来解决复杂问题,已经成为提升推理能力的重要路径。但协作的前提是智能体之间要有效地交换信息,而传统做法依赖自然语言传递——一个智能体把思考结果写成文字,另一个再读进去。这种方式直观,却带来了高昂的推理成本:每一轮沟通都要重新编码、解码大量token。
为了绕开自然语言的开销,研究者提出了「潜在通信」(latent communication)的思路:直接传输模型内部的隐藏状态,让智能体之间以模型「原生语言」交流。其中一种主流方案是基于KV缓存(Key-Value cache)的通信,即把发送方注意力机制中的键值状态直接传给接收方。
问题在于,现有的KV潜在通信方法大多以「发送方状态保真度」为优化目标——力求完整地还原发送方的内部状态。这听起来合理,实际却埋下隐患:传输全部层的KV状态会产生巨大的通信和计算开销,而且其中夹杂了大量对接收方任务并无帮助的冗余信息。
KV缓存(Key-Value Cache)是Transformer架构中注意力机制的核心数据结构。在自注意力计算中,每一层都会为输入序列生成键(Key)和值(Value)矩阵,用于计算token之间的注意力权重。推理时,模型会缓存已生成token的K/V状态,避免重复计算,这就是KV缓存。在多智能体通信场景下,把发送方的KV状态传递给接收方,相当于让接收方「记住」发送方处理过的全部上下文信息,而无需重新输入和处理原始文本。这种方式绕开了自然语言的token编解码开销,但代价是KV缓存的体积通常与模型层数、注意力头数和序列长度成正比——一个拥有数十层、数百亿参数的模型,其完整KV缓存的传输量相当可观。
从「保真」到「够用」的视角转换
这篇arXiv论文的核心贡献,是对潜在通信目标的重新定义。作者提出,衡量通信好坏的标准不应该是「发送方的状态被还原得多完整」,而应该是「接收方完成任务是否够用」——也就是从发送方状态保真度(sender-side state fidelity)转向接收方任务充分性(receiver-side task sufficiency)。
这个视角转换意义不小。它把一个追求信息完整的工程问题,转化成了一个面向任务目标的信息筛选问题。既然接收方真正需要的只是完成任务的关键信息,那么就没有必要传输全部层的KV状态,只需要找到并传递那些对任务最有效的部分。
基于这一思路,作者提出了KITE框架(task-oriented key-layer KV communication)。它最大的特点是「免训练」(training-free)——不需要额外的训练过程,可以直接套用在现有模型上,这大大降低了落地门槛。
KITE如何工作
KITE的工作机制可以拆成三个关键步骤。
识别关键层
大语言模型由很多层Transformer堆叠而成,每一层都有自己的KV状态。KITE并不平等对待所有层,而是通过一个「接收方轨迹扭曲准则」(receiver trajectory distortion criterion)来识别出对任务最有效的那个关键层(key layer)。这个准则衡量的是:如果缺失某层的信息,接收方的推理轨迹会偏离多少。偏离越大,说明该层越关键。
Transformer模型中不同层所承载的功能存在显著分工。研究表明,浅层(靠近输入侧)更多负责词法、句法等低层语言特征的提取,中间层负责语义组合与关系推理,而深层(靠近输出侧)则更多与任务决策和输出生成相关。这种层间功能分化意味着,对于特定下游任务,并非每一层的KV状态都同等重要。「接收方轨迹扭曲准则」的设计正是基于这一认知:通过衡量缺失某层信息对接收方推理路径的影响程度,以数据驱动的方式定位信息价值最高的层,而非依赖人工先验指定。这一机制也解释了为何不同任务、不同模型所识别出的关键层位置可能有所不同。
只传关键层的工作记忆
找到关键层之后,KITE只传输与该层相关的潜在工作记忆(latent working memory),而不是全部层的KV。这是通信量大幅压缩的直接来源——只搬运真正有用的那一部分。
以关键层为入口进行潜在推理
更巧妙的是,KITE把同一个关键层作为自回归潜在推理(autoregressive latent reasoning)的入口点。接收方从这一层开始展开后续的推理过程,既利用了传入的信息,又保持了推理的连贯性。
实验结果:又快又准
KITE的效果通过跨越两个模型家族、三种模型规模的七个基准测试得到了验证。与传输全部层KV的方案相比,结果相当亮眼:
- 通信量减少28到36倍:这意味着智能体之间交换信息的数据量压缩到了原来的几十分之一;
- 端到端推理速度最高提升3倍:更少的数据传输和计算直接转化为更快的响应;
- 准确率最高提升23.3个百分点:这一点尤其值得玩味——压缩信息不仅没有损害性能,反而提升了准确率。
最后一条结果印证了论文的核心洞见:全层KV传输中那些冗余信息不仅浪费资源,还可能干扰接收方的判断。筛掉噪声、只保留任务相关的关键信息,反而让协作更精准。「少即是多」在这里得到了实证支持。
为什么这项工作值得关注
随着多智能体系统在复杂任务上的应用越来越广,智能体间通信的效率正成为制约系统规模化的关键因素。KITE提供了一个重要的思路:与其追求信息的完整传递,不如从接收方的任务需求出发,做有目的的信息筛选。
免训练的特性进一步放大了它的实用价值——开发者无需重新训练模型,就能把这套方法接入现有系统,获得通信、速度和准确率三方面的收益。对于希望部署多智能体协作但又受限于推理成本的团队来说,这类方法值得密切跟进。
当然,作为一篇新发布的论文,KITE的实际泛化能力、在更大规模和更多样任务上的表现,仍有待更广泛的验证。但它所代表的「任务导向潜在通信」范式,为高效多智能体系统的设计提供了一个清晰且有说服力的方向。
相关推荐

NFL为何重金押注旗帜橄榄球?安全与商业的双重博弈
NFL为何重金投资没有擒抱对抗的旗帜橄榄球?本文解析CTE脑病争议、女子体育数十亿美元市场与奥运机遇如何共同驱动联盟布局橄榄球的未来。

Asana浏览器智能体成本降76倍:GPT-6模型优化实测
Asana借助OpenAI的GPT-6 Astra模型与Codex工具,在浏览器智能体测试中将模型成本降低76倍、速度提升5倍。本文解读这一工程优化案例对企业AI落地的成本与性能启示。

@ai-sdk/vue 3.0.303 发布:依赖更新的补丁版本
@ai-sdk/vue 3.0.303 补丁版本发布,核心为依赖项同步升级,核心包 ai 升级至 6.0.303。本文解析该 Vue AI SDK 更新内容及对开发者的意义。