Kitten-TTS 2开源发布:1.58比特TTS,CPU实时运行带声音克隆

Kitten-TTS 2 开源首个 1.58 比特三值权重 TTS,纯 CPU 实时生成并支持声音克隆。
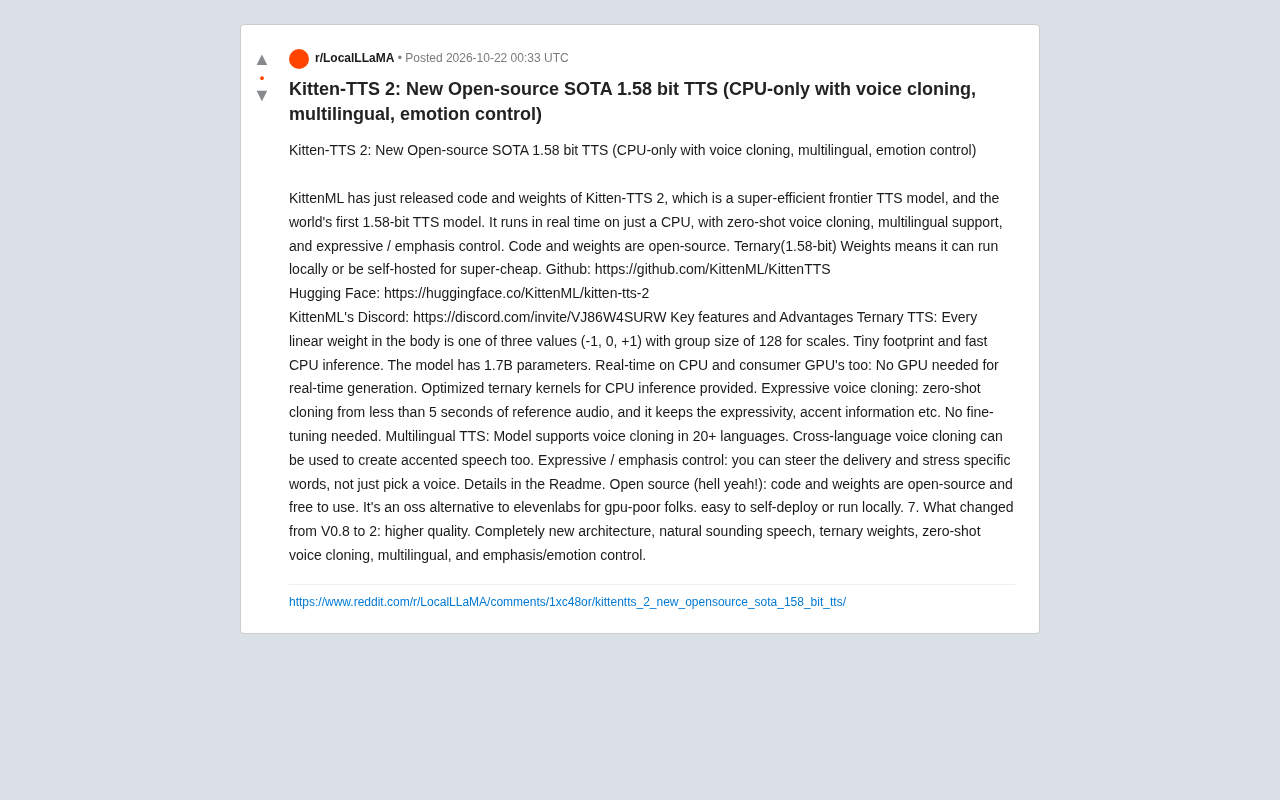
KittenML 开源了 Kitten-TTS 2 的代码与权重,这是一款号称世界首个 1.58 比特 TTS 的语音合成模型。其核心是三值权重:每个线性层权重仅取 -1、0、+1,配合 group size 128 的缩放因子,因此 log2(3)≈1.58 比特。模型参数量 1.7B,但借助优化的 ternary kernel,可在普通 CPU 上实时推理。功能上支持不到 5 秒参考音频的零样本声音克隆、20 多种语言及跨语言克隆、情感与重音控制。相比 V0.8 是完全新架构,音质和功能全面升级。它定位为 GPU 资源有限者的开源替代方案,适合低成本自托管,但音质上限仍有取舍,商用需注意参考音频授权。
KittenML 刚刚开源了 Kitten-TTS 2 的代码与权重,这是一款号称“世界首个 1.58 比特 TTS”的前沿语音合成模型。它最吸引人的地方在于:不需要 GPU,仅靠 CPU 就能实时生成语音,同时支持零样本声音克隆、20 多种语言以及情感与重音控制。对于缺少显卡资源、又想自建 TTS 服务的开发者来说,这几乎是一个“十一实验室平替”级别的选项。
三值权重:1.58 比特到底意味着什么
Kitten-TTS 2 的核心卖点是 Ternary TTS。模型主体中每个线性层的权重只取三个值:-1、0、+1,配合 group size 为 128 的缩放因子。这种三值(ternary)量化正是“1.58 比特”的由来——因为 log2(3) ≈ 1.58。
模型参数量为 1.7B,但由于权重被压到三值,实际存储和计算开销远低于同等参数量的全精度模型。KittenML 还针对 CPU 推理提供了优化的 ternary kernel,这让它在普通消费级 CPU 上也能跑出实时速度。换句话说,语音合成的硬件门槛被拉到了一个前所未有的低点。
为什么 CPU 实时很重要
过去高质量 TTS 几乎默认要挂 GPU,自托管成本高、部署链路长。Kitten-TTS 2 把推理放到 CPU 上,意味着你可以在一台普通服务器甚至笔记本上跑起语音服务,边际成本极低。对预算有限的独立开发者和小团队,这是实打实的生产力变化。
三值量化与分组缩放是理解 1.58 比特的关键。传统量化把权重映射到更多离散档位(如 8 比特的 256 档),而三值量化只保留 {-1, 0, +1} 三种取值,每个权重理论上只需 log2(3)≈1.58 比特表示。但三值权重表达力有限,因此需要配合缩放因子(scale):模型把权重按固定大小的组(此处 group size 为 128)划分,每组共享一个浮点缩放因子,实际计算时用三值权重乘以该因子还原幅度。这种“分组量化”在压低存储的同时保留了一定的动态范围,是低比特大模型常用的折中方案。
Ternary kernel 指专门针对三值权重优化的计算内核。由于权重只有三种取值,乘法可以退化为加法、取负或置零,从而避开浮点乘加运算,大幅降低 CPU 上的计算开销。这也是 Kitten-TTS 2 能在消费级 CPU 上实时推理的底层原因。
声音克隆与多语言:5 秒参考音频即可复刻
Kitten-TTS 2 支持零样本声音克隆:只需不到 5 秒的参考音频,就能克隆目标音色,并且保留原声的表达力、口音等信息,无需任何微调。这一点在开源 TTS 里属于比较靠前的水平。
多语言方面,模型支持 20 多种语言的声音克隆。更有意思的是跨语言克隆——你可以用一段中文参考音频去合成英文语音,从而生成带口音的语音效果。对于需要多语种内容分发的场景,这种灵活性省去了为每种语言单独找音色的麻烦。
情感与重音控制
除了选音色,Kitten-TTS 2 还允许你“导演”语气:可以引导整体表达风格,也能对特定单词加重强调。具体用法在项目的 Readme 中有说明。这类细粒度控制通常是商业 TTS 的付费能力,开源模型能做到这一点,对播客、有声书、视频配音等场景很有价值。
零样本声音克隆(zero-shot voice cloning) 指模型在没有针对目标说话人做过任何微调或训练的情况下,仅凭一段短参考音频即可模仿其音色。其原理通常是让模型从参考音频中提取说话人特征(音色、口音、韵律等)作为条件输入,再据此合成新文本的语音。与需要为每个音色单独训练的传统方案相比,零样本方式无需额外训练成本,部署时只需替换参考音频即可切换音色,这也是它适合多语种内容分发的原因。
从 V0.8 到 2:一次彻底的架构重写
据发布说明,从 V0.8 到 2 并非小修小补,而是完全全新的架构。变化包括:语音质量显著提升、更自然的听感、引入三值权重、加入零样本声音克隆、多语言支持,以及情感/强调控制。可以说,V0.8 更像一个实验品,而 2 版本才是面向实际部署的完整产品。
模型以开源形式发布,代码和权重均可免费使用,托管在 GitHub 与 Hugging Face 上,社区讨论则在 KittenML 的 Discord 中进行。发布者明确把它定位为“GPU 资源匮乏者的开源替代方案”,强调易于自部署和本地运行。
TTS(Text-to-Speech,文本转语音) 系统通常包含文本前端、声学模型与声码器等环节,负责把文字转成自然语音。近年主流方案多基于神经网络,音质越高往往对算力要求越高,这也是高质量 TTS 长期依赖 GPU 的原因。Kitten-TTS 2 的定位正是在这一背景下,用三值量化与 CPU 优化内核把推理成本压到普通硬件可承受的范围。
适合谁用,以及需要注意什么
Kitten-TTS 2 最适合三类人:一是没有 GPU、想低成本自建 TTS 的开发者;二是需要多语言声音克隆的内容创作者;三是对情感控制有要求的语音应用团队。
需要提醒的是,1.58 比特量化在带来极致效率的同时,音质上限与全精度大模型相比仍有取舍空间,实际效果建议先用参考音频做小样本试听再决定是否接入生产。此外,声音克隆技术本身涉及版权与人格权问题,商用前务必确认参考音频的授权。
项目地址:GitHub(KittenML/KittenTTS)、Hugging Face(KittenML/kitten-tts-2)。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。