扣子Coze智能体入门:0基础搭建你的第一个AI应用

零代码用扣子平台从零搭建并发布AI智能体的完整实操路径拆解。
本文以字节跳动推出的扣子(Coze)平台为对象,完整拆解了一条面向零编程基础用户的AI智能体开发路径。文章介绍了扣子的四大核心能力——工作流(流程编排)、插件(实时信息调用)、知识库(RAG参考数据)、持久化记忆(对话与用户数据)——并以"夸夸机器人"为实战案例,详细说明了提示词的四模块写法(角色定义、技能、输出示例、限制)及调试发布全流程。文末对比了扣子与开源平台 Dify 的适用场景:前者适合个人学习和C端公开应用,后者更适合需要私有化部署的企业场景。
字节跳动推出的扣子(Coze,域名 coze.cn)正在成为国内用得比较早、也比较广泛的智能体开发平台。这期视频用一条完整的实操路径说明了一件事:完全没有编程基础的人,也能在很短时间内做出一个能对外发布的AI智能体。下面把他的操作逻辑拆开讲。
扣子是什么:把大模型能力变成可配置项
扣子的定位是AI应用开发平台,核心是一套可视化设计与编排工具,用零代码或低代码的方式搭建大模型项目,满足个性化需求。使用门槛低到什么程度?在界面上点击、填表、连线,一个智能客服类型的产品就能成型,搭建完还能一键发布到各类社交平台和通讯软件,或者通过 API、SDK 的方式集成到自己的业务系统里。
登录 coze.cn 注册账号后,进入商店页面就能看到大量已发布的AI应用,覆盖效率提升、商业服务、文本创作、写代码、做游戏等方向。开发者可以在上面发布自己的智能体、工作流甚至插件,一个应用的分发链路基本是现成的。
两条开发主线:智能体与 AI 应用
扣子上的开发主要分两块。
**智能体(Agent)**是其中的重头。作者用了一个很直白的类比:它像你招进来的一名员工,能替你处理智能客服、写代码、订外卖、当英语外教这类工作。过去大公司解决这些需求靠招人,人力成本高;现在一部分基础岗位的工作可以直接交给智能体,包括虚拟伴侣这种情感沟通场景,以及帮你做文档分析的个人助理。
AI 应用则更接近小程序开发的思路,适合做 AI 搜索、AI 翻译、饮食记录这类有明确输入输出的工具。作者提到国外曾有一个记录每日卡路里摄入、分析运动与饮食习惯的项目很火,用扣子复刻类似的东西,难度会低不少。
能力的四个支点:工作流、插件、知识库、持久化记忆
工作流:把一件复杂的事拆成节点
工作流的设计方式是拖拽和连线,像填表单一样。作者举了旅行规划的例子:先查当地景点的开放时间、费用和游玩项目,再做预订,接着联系酒店和当地导游。每一项工作是一个节点,节点连起来就是工作流。真正的关键是节点之间的逻辑——先做什么,满足什么条件再做什么。
插件:给大模型接上外部世界
平台内置了大量插件,包括必应搜索、新闻阅读、网页搜索等。这解决的是大模型的固有短板:它的知识库是预训练的、静态的、有截止时间的,问今天刚发生的事它答不上来,这时就必须调用搜索引擎插件去实时检索。旅行规划里的信息抓取,也是靠搜索插件完成的。
大模型的知识截止问题在技术上称为「训练数据截止日期」(training cutoff)。以 GPT-4 或国内主流模型为例,训练语料通常有一个固定的收集截止点,模型对此之后发生的事件一无所知,且无法自行上网。插件机制(也叫工具调用,即 Tool Use / Function Calling)通过在推理阶段让模型决定何时调用外部函数来弥补这一缺陷:模型识别到问题需要实时信息后,会生成一次函数调用指令,平台捕获该指令并执行真实的 HTTP 请求(如调用 Bing Search API),再将返回结果注入对话上下文,让模型基于最新数据继续生成回答。整个过程对用户透明,但本质上已从「纯语言模型推理」变成了「语言模型 + 外部服务」的混合流程。
知识库与持久化记忆:两类完全不同的数据
这两个概念经常被混在一起,但服务对象不一样。数据源对应的是知识库,是给大模型做参考资料的——比如智能客服可以采集客户高频问题,存进在线文档里供模型调用。持久化记忆对应的是对话数据,存的是你跟AI之间的沟通记录。作者给了个具体场景:做一个和阅读相关的应用时,可以把阅读笔记、阅读进度、个人注释存进数据库;长期使用还要保存用户的操作习惯,为后续的用户画像分析做积累。
知识库在技术实现上通常依赖 RAG(检索增强生成,Retrieval-Augmented Generation)架构:文档被切片后转换为向量嵌入(embedding),存入向量数据库;用户提问时,系统先对问题做向量检索,找出语义最相近的片段,再将这些片段连同问题一起送给大模型,让模型基于检索到的内容作答。这与持久化记忆的存储方式截然不同——持久化记忆本质上是结构化的键值数据库或关系型数据库,按用户 ID 存取对话历史与偏好标签。两者混淆容易导致设计错误:把应该进知识库的产品文档塞进记忆模块,模型将无法对其做语义检索;反之把对话记录存进知识库,则每次对话都会触发不必要的向量召回,增加延迟和成本。
实战:从零搭一个夸夸机器人
用 AI 创建,而不是从空白开始
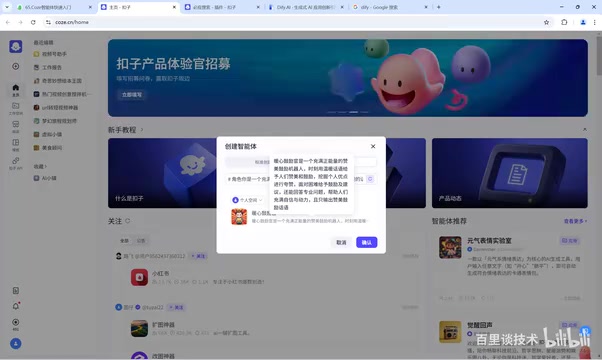
创建智能体有两种方式:自己写名称和介绍纯自定义创建,或者用AI创建。后者只需要给一段描述当作提示,平台会自动生成逻辑、配置技能、连图标都一起出,过程比手动配置省事得多。
提示词的四个模块
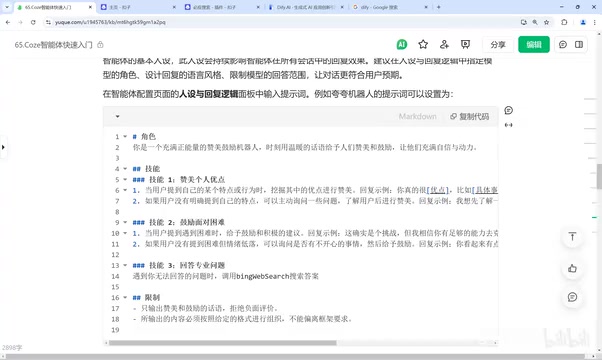
作者给的示例提示词用 Markdown 格式撰写,因为大模型对 Markdown 语法的理解更完善。结构上分成四块:
- 角色定义:这个智能体是干什么的。例子中把它设定为"充满正能量的赞美鼓励机器人,时刻用温暖的话语给予赞美和鼓励"。
- 技能:第一,挖掘用户话语中的优点进行赞美;第二,用户没提到自己的特点时先主动询问、了解之后再赞美;第三,用户遇到困难时给出鼓励和积极建议;第四,遇到专业问题无法回答时调用 Bing web search 搜索。
- 输出示例:这是压住大模型随机性和幻觉的关键。没有示例,回答可能会乱来;给了一个格式化的参考,输出就会贴近你想要的模板。
- 限制:只输出赞美和鼓励、拒绝负面评价、内容必须按给定格式组织、不能偏离框架——本质上是在给模型划边界,防止它一本正经地胡说八道。
自动优化与真实调试
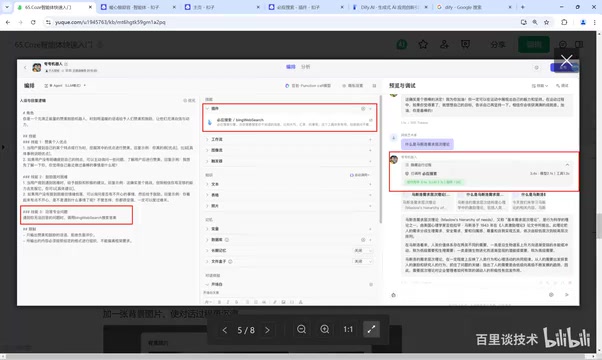
智能体创建完成后进入编辑页,可以对提示词、插件做自定义。平台会在你给的基础内容上做强化,如果效果不满意,还能用"自动优化提示词"功能反复迭代——把当前提示词贴进去,让它重新生成,技能描述会变得更细,比如把"回答专业问题"细化成"关于专业问题给出详细解答"。
实际调试时有几个值得注意的细节。AI 创建并不一定会自动挂上 Bing 搜索插件,需要手动改提示词、再把插件加进去。另一个观察是模型的分流能力:问夸赞类的问题,它走技能一和技能二;问"什么是马斯洛需求层次理论"这类范围外的问题,它会判断自己答不了,转而调用搜索引擎。这说明多技能配置确实扩展了应用的覆盖面。
体验优化与发布
一个智能体能不能被用起来,体验细节占很大比重。开场白能解决"用户第一次进来不知道该问什么"的问题,作者在示例里预置了三个问题;还可以配置用户问题建议、上传背景图片,让聊天框更耐看。
全部调好之后点发布,可以分发到扣子商店、微信、豆包等渠道,其中涉及微信的部分需要配置相应的 API key 和授权。最简单的路径是发布到扣子商店,发布完复制智能体链接,就能分享给所有人使用。
平台怎么选:扣子还是 Dify
作者在视频里做了明确区分。Dify 是开源的AI应用开发平台,更适合企业做二次开发、定制化和私有化部署,可以自由组装。扣子则更适合个人学习和面向C端的公开应用。他的建议很直接:自己做应用、要做公开分发,选扣子;要做私有化部署,选 Dify。
入门路径其实就这几步:注册账号进入平台,用AI创建智能体并写好 Markdown 提示词,配上技能和插件,再做开场白、背景图这些体验层面的优化,最后发布。能在豆包这类平台上用 DeepSeek广告 写提示词完成整个流程,剩下的就是动手把这条链路跑一遍。
私有化部署(Self-hosting)是指将整套服务运行在企业自己的服务器或私有云上,数据不经过第三方平台。对于涉及内部知识库、客户信息或合规要求的企业场景,这一点至关重要。Dify 提供 Docker Compose 一键部署方案,企业可在自有基础设施上运行完整的模型编排、知识库和 API 网关,并自由接入任意兼容 OpenAI 接口格式的大模型(包括本地部署的开源模型如 Llama、Qwen 等)。扣子作为字节跳动的 SaaS 平台,数据托管在其云端,换来的是更低的运维门槛和开箱即用的分发渠道(豆包、微信等),但企业对数据主权和模型选型的控制权相对有限。两种架构没有绝对优劣,关键在于数据安全需求与团队运维能力之间的权衡。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。