Krea2 本地部署:追求写实与提示词精准的组件搭配思路

RTX 3090用户探讨Krea2工作流中如何平衡提示词遵循度与照片级写实的本地部署方案
本文围绕一位RTX 3090(24GB显存)用户在Reddit发起的Krea2工作流求助帖展开,深入探讨本地AI图像生成中"提示词遵循度"与"照片级写实"这对经典权衡。文章指出,写实效果主要取决于checkpoint训练取向、采样器选择及分块高分辨率放大链路,而提示词还原能力则依赖文本编码器架构与结构化控制手段(如ControlNet)。针对24GB显存配置,文章建议优先保障主模型完整加载、采用分块放大控制显存峰值、按需加载LoRA及控制模块,并充分利用64GB内存作为模型缓存。原帖因缺乏具体参数而复现价值有限,作者强调最优组合没有通解,需根据实际场景反复实验调优。
在 AI 图像生成领域,如何在有限的硬件条件下,兼顾照片级写实与提示词高度还原,一直是本地部署玩家最关心的话题之一。Reddit 上一位使用 RTX 3090(24GB 显存)搭配 64GB 内存的用户,就 Krea2 相关工作流的组件搭配发起了讨论。虽然原帖信息有限,但它折射出一个具有普遍性的技术命题,值得展开分析。
原帖背景:一个典型的本地生成场景
发帖者的诉求很直接——在使用 Krea2 相关模型时,寻找一套组件组合,以实现最佳的提示词遵循度(prompt adherence)和照片级写实效果(photo-realism)。其硬件配置为:
- 显卡:RTX 3090,24GB 显存
- 内存:64GB RAM
这套配置在消费级本地推理中属于中高端水平,24GB 显存足以运行大多数主流扩散模型及其高分辨率工作流,但在加载多个大模型、LoRA 及高分辨率放大链路时仍会触及上限。
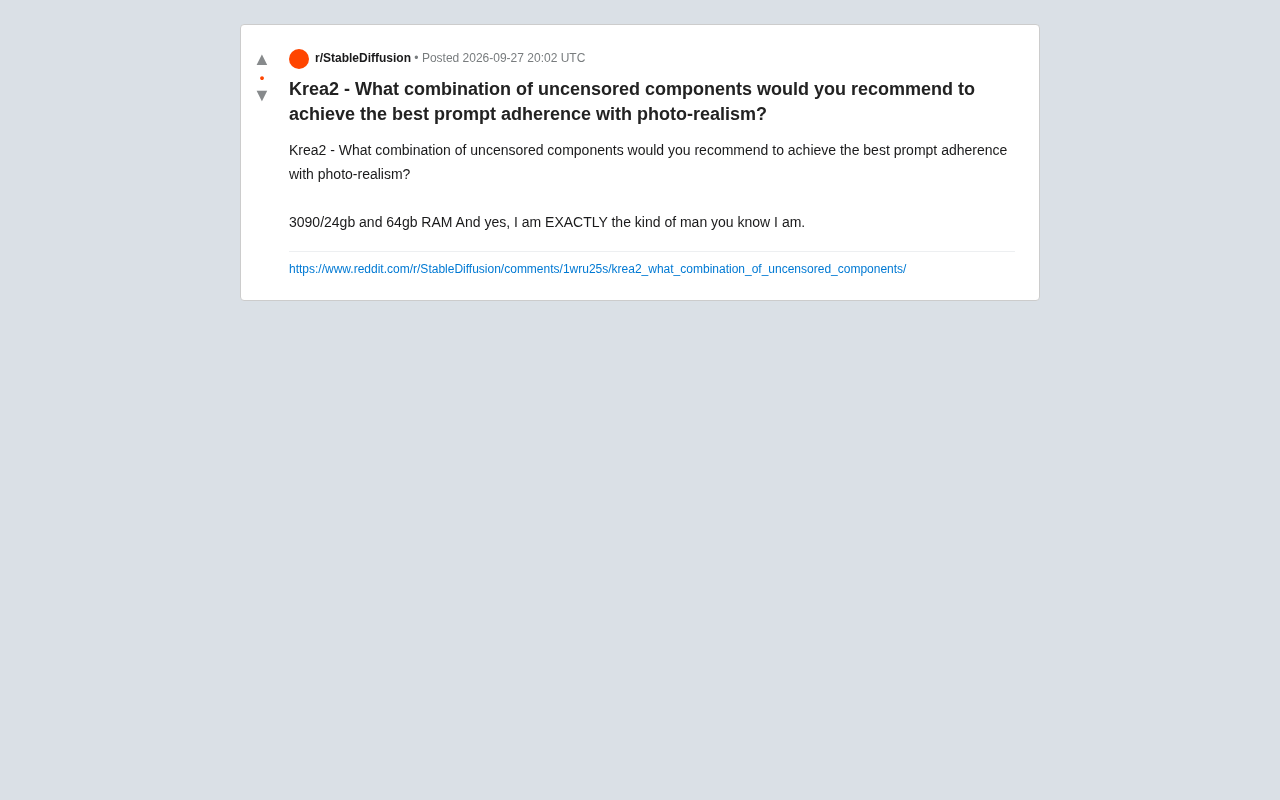
需要说明的是,原帖并未给出具体的模型清单或参数配置,更多是一次开放式的社区求助。因此本文更多是围绕这一命题,梳理本地写实生成中影响画质与提示词还原的关键因素。
提示词遵循度与写实:一对需要平衡的目标
很多本地玩家会发现,提示词遵循度和写实感并不总是同向提升的。一些高度写实的模型(尤其是经过大量真实照片微调的 checkpoint),在渲染皮肤质感、光影层次上表现出色,但对复杂提示词的理解能力可能弱于原生大模型。
影响提示词遵循度的因素
提示词遵循能力主要取决于底层模型的文本编码器与训练数据。使用更强的文本理解模块、或引入结构化控制(如 ControlNet、区域提示)通常能显著改善构图与语义还原。对于追求精准控制的用户,工作流层面的编排往往比单纯换模型更有效。
文本编码器是决定提示词遵循度的核心组件。以扩散模型的演进为例,早期 SD 1.x 使用 CLIP ViT-L 作为文本编码器,词汇量和语义理解能力有限,对复杂句式和多概念组合的处理容易出现语义漂移;SD XL 引入了双编码器架构(CLIP ViT-L + OpenCLIP ViT-bigG),显著提升了长提示词的语义捕捉能力。Flux 等更新的架构则进一步引入 T5-XXL 这类大型语言模型作为编码器,使模型对自然语言描述的理解能力接近大语言模型水平,从而大幅改善构图逻辑、属性绑定(如"红色的帽子"而非"红色和帽子")等场景下的还原精度。ControlNet 等结构化控制方案则是在语义之外增加了空间约束,两者分别解决"理解你说什么"和"在哪里放什么"的不同问题。
影响写实质感的因素
写实效果更多依赖于 checkpoint 的训练取向、采样器选择,以及后期放大链路。合适的采样步数、去噪强度,以及基于 tile 的高分辨率放大,能在保留细节的同时避免塑料感。
基于 tile 的高分辨率放大(Tiled Upscale)是本地写实工作流中的关键环节,其原理是将大图切分为若干重叠小块,分别进行低去噪强度的扩散重绘,再无缝拼合。这一方法允许在不突破显存上限的前提下处理 2K、4K 等高分辨率图像,同时能在放大阶段补充皮肤毛孔、布料纤维等微观细节,避免直接双线性放大带来的糊感。常用工具如 ComfyUI 的 Ultimate SD Upscale 节点或 A1111 的同名脚本均实现了这一流程。去噪强度(denoising strength)的选取至关重要:过高会破坏原始构图,过低则细节增益有限,0.2–0.4 是多数写实场景的经验区间,具体值需依据原图分辨率与目标倍率调整。
采样器的选择同样影响写实质感。DPM++ 2M Karras、DPM++ SDE Karras 等调度器在步数较少时仍能产出细节丰富、噪声分布自然的结果,而 Euler a 在低步数下随机性较强,适合探索多样性但不利于稳定复现。
24GB 显存下的资源分配建议
对于 3090/24GB 这样的配置,核心思路是在显存预算内合理编排工作流:
- 优先保证主模型完整加载,避免频繁在显存与内存间交换;
- 高分辨率放大采用分块(tiled)方式,降低单次显存峰值;
- LoRA、附加控制模块按需加载,避免一次性叠加过多;
- 64GB 内存可作为模型缓存缓冲区,减少反复读盘带来的延迟。
合理的显存管理,往往比盲目追求更大的模型更能带来稳定的产出体验。
24GB 显存在当前主流工作流中的实际瓶颈往往出现在高分辨率一次性生成和多模型同时驻留两个场景。以 SDXL 为例,基础模型本身约占 6–7GB 显存,若同时加载 Refiner 模型、多个 ControlNet 权重(每个约 1.4GB)和高精度 VAE,叠加后峰值显存很容易超过 20GB。ComfyUI 等现代前端支持模型按需加载与卸载,可以通过流水线编排避免多模型同时驻留。对于 Flux 等参数量更大的模型(完整版约 23GB),则需要开启 FP8 或 NF4 量化才能在 24GB 内稳定运行,但量化会带来一定的细节损失,需在显存约束与画质之间权衡。64GB 的系统内存在此场景下的主要作用是充当模型权重的内存缓存,避免每次切换模型时重新从磁盘读取,对 NVMe SSD 用户的提速效果相对有限,但对机械硬盘用户则意义显著。
社区讨论的价值与局限
这类求助帖的价值在于,它反映了本地生成社区对可控性与画质双重诉求的真实需求。不过,由于原帖缺乏具体的组件名称、参数与生成样例,其提供的可复现信息相当有限。
对于希望达成类似目标的读者,更务实的做法是:明确自己的主要诉求(是构图控制优先,还是质感优先),再据此选择对应取向的模型与工作流,并通过小批量测试逐步调优参数。没有一劳永逸的万能组合,最优解往往来自针对具体场景的反复实验。
小结
围绕 Krea2 的这场讨论,本质上是本地 AI 绘图长期存在的经典权衡:如何在有限硬件下,同时逼近写实质感与语义精准。RTX 3090 加 64GB 内存的配置有足够空间去做尝试,关键在于理解每个环节对最终画面的贡献,并在显存约束下做出取舍。
相关推荐

Devin年收入逼近10亿美元:AI编程热潮背后的真实账本
Cognition旗下Devin AI编程智能体年化收入逼近10亿美元,四个月翻倍,估值达480亿美元。本文解析AI编程热潮背后的真实收入、53倍估值倍数、8亿美元现金消耗与企业客户版图。
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。