宽神经网络高斯近似的有限样本界被提升为函数收敛
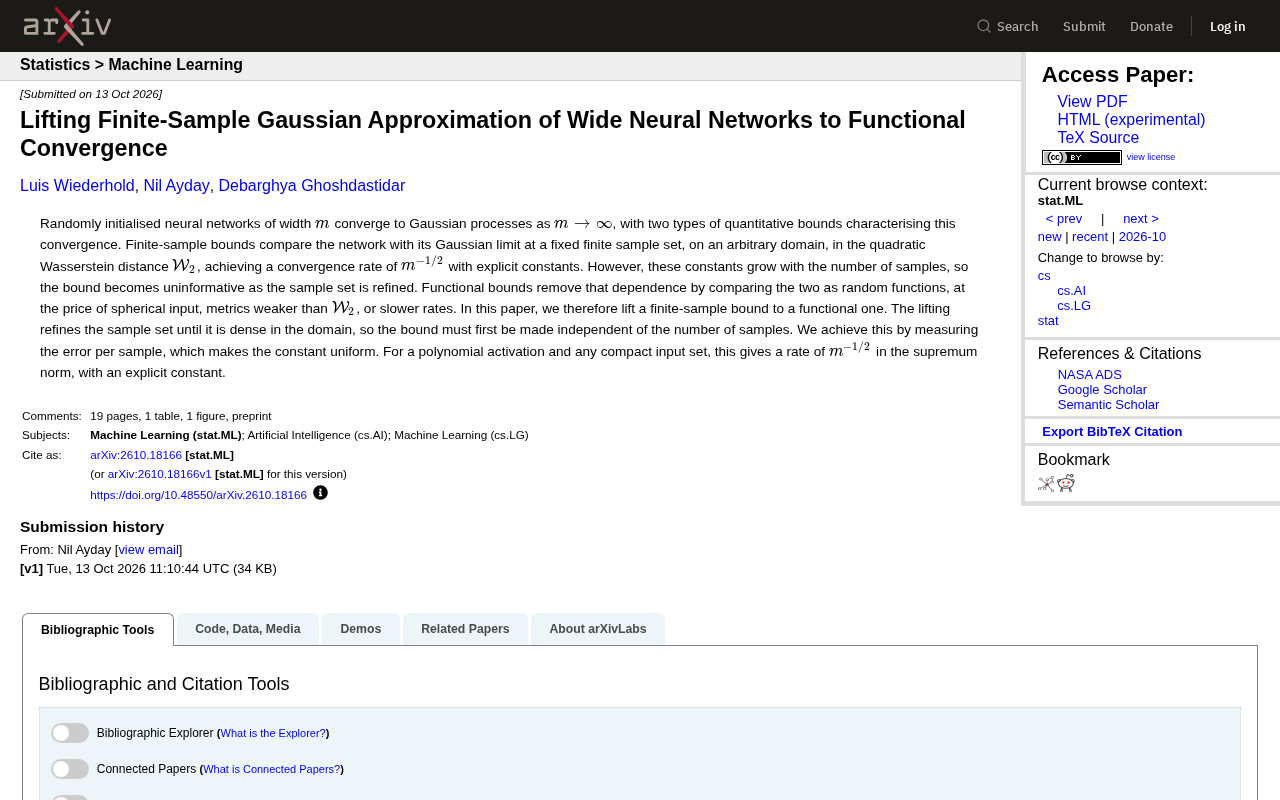
论文通过逐样本误差将宽网络有限样本高斯近似提升为函数收敛,在多项式激活与紧致域下达到 m^{-1/2} 速率且常数显式。
本文讨论了宽神经网络高斯过程近似的两类定量界:有限样本界在固定点集上以 m^{-1/2} 速率收敛,但常数随样本数增长,样本集细化后失效;函数界消除样本数依赖,但需限制球面输入、使用更弱度量或接受更慢速率。论文提出通过衡量逐样本误差,使常数与样本数无关,从而将有限样本界提升为函数界。对多项式激活函数和紧致输入集,该提升在 supremum 范数下达到 m^{-1/2} 速率且常数显式,弥合了两类界之间的鸿沟。这一技术手段可复用于其他离散到连续的收敛性分析,并为贝叶斯神经网络、神经正切核等方向提供了更紧的有限宽度刻画。
随机初始化的宽度为 $m$ 的神经网络,随着 $m \to \infty$ 收敛到高斯过程。这一结论是理解宽神经网络训练动力学与泛化行为的理论基石,但定量刻画收敛速度一直存在两条技术路线之间的张力。
两类定量界的取舍
据论文原文,现有定量界分为两类。有限样本界在固定有限样本集上比较网络与其高斯极限,适用于任意输入域,采用二次 Wasserstein 距离 $\mathcal W_2$,收敛速率为 $m^{-1/2}$,且常数显式。但原文明确指出,这些常数随样本数增长,当样本集不断细化时,界会变得无信息量。
函数界则通过将两者作为随机函数来比较,消除了对样本数的依赖。代价是必须限制球面输入、使用比 $\mathcal W_2$ 更弱的度量,或接受更慢的速率。两条路线各有牺牲:一条在固定点上精确但无法细化,另一条在函数空间上通用但条件苛刻。
高斯过程极限:当神经网络宽度 m 趋于无穷时,若权重按特定方式随机初始化(如独立同分布、方差按 1/m 缩放),网络输出的联合分布会收敛到一个高斯过程。该高斯过程的协方差函数由网络结构(激活函数、深度、初始化方案)决定。这一极限是神经正切核(NTK)理论的基础,也是理解宽网络为何能被核方法近似刻画的前提。
Wasserstein 距离:$\mathcal W_2$ 是衡量两个概率分布之间差异的度量,基于最优传输理论。对于一维或高斯分布,$\mathcal W_2$ 有闭式解;在高维下,它比总变差距离或 KL 散度更弱,但对分布的几何结构更敏感。有限样本界常用 $\mathcal W_2$ 是因为它能直接比较网络输出与高斯过程的有限维分布,且便于获得显式常数。然而,$\mathcal W_2$ 的收敛性依赖于样本点数量,当样本集稠密时,其常数会发散。
提升的核心思路:逐样本误差
论文的核心操作是将有限样本界“提升”为函数界。具体做法是细化样本集,直到它在定义域上稠密。此时界必须首先独立于样本数,否则细化过程会让常数发散。
作者通过衡量“逐样本误差”(error per sample)来实现这一点,使常数保持一致。对于多项式激活函数和任意紧致输入集,这一提升给出了在 supremum 范数下 $m^{-1/2}$ 的速率,且常数显式。这意味着函数界的通用性与有限样本界的速率和显式常数可以兼得,至少在多项式激活与紧致域的条件下。
supremum 范数:定义为 $|f|\infty = \sup{x \in \mathcal X} |f(x)|$,衡量函数在整个定义域上的最大偏差。在函数空间中,supremum 范数比 $L^2$ 或 $\mathcal W_2$ 更强,因为它要求所有点同时逼近。将有限样本界提升到 supremum 范数下,意味着网络与高斯过程的整个样本路径一致收敛,这比逐点收敛或弱收敛更强,因此也更有实用价值。但获得 supremum 范数下的收敛通常需要更精细的工具,如 chaining 或 Dudley 熵界。
紧致输入集:紧致性(在欧氏空间中等价于有界闭集)保证了连续函数的一致连续性,并使得有限覆盖引理可用。在提升过程中,紧致性允许我们用有限网格近似整个定义域,进而控制 supremum 范数下的误差。对于非紧致域,如整个 $\mathbb R^d$,一致收敛通常不成立,需要额外加权或限制增长条件。
为何这一提升值得关注
从理论角度看,这一结果弥合了两类界之间的鸿沟。此前,若想在函数层面获得 $m^{-1/2}$ 速率且常数显式,通常需要额外假设或接受更弱度量。逐样本误差的视角提供了一种可复用的技术手段:将依赖于样本数的常数转化为均匀常数。
从实践角度看,宽神经网络的高斯过程近似是贝叶斯神经网络、神经正切核等方向的理论支柱。定量界的改进直接影响对这些方法在有限宽度下行为的判断。当样本集稠密时,原先无信息量的界不再适用,而新界在 supremum 范数下依然有效,这为有限宽度与无限宽度之间的差距提供了更紧的刻画。
适用边界与开放问题
需要指出,该结果目前针对多项式激活函数和紧致输入集。对于更一般的激活函数,逐样本误差方法是否仍能给出显式常数,原文未作断言。此外,supremum 范数下的 $m^{-1/2}$ 速率是否在更弱正则性条件下保持,也留待后续工作。
这一提升本身是一个技术性较强的结果,但它所体现的思路——通过重新组织误差度量来消除样本数依赖——可能对其他需要从离散比较过渡到连续比较的收敛性分析有借鉴意义。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。