Kubrick Studio:运行AI智能体最便宜的方案?Higgsfield替代实测
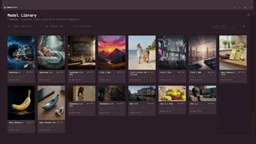
开源工具Kubrick Studio通过聚合Deep Infra低价云端模型与Ollama本地免费模型,为AI智能体提供比Higgsfield更低成本的图像视频生成方案。
Kubrick Studio是一款开源应用,以LLM为智能体大脑,通过统一连接层接入Deep Infra、OpenRouter、Ollama等多种模型供应商,核心目标是降低AI智能体驱动图像和视频生成的成本。Cloud端推荐Deep Infra,提供约100个模型、按量付费,调用CDANCE等大模型比Higgsfield更便宜,且内置消费查看和运行前价格提示;本地端推荐Ollama,在用户自己的显卡上免费运行,数据不出本机。应用内置基准测试机制,用假工具评估模型的工具调用能力并汇聚社区数据,帮助用户选择"需要最少人工干预"的模型。所有支持MCP协议的智能体(如Claude Code、Codex)均可一键接入,智能体本身的调用成本不足一美分,构成面向预算敏感和隐私优先用户的可行替代方案。
很多人把自己的AI智能体(agent)通过MCP协议接入Higgsfield来调用各类生成模型,这是业界常见的做法。但一个开源项目Kubrick Studio提供了另一条思路:用更便宜甚至免费的方式,让智能体驱动图像和视频生成。本文梳理这款工具的核心逻辑、模型接入方式,以及它相较Higgsfield的成本优势。
核心定位:开源 + 多模型接入
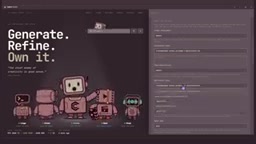
Kubrick Studio是一款开源应用,作者在视频中反复强调可以去GitHub为其加星,以支持项目持续开发。它的核心能力是把语言模型(LLM)作为"大脑",用于三类任务:改写提示词、描述图像、以及驱动智能体执行工具调用。
这里的关键设计在于——所有语言模型连接都集中在"remote → language models"下,一个入口对应五种接入选择。它不绑定单一供应商,而是把Deep Infra、OpenRouter、Ollama、自建兼容端点等整合在一起,让用户根据预算和隐私需求自由切换。这种"连接层抽象"正是它能对标Higgsfield的基础。
MCP(Model Context Protocol)是Anthropic于2024年末推出的开放协议,旨在为AI智能体提供标准化的工具调用接口。它类似于AI领域的"USB接口"——只要客户端和服务器都实现该协议,智能体就能以统一方式调用文件系统、数据库、外部API等各类工具,无需为每个服务单独编写集成代码。Higgsfield是一个主打AI视频生成的商业平台,提供多种视频模型的托管服务,但按生成次数收费,成本在规模化使用时较高。Kubrick Studio选择同样支持MCP协议,意味着任何已接入MCP生态的智能体可以无缝切换到这个成本更低的替代方案,而无需重写工作流逻辑。
Deep Infra:云端模型的性价比入口
作者推荐并主力测试的方案是Deep Infra。它的逻辑是模型跑在Deep Infra的服务器上,不占用你本地显卡的VRAM,你只为实际用量付费。接入流程很简单:在Deep Infra后台复制API Key,粘贴回Kubrick Studio后保存并测试连接,随后即可看到约100个可用模型。
值得关注的几个细节:Key粘贴后不会在界面上明文显示,安全性有保障;"Check spend"功能可查看当月消耗和剩余额度,避免账单意外。更重要的是成本——作者直言Higgsfield确实有更多模型,但像CDANCE 2.0、1.3.0这类大模型通过Deep Infra调用价格更低。VOC dance、nano banana等云端模型也直接出现在模型库里,无需下载、各自标注价格。
Ollama:完全免费的本地方案
如果追求零成本和隐私,Ollama是另一条路径。它在你自己的显卡上运行语言模型,免费、私密,本地模型的数据不会离开电脑。安装只需从Ollama.com下载即可,作者形容"这部分教程基本就这么点内容"。
在Ollama设置中可以更改模型存储位置(C盘空间小的用户很实用),而上下文长度无需手动调整,Kubrick Studio每次会自动为智能体设定。接入后在应用里选择"Ollama local"并测试,无需Key,它会自动识别所有已下载的模型。
关于模型名称里标注"obliterated"的那些——它们是去掉了拒绝机制的无审查版本。托管模型可能拒绝某些请求,而这些不会。但作者给出了一个诚实的提醒:无审查不等于更好,在他们的测试中这类模型更容易遗漏提示词中的部分要求。只有当你确实需要它才会写的内容时再选用。
Ollama是一个本地大语言模型运行框架,支持在消费级GPU上运行Llama、Mistral、Gemma等主流开源模型,屏蔽了模型加载、量化配置等底层细节,用户只需一条命令即可拉取并运行模型。其核心优势在于数据不出本机——对于涉及敏感内容或企业隐私的使用场景,本地推理从根本上消除了数据外泄风险。VRAM是关键制约因素:7B参数模型通常需要约8GB显存,13B需要约12GB,27B以上则需要24GB及以上。"obliterated"版本模型是社区通过对齐微调进行"反向操作"的变体,去除了RLHF阶段引入的拒绝行为,但这也意味着指令遵循能力可能受损,正如作者测试所揭示的那样。
智能体选型与基准测试机制
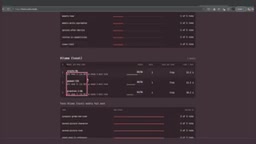
Kubrick Studio对智能体模型做了实测评分。排在前面的是经过测试的模型,各自标注分数和成本。例如DeepSeek广告 v4 flash在测试集中仅漏掉一项,而QN则对无审查请求宽松得多。
工具调用能力通过"TestToolUse"验证——确认模型能真正调用应用的工具;而"benchmark"功能会对任意选定模型跑完整测试,使用假工具(不实际生成内容)。勾选share后,仅结果会匿名上传,提示词和Key绝不外泄,所有人的结果汇总在bench.kubrick.studio。作者呼吁社区都来跑基准并分享,一个模型需要三次运行后应用才采用其分数。
硬件方面,作者坦承自己的本地测试都在一张16GB显卡上完成——"这并不是最大的卡"。拥有24GB及以上显存的用户可以尝试Gemma 4 26B,并帮忙做基准测试。他也强调评分不是及格线,而是告诉你"需要多少人工干预",且测试只覆盖智能体环节,不包括提示词改写和图像描述。
工具调用(Tool Use / Function Calling)是衡量LLM能否作为智能体"大脑"的核心指标。模型不仅要理解自然语言指令,还需要正确解析工具的JSON Schema定义,输出结构化的调用参数,并在多轮对话中追踪调用结果。不同模型在这一能力上差异显著——同等参数规模下,专门针对指令遵循和工具调用进行微调的模型(如DeepSeek系列)往往优于通用聊天模型。Kubrick Studio的"假工具"基准测试思路借鉴了学术界的离线评估方法:用模拟环境验证模型的决策逻辑,避免真实调用的成本和不确定性,同时通过社区众包扩大样本覆盖,使评分更具统计可信度。
实际运行:价格透明且可控
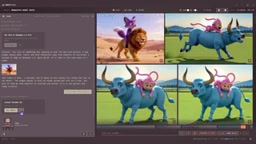
演示环节很能说明体验。作者拖入一张图片要求生成龙,智能体读取模型后,模型指南会在运行前告知价格——五美分,随后生成出片段。换用Minimax H3时,由于未安装,应用会在21GB下载前询问;他选择否,应用则改为提供已有的H3 reference模型,效果接近但不完全一致,且在本地显卡上免费运行。智能体本身的调用成本不足一美分。
显卡太小跑不动本地模型?作者还给出RunPod方案:按GPU小时付费,而非按生成次数计费,适合临时需要大算力的场景。此外麦克风听写功能也依赖Deep Infra,开启英语听写后可用任意语言说话、自动转为英文输入。
如何接入你自己的智能体
最后回到核心命题:你自己的AI智能体可以用Deep Infra的价格、或在本地显卡上免费地驱动Kubrick Studio。在设置的"connect an agent"中点击连接即可。任何支持MCP的智能体都能通过添加对应地址接入,Claude Code、Codex、Anti-Gravity等可从GitHub地址自行配置,确认后重启即可;Claude Desktop则需手动下载扩展并拖入设置。接入后智能体能在项目中生成图像和视频,付费模型会先询问,且它无法删除你的项目或扣款卡。
总体评价
Kubrick Studio代表了一种务实的开源思路:不追求模型数量上压过Higgsfield,而是通过聚合Deep Infra的低价云端模型与Ollama的免费本地模型,把"运行AI智能体"的成本压到最低,并用透明的价格提示和社区基准测试建立信任。对于预算敏感、重视隐私或希望自建智能体工作流的用户,它提供了一个值得尝试的替代方案。需要注意的是,本地无审查模型在质量上有折中,大模型云端调用仍需按量付费,用户应结合自身硬件和需求做选择。
相关推荐

Anthropic 官方揭秘:Opus 5.5 的 12 条提示词新规则
Anthropic 官方发布 Opus 5.5 提示词指南,涵盖 effort 默认档位、缓存保留、agents.md 支持、time matters 提速等 12 条实用技巧,帮你让 Claude 系统更快、成本更低。

用Claude Opus构建工具站:一个月上线130+工具并变现
本文详解如何用Claude Opus在一个月内构建并变现超过130个在线工具的网站,涵盖选题规划、框架搭建、AI代码生成、质量检查、规模化与AdSense联盟变现的完整步骤。

Claude Code Hooks完整教学:Event、Matcher、Handler三层架构详解
Claude Code Hooks完整教学,详解Event、Matcher、Handler三层架构。涵盖SessionStart、PreToolUse、PostToolUse、Stop等核心Event与五种Handler类型,附Git金钥检查、文章AI味检测实战案例及Codex差异说明。