Lakebase Postgres分支式恢复:大规模OLTP的快速恢复新思路

Lakebase Postgres用元数据级分支操作替代全量物理复制,使大规模OLTP数据库恢复时间趋近恒定。
托管OLTP数据库的恢复长期依赖"全量备份+日志回放"模式,恢复时间随数据规模线性乃至超线性增长,是高可用系统的核心痛点。Lakebase Postgres提出"分支式恢复",借鉴数据湖领域的零拷贝克隆与时间旅行理念,在底层采用写时复制机制:创建历史状态的恢复分支本质上是元数据操作,无需物理搬运全量数据,因此无论数据集多大,恢复响应时间理论上都可保持在较低且相对恒定的水平。这一思路有望打破恢复成本与数据规模之间的强耦合,使快速回滚、生产数据副本验证等操作变得廉价,进而降低架构变更、批量迁移等高风险操作的试错成本。目前具体实现细节与性能基准尚待更充分的技术披露。
托管OLTP数据库恢复的老大难问题
在托管型OLTP(联机事务处理)数据库的运维中,数据恢复一直是个让人头疼的环节。原始素材直指核心痛点:恢复操作始终缓慢,而且随着数据规模扩大,速度会变得越来越慢。
这种现象背后有其技术必然性。传统的数据库恢复往往依赖于全量备份加增量日志回放的模式。当数据集规模从GB级增长到TB乃至PB级时,恢复所需读取、复制和重放的数据量随之线性甚至超线性增长。对于需要高可用性的生产系统而言,漫长的恢复窗口意味着更长的业务中断时间,直接影响服务等级目标(SLO)的达成。
分支式恢复的设计理念
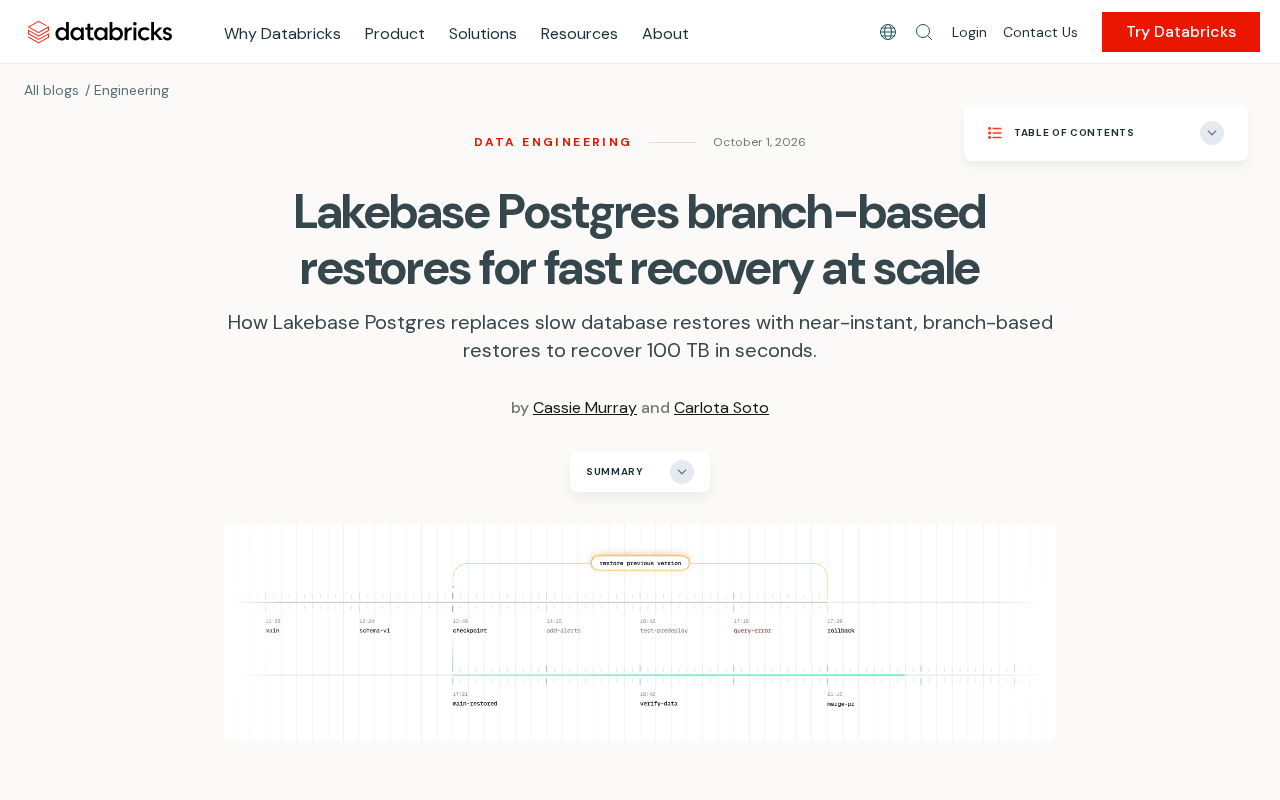
Lakebase Postgres提出的"branch-based restores"(分支式恢复)借鉴了版本控制系统中"分支"的概念。这一思路的关键在于:不再把恢复看作一次重量级的全量数据回滚,而是通过创建数据的逻辑分支来实现近乎即时的恢复能力。
在这种架构下,存储层通常采用写时复制(copy-on-write)或类似的机制。恢复一个历史状态时,系统并不需要物理复制全部数据,而是建立一个指向特定时间点快照的新分支。应用可以立即连接到这个分支并恢复运行,而底层数据的实际物化可以按需、后台进行。
这与数据湖(Lakehouse)领域近年流行的"零拷贝克隆"和"时间旅行"(time travel)理念一脉相承。Lakebase将这类云原生存储的能力引入到Postgres这一广泛使用的关系型数据库中,使得OLTP场景也能享受到快速恢复的红利。
写时复制(Copy-on-Write,CoW)是理解分支式恢复的核心机制。在CoW模型下,系统不会在写入时立即修改原始数据块,而是先复制一份再写入新内容,原始块保持不变。这意味着历史状态的数据块始终存在于存储层,无需额外备份即可被引用。创建分支时,系统只需在元数据层记录"该分支从哪个时间点的哪组数据块开始",实际数据块按需共享,新写入才触发真正的物理复制。这种机制在文件系统(如ZFS的快照)、容器镜像(Docker的层叠文件系统)以及云对象存储中均有广泛应用,Lakebase将其引入Postgres的本质是把存储引擎替换为支持CoW语义的云原生存储后端。
为什么"规模化"是关键词
标题中的"at scale"(大规模)值得特别关注。传统恢复方案的致命伤正是其成本随数据量增长而膨胀——恢复时间与数据集大小强相关。分支式恢复试图打破这种耦合关系。
由于分支创建本质上是元数据层面的操作,而非物理数据搬运,理论上无论底层数据集有多大,创建恢复分支的时间都可以保持在较低且相对恒定的水平。这对于运行着海量数据的大型生产系统意义重大:开发者可以快速回滚到问题发生前的状态,测试团队可以瞬间拉起生产数据的副本进行验证,而不必承受动辄数小时的等待。
传统Postgres的PITR(Point-in-Time Recovery,时间点恢复)流程可以作为对比参照:它依赖基础全量备份(base backup)加WAL(Write-Ahead Log,预写日志)归档,恢复时需要先还原全量备份,再串行回放从备份点到目标时间点之间的所有WAL日志。在TB级数据库上,仅还原全量备份就可能耗费数十分钟乃至数小时,WAL回放阶段同样受限于I/O和CPU处理速度。这解释了为何传统方案的恢复时间与数据集大小及WAL积累量强相关——分支式恢复绕开了这两个瓶颈,将恢复操作的复杂度从O(数据量)降为接近O(1)的元数据写入。
对数据库运维的潜在影响
分支式恢复如果成熟落地,可能会改变团队对数据库操作风险的认知。当恢复变得廉价且快速时,一些原本需要谨慎对待的操作——如架构变更、批量数据迁移、灰度实验——其试错成本会显著降低。
不过需要客观看待的是,当前公开素材信息有限,关于Lakebase的具体实现细节、性能基准数据、分支的一致性保证以及与现有Postgres生态的兼容程度等关键问题,尚缺乏更详尽的技术披露。想要全面评估其实际价值,还需等待更完整的技术文档和真实场景的实践反馈。
数据库领域将这类能力称为"沙盒化运维"(sandboxed operations)或"可逆变更"(reversible changes)。在没有快速恢复保障的传统环境中,DBA对DDL变更(如ALTER TABLE)或大批量UPDATE往往需要在维护窗口内执行,并准备详尽的回滚脚本。而当分支创建几乎零成本时,团队可以先在生产数据的即时分支上验证变更效果,确认无误后再应用到主分支,类似于代码审查中的Pull Request模式。这种工作流已在Neon(另一家云原生Postgres服务商)等产品中有所实践,Lakebase的方向与之类似,标志着数据库运维正在向"GitOps"式的可审计、可回溯范式演进。
小结
Lakebase Postgres的分支式恢复代表了数据库恢复思路从"物理复制"向"逻辑分支"的转变,试图解决托管OLTP在大规模场景下恢复缓慢的长期痛点。它将数据湖领域的快照与克隆能力带入关系型数据库,为快速恢复、低成本试错提供了新的技术路径。对于管理大型生产数据库的团队而言,这是一个值得持续关注的方向。
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。