LangChain 1.3实战入门:生态架构与Agent开发全解析

为什么要从整体生态理解LangChain
对于很多刚接触AI应用开发的人来说,LangChain往往被拆成一个个孤立的API去学习,结果听得云里雾里。本次B站教程作者采取了一种截然不同的思路——先跑通一个Hello World级别的Agent,再回过头理解整个生态。这一点在AI大模型时代尤为重要。
这里的Agent(智能体)是AI应用开发中的核心概念,指的是一个能够自主感知环境、制定计划并执行行动的AI系统。与简单的问答式大模型调用不同,Agent具备"感知-推理-行动"的循环能力:它可以判断用户意图,决定是否需要调用外部工具,执行工具后再根据返回结果进行下一步推理,直到完成任务。这种设计灵感来源于认知科学中的BDI(信念-愿望-意图)模型——其中"信念"对应Agent对当前环境的认知(如用户意图、已获取的信息),"愿望"对应需要达成的目标,"意图"则是Agent选择执行的具体计划。在工程实践中,这个循环通常被实现为ReAct(Reasoning + Acting)模式:大模型先进行推理(Thought),决定下一步行动(Action),观察行动结果(Observation),然后进入下一轮推理,直到得出最终答案。Agent的核心挑战在于如何可靠地编排这些步骤,以及如何处理中间环节的异常和不确定性——例如工具调用超时、返回结果与预期不符、或大模型产生错误的推理链等情况。
作者提出了一个值得深思的观点:在传统的Java/SpringBoot时代,掌握框架的API至关重要;但在大模型时代,具体的API调用代码本身完全可以交给AI生成。开发者真正需要重视的,不再是记住某几个API,而是理解LangChain整个生态体系的架构设计思路——即当你想构建一个应用时,应该如何整体规划实现路线和架构方案。
这也解释了为什么LangChain频繁的版本变动(从0.3到1.3)成为开发者的痛点:API改动太快会导致代码不断重写。但底层的构建思路变化其实并不大。掌握了思路,即便未来出现2.x、3.x版本也能快速跟上。

LangChain生态四大核心模块详解
新版LangChain生态由四个大模块构成,理解它们的分工是掌握整个体系的关键。
LangChain:基础组件库与链式结构
LangChain本身承担双重角色。首先它是生态底层的基础组件库,提供了与大模型交互的各种基础能力——如何调用大模型、如何聊天、如何使用工具等。这是整个生态的"地基",只有地基扎实,上层应用才能稳固。其次,它还提供了一种基于Chain链式结构构建复杂应用的实现形式,不过这种链式方式在当前用得相对较少。
从技术演进角度看,LangChain最初的核心抽象就是Chain(链)——将多个处理步骤串联成管道,前一步的输出自动成为下一步的输入。这种设计简洁直观,适合线性流程(如"检索文档→构造提示词→调用模型→解析输出")。但随着应用复杂度提升,开发者发现纯链式结构难以表达循环、条件分支等非线性逻辑,这正是LangGraph诞生的直接动因。尽管如此,LangChain作为基础组件库的地位并未被取代——它提供的ChatModel、Embeddings、VectorStore、OutputParser、Retriever等抽象接口,仍是整个生态的通用语言。
LangGraph:有状态流程编排引擎
很多人习惯把LangChain和LangGraph当作两个独立框架来看,纠结"要学哪个"。但实际上二者殊途同归,都属于同一生态。LangGraph基于LangChain的基础组件,提供了一种有状态的流程编排引擎(本质是状态图),把基础组件组合起来处理复杂业务问题。它与LangChain密不可分,无法脱离基础组件单独存在。
LangGraph所采用的"状态图"(StateGraph)是有限状态机(FSM)理论在AI应用中的工程化实现。每个节点代表一个处理步骤(如调用大模型、执行工具、格式化输出等),边代表状态转移条件。与传统的无状态链式调用相比,状态图能够天然支持循环、分支、回溯等复杂控制流。例如,一个典型的Agent执行循环可以表示为:起始节点→大模型推理节点→条件判断边(是否需要调用工具?)→工具执行节点→回到大模型推理节点,这样的循环结构在纯Chain中无法自然表达。对于需要多轮工具调用、条件判断、甚至人工介入(Human-in-the-loop,即在关键决策点暂停执行等待人类确认)的业务场景至关重要。状态图的另一大优势是可持久化——执行到任意节点都可以保存当前状态(State Snapshot),支持断点续跑和时间旅行调试(Time Travel Debugging,即回到任意历史状态重新执行)。这在长时间运行的任务、需要异步等待外部确认的场景中具有极高的工程价值。

DeepAgent:自主规划的高阶智能体
DeepAgent是LangChain 1.x大版本后新增的模块,面向现代化的高阶智能体套件,适配深度任务场景。它与传统方式有本质区别:
- LangChain/LangGraph模式:开发者预先规划好业务流程,针对特定场景把流程编排好
- DeepAgent模式:类似Manus、Claude Code、CodeX这类产品,只提供访问网页、读取本地文件、接入MCP/Skill等基础能力,任务如何处理完全由大模型自主规划判断
这两种模式的区别可以用一个类比来理解:LangGraph模式像是给AI一份详细的操作手册,每一步该做什么都有明确规定;DeepAgent模式则像是给AI一个工具箱和一个目标,让它自己决定该用什么工具、按什么顺序完成任务。后者对大模型的推理能力要求更高,但灵活性也更强——当面对未预见的新场景时,DeepAgent无需修改代码即可适应,而LangGraph模式则需要开发者重新设计流程图。
这里提到的MCP(Model Context Protocol,模型上下文协议)是Anthropic于2024年底提出的开放标准,旨在为大模型与外部数据源、工具之间建立统一的通信协议。在MCP出现之前,每个工具集成都需要编写定制化的适配代码——调用天气API是一套逻辑,查询数据库是另一套逻辑,读取本地文件又是另一套,导致生态碎片化严重。MCP通过标准化的JSON-RPC 2.0通信方式,定义了统一的工具描述格式(包括工具名称、参数schema、返回值格式等),让大模型可以像"即插即用"一样连接各种外部服务。其架构分为MCP Server(提供工具能力的服务端)和MCP Client(集成在AI应用中的客户端),两者之间通过标准协议通信。LangChain生态中的工具(Tools)机制正是这一理念在框架层面的先驱实现——@tool装饰器本质上就是在定义一个轻量级的"工具描述",供大模型理解和调用。
正是因为对传统链式思想、有状态编排、自主规划三种思路的兼收并蓄,LangChain成为目前最成熟的客户端框架之一——它在保留框架便利性的同时,也极大保留了开发的自由度。
LangSmith:工程化的可观测平台
LangSmith是一个收费的工程化平台,为大模型应用提供链路追踪、调试、评估、运维监控等能力。这个组件常被低估:简单demo或许用不上,但一旦要做严谨的商业化产品,这些产品化能力至关重要。
可观测性(Observability)是从分布式系统领域借鉴到AI应用中的工程概念。传统软件的可观测性三支柱包括日志(Logs)、指标(Metrics)和链路追踪(Traces),分别对应OpenTelemetry等标准化方案。在大模型应用场景下,可观测性面临独特挑战:由于大模型的输出具有非确定性(同一输入可能产生不同输出),且Agent可能经历多轮工具调用的复杂链路,单纯的日志记录远远不够——你需要看到完整的推理链路,理解模型为什么做出某个决策。LangSmith提供的链路追踪能力可以精确记录每一次大模型调用的输入prompt、输出内容、token消耗、延迟时间,以及工具调用的参数和返回值,并以可视化树状结构呈现整个执行链路。这对于定位"幻觉"(模型生成了看似合理但实际错误的内容)、调试工具调用失败、评估不同prompt策略的效果优劣都至关重要。LangSmith还提供了数据集管理和自动化评估功能,支持团队定义评估标准(如准确率、相关性、安全性等),对模型输出进行批量回归测试。
举例来说,你需要通过链路追踪定位问题、通过评估判断模型效果(是做陪伴玩伴还是精准的医疗机器人)、通过监控了解产品在生产环境的真实表现,甚至基于能力分级提供不同档次的服务。LangSmith最大的优势在于功能强大但接入极其简单,几乎零代码。
快速构建第一个Agent
环境与依赖安装
教程建议在学习阶段逐个安装依赖以建立体系认知,核心包为langchain和langgraph(要求Python 3.8以上,演示环境用的是3.13)。此外还需安装:
langchain-openai:针对OpenAI系列模型的扩展包langchain-community:社区维护的扩展包,访问阿里云广告通义千问时会用到
可以通过conda list | grep langchain查看当前版本(教程中为1.3.7)。
LangChain的包管理策略体现了模块化设计思想。核心包langchain-core定义了所有抽象接口(如BaseChatModel、BaseTool、BaseRetriever等),而各模型提供商的适配则拆分为独立包(如langchain-openai、langchain-anthropic、langchain-google-genai等)。这种设计的好处是:用户只需安装自己需要的提供商包,避免引入不必要的依赖;各包可以独立发版,不会因为某一家的API变动而影响整个框架。langchain-community则是社区贡献的集合包,包含大量第三方集成,但维护质量参差不齐,因此官方鼓励成熟的集成独立成包。
接入LangSmith监控
接入LangSmith监控无需编写任何代码,只需设置几个环境变量:追踪开关、自定义工程名、以及LangSmith的API Key。API Key需在官网Settings页面创建。作者还演示了工程化的最佳实践——不把敏感信息硬编码到代码里,而是通过load_key方法从keys.json配置文件中读取。
这种密钥管理方式在AI应用开发中尤为重要。一个典型的LangChain项目可能同时涉及多个API Key(大模型服务Key、搜索引擎Key、向量数据库Key、LangSmith Key等),如果直接写在代码中,不仅有安全泄露风险(尤其在开源项目中),还会导致团队协作和环境切换(开发/测试/生产)时的管理混乱。更专业的做法是使用.env文件配合python-dotenv库,或者在生产环境中使用专门的密钥管理服务(如AWS Secrets Manager、HashiCorp Vault等)。
统一方式访问主流大模型
LangChain提供了init_chat_model这一统一入口访问所有主流大模型,核心是model_provider参数(内置了DeepSeek广告、Gemini、Anthropic等主流提供商)。由于国内访问OpenAI不便,教程通过设置base_url重定向到阿里云百炼平台(dashscope兼容OpenAI的接口地址)。
阿里云百炼(DashScope)平台是阿里巴巴提供的大模型服务平台,托管了通义千问(Qwen)系列模型,包括Qwen-Turbo、Qwen-Plus、Qwen-Max等不同规格。其一大特色是提供了与OpenAI API格式兼容的接口端点,这意味着任何基于OpenAI SDK编写的代码,只需将base_url指向百炼平台的兼容地址(通常为https://dashscope.aliyuncs.com/compatible-mode/v1),并替换API Key,即可无缝切换到通义千问模型。这种兼容策略在国内大模型生态中非常普遍——DeepSeek、智谱AI(GLM系列)、月之暗面(Kimi/Moonshot)、百度文心一言、字节豆包等厂商都提供了类似的OpenAI兼容接口,极大降低了开发者的迁移成本。这种"OpenAI接口即事实标准"的现象,也是LangChain能够通过统一入口init_chat_model访问多家模型的技术基础——框架只需实现一套OpenAI格式的适配逻辑,即可覆盖绝大多数国内外大模型服务。
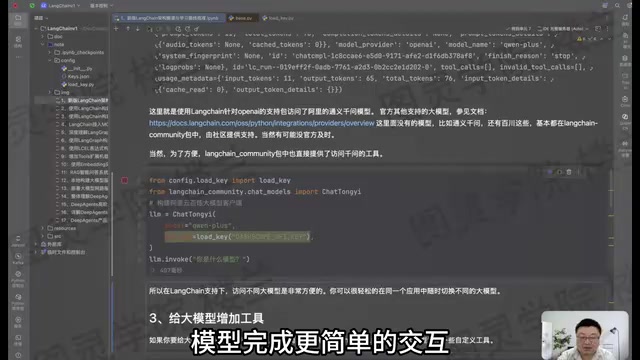
切换模型非常便利:想换模型只需改几个参数。如果网络通了要访问OpenAI,去掉base_url、换成OpenAI的Key即可;访问DeepSeek则直接改provider。此外还有更简单的封装组件如ChatTongyi(社区版),但需注意社区版可能存在版本兼容问题(目前已提示过期警告)。
工具、Agent与记忆:核心组件深度解析
工具(Tools)扩展大模型能力边界
大模型只能基于已学过的(过期的)知识回答,无法获取实时信息。以"今天几月几号"为例,直接问大模型,它返回的content是空的,但会在tool_calls中告诉你"可以调用get_current_date函数"。
这背后的技术原理是Function Calling(函数调用)机制,由OpenAI在2023年6月首次引入。其工作流程是:开发者在API请求中附带一组工具定义(包括函数名、描述、参数的JSON Schema),大模型在生成回复时会判断当前问题是否需要借助外部工具。如果需要,模型不会直接回答,而是返回一个结构化的工具调用指令(包含函数名和参数值)。需要特别注意的是,大模型本身并不执行任何代码或API调用——它只是基于自然语言理解能力,判断应该调用哪个工具、传入什么参数。实际的工具执行由客户端框架(如LangChain)负责完成。
在LangChain体系下,定义工具极其简单——只需写一个普通函数,加上描述和@tool标签即可。开发者用@tool装饰器定义的函数,其函数名、docstring描述信息和类型注解会被自动序列化为大模型可理解的函数签名(Function Calling格式的JSON Schema),大模型据此判断何时以及如何调用该工具。工具描述的质量直接影响大模型的调用准确率——描述越清晰、参数类型越明确,模型越能正确地在合适的时机调用合适的工具。这一机制也是MCP、Skill等高级能力的底层基础——无论外部能力如何包装,最终都会转化为大模型可识别的工具描述格式。
Agent自动编排完整调用流程
手动处理"调用大模型→识别工具调用→执行函数→返回结果→再次调用大模型"的流程很繁琐。而create_agent把这一切封装起来:你只需提供大模型和工具,Agent自己完成规划和消化。
整个交互过程涉及不同的消息类型:
- HumanMessage:用户发出的问题
- AIMessage(含tool_calls):大模型判断需要调用工具
- ToolMessage:工具执行的结果
- AIMessage(含内容):大模型综合工具结果给出最终答复
这种消息流转机制体现了一个重要的设计思想:大模型本身并不直接执行工具,而是通过结构化的指令告诉框架"我需要调用什么工具、传入什么参数",由框架负责实际执行并将结果以ToolMessage的形式反馈给大模型。这种"大模型决策、框架执行"的分工模式,既保证了安全性(工具执行在可控的沙箱环境中,可以加入权限校验、速率限制、超时控制等防护措施),又充分利用了大模型的推理能力。值得注意的是,一个复杂任务可能需要多轮工具调用——大模型可能先调用搜索工具获取信息,再调用计算工具处理数据,最后综合所有结果给出答复。Agent框架会自动管理这个循环,直到大模型判断已有足够信息可以直接回答为止。
提示词模板(Prompt Template)
ChatPromptTemplate是高频使用的组件,它通过大括号变量的形式把提示词模板化。例如定义一个翻译背景"把内容从英语翻译成{language}",之后只需传入Chinese或French等参数即可生成不同提示词。这让应用对外只需接收几个固定业务参数,非常接近传统应用的开发方式。
提示词模板的价值远不止于简单的字符串替换。在生产环境中,提示词工程(Prompt Engineering)是决定大模型应用效果的关键因素——同一个模型,提示词的微小差异可能导致输出质量的巨大变化。通过模板化,团队可以将提示词作为独立资产进行版本管理(纳入Git版本控制)、A/B测试(对比不同表述的效果差异)和系统化评估。LangChain的模板系统还支持多种消息角色的组合——System Message定义AI的角色和行为边界(如"你是一位专业的医疗顾问,回答必须基于循证医学"),Human Message承载用户输入,AI Message提供少量示例(Few-shot Learning,通过展示几个输入-输出样例来引导模型的输出格式和风格)。这种结构化的消息组合方式比简单的文本拼接更加可靠和可维护,也与主流大模型API的消息格式(messages数组中的role字段)天然对齐。此外,LangChain还提供了MessagesPlaceholder组件,允许在模板中动态插入对话历史,这是实现多轮对话的关键机制。

短期记忆(Checkpoint)实现多轮对话
通过InMemorySaver组件,Agent能记住同一会话的历史对话。比如先问"今天几月几号",再问"明天呢",大模型能通过上下文推断出你问的是明天的日期。开发者无需手动整合聊天记录,只需在构建Agent时指定checkpoint即可。
需要理解的是,大模型本身是无状态的——每次API调用都是独立的,模型不会"记住"之前的对话。这是由Transformer架构的推理机制决定的:模型在每次前向传播中处理输入的所有token,但推理完成后不会保留任何中间状态。要实现多轮对话的连贯性,必须在每次请求中将历史对话记录一并发送给模型,让模型通过注意力机制重新"理解"整个对话上下文。这会带来两个工程挑战:一是token消耗随对话轮数线性增长,可能超出模型的上下文窗口限制(即使当前主流模型已支持128K甚至更长的上下文,高频对话仍可能触及天花板,且更长的输入意味着更高的API费用和更慢的响应速度);二是如何在多用户、多会话场景下高效管理这些历史记录。InMemorySaver将对话历史存储在内存中,适合开发调试,但程序重启后数据会丢失;而生产环境通常需要使用持久化存储(如Redis适合高频读写的会话缓存、PostgreSQL适合长期存储和复杂查询)来保存checkpoint。更高级的记忆管理策略包括:对话摘要压缩(让模型将冗长的历史对话压缩为简短摘要)、滑动窗口截断(只保留最近N轮对话)、语义检索式记忆(将历史对话向量化存储,按语义相关性检索最相关的片段),以在有限的上下文窗口内最大化信息利用率。LangGraph的checkpoint机制还支持通过thread_id区分不同会话,实现多用户隔离。
总结:掌握架构思路比记忆API更重要
本次教程通过一个简单的日期查询Agent,串起了LangChain生态的几个核心基础组件:Model(大语言模型)、Tools(工具)、Prompt(提示词)、Checkpoint(短期记忆)。
LangChain作为应用框架,其价值在于把与大模型对接的各种复杂交互过程做了良好封装,让开发者能专注于应用本身的构建逻辑。未来构建Agent的本质,就是把这些基础能力拿出来、组装成完整的应用。掌握生态架构的思路,远比记忆具体API更重要——这正是应对LangChain频繁版本迭代的最佳策略。
从更宏观的视角来看,LangChain生态的设计哲学可以概括为"分层抽象、组合优先":底层提供标准化的原子能力(模型调用、工具定义、提示词管理、记忆存储),中层提供灵活的编排机制(Chain、Graph、Agent),上层则开放给开发者根据业务需求自由组装。这种架构思想与Unix哲学("做好一件事,通过组合完成复杂任务")一脉相承。理解了这个分层逻辑,无论框架如何迭代,开发者都能快速定位自己需要的模块,并理解新特性在架构中的位置和作用。
相关推荐

AgentCore 实战:为智能体接入自定义工具与 MCP 服务器
DebuggerCafe 教程演示如何为 Amazon Bedrock AgentCore 智能体接入自定义工具与 MCP 服务器,突破默认工具集限制,并分析工具契约设计、MCP 复用价值及扩展后的工程注意事项。

816B参数只拿39分?开源大模型参数竞赛的性价比真相
Meta 816B Muse Spark Open 在 Artificial Analysis 仅得39分,180B Qwen3.8-Flash-Next 却拿到40分。本文解析11个开源权重模型的参数与分数关系,探讨激活参数、量化体积与部署成本的真实影响。

空中机械臂:无人机从「看」到「改」的下一步
从Reddit讨论出发,分析空中机械臂(Aerial Manipulator)的技术难点、潜在应用场景与落地瓶颈,探讨无人机从环境感知走向物理操作的关键挑战。