LangChain4J实战:零基础构建企业级Agent与RAG应用

LangChain4J让Java开发者用统一抽象层把大模型接入企业私有数据与业务系统,构建私有化Agent。
文章基于B站教程,系统梳理了Java AI框架LangChain4J的核心概念与落地路径。开篇指出大模型因训练数据仅来自互联网公开信息,无法访问企业私有数据或执行外部操作,这正是LangChain4J要解决的痛点。框架通过三大概念实现能力增强:Components提供类似JDBC的统一模型抽象层,切换国内外大模型几乎不改业务代码;Chains负责把大模型、数据库、向量库、Embedding模型等组件编排成RAG等可执行流水线;Agents则让模型能与外部网站、企业数据库、CRM系统交互,TextToSQL是典型场景。文章随后给出企业级Agent的四步落地路径——环境配置、数据接入、链与代理编排、私有化部署,并提醒学习者避免过度关注调参、跳过基础直接上Agent两个误区,建议从读取本地Markdown文件的RAG小应用起步。
企业级AI应用开发正从“调API”走向“搭框架”。LangChain4J作为Java生态中备受关注的AI框架,让大模型真正接入企业私有数据与业务系统。本文基于B站教程内容,梳理LangChain4J的核心概念与实战路径,帮助零基础开发者理解如何用Java构建私有化部署的智能Agent。
为什么需要LangChain4J:大模型的能力边界
直接用OpenAI或国内大模型的API写聊天机器人,确实能实现基础对话。但企业场景远不止于此——你希望AI能读取公司内部数据库、解析本地文件,甚至根据指令自动发邮件、调用外部工具。这些需求单靠大模型API无法完成。
根本原因在于数据来源。大模型的训练数据来自互联网公开信息,而企业内部的业务数据、客户资料、专有文档从未暴露在公网。大模型“看不见”这些数据,自然无法基于它们回答问题或执行操作。LangChain4J正是为弥合这一鸿沟而生的开源框架,它允许开发者将大语言模型与外部计算资源、数据源结合起来。
据B站教程中的案例,一个典型的增强场景是:给大模型提供100篇行业论文,然后针对这些论文连续提问,最后要求AI将问答历史整理成邮件发送到指定地址。这种“有数据、有记忆、有行动”的AI产品,才是企业真正需要的。
LangChain4J三大核心组件解析
LangChain4J通过三个核心概念实现能力增强:Components(组件)、Chains(链)和Agents(代理)。理解这三者是后续实战的基础。
Components:统一的模型抽象层
组件层为大模型提供接口封装。市面上大模型众多——OpenAI、Google、国内GLM等,如果每换一个模型就要重写代码,开发成本极高。LangChain4J提供了一套抽象的驱动程序,类似JDBC驱动的工作方式:开发者面向统一接口编程,底层可切换不同大模型实现。
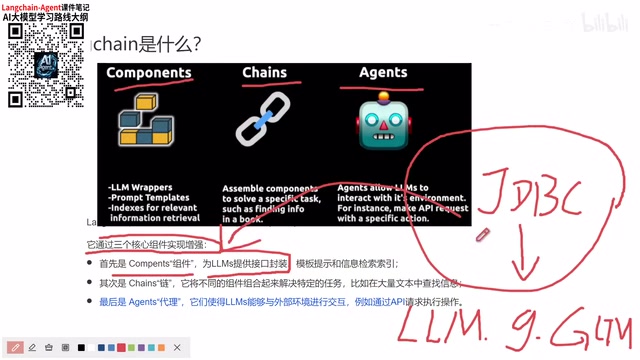
这意味着你的业务代码几乎不需要改动,就能从国外模型切换到国内模型。教程中特别强调,这一兼容能力在框架升级后进一步扩大,国内外主流大模型均已支持。对于需要私有化部署或合规要求较高的企业,这种灵活性至关重要。
JDBC(Java Database Connectivity)是Java访问关系型数据库的标准API,开发者面向统一的Connection、Statement、ResultSet接口编程,具体数据库厂商(MySQL、Oracle、PostgreSQL)通过各自的驱动实现这些接口。切换数据库时,业务代码几乎无需改动,只需更换驱动依赖和连接配置。LangChain4J的模型抽象层采用了完全相同的设计思路:定义统一的ChatLanguageModel、EmbeddingModel等接口,各模型厂商提供对应的实现模块。开发者注入接口而非具体实现,从而获得与JDBC一致的解耦收益——这也是文中“切换大模型几乎不改业务代码”的技术依据。
Chains:组件的编排者
链的职责是将不同组件组合起来完成特定任务。一个AI产品可能同时需要大模型、关系型数据库、向量数据库、Embedding模型等。链把这些分散的组件连接成一条可执行的流水线,这也是框架名称“Chain”的由来。
在实际项目中,RAG(检索增强生成)流程就是典型的链式结构:文档加载→向量化→存储→检索→拼接提示词→调用大模型。LangChain4J将这些步骤抽象为可复用的链,开发者只需关注业务逻辑而非底层胶水代码。
RAG(Retrieval-Augmented Generation,检索增强生成)是当前企业落地最广的大模型增强范式。其核心思想是:在调用大模型生成回答之前,先从企业自有知识库中检索出与问题最相关的若干文本片段,把这些片段作为上下文拼入提示词,让模型“看着资料回答”而非仅凭训练记忆作答。这带来三个直接收益:一是回答可基于私有数据,突破训练语料的边界;二是显著降低模型“幻觉”,因为答案有检索到的原文作依据;三是知识更新无需重新训练模型,只要更新向量库中的文档即可。向量化(Embedding)是其中的关键步骤——它把文本映射为高维向量,使语义相近的内容在向量空间中距离更近,从而支持按语义而非关键词进行检索。
Agents:连接外部世界的执行者
代理让大模型能够与外部环境交互。比如你希望AI分析Django官方文档,代理可以先去抓取文档内容,再交给大模型处理。这里的“外部”既包括公开网站,也包括企业内部的数据库、CRM系统、工单系统。
教程中举了一个电商场景:把京东的商品数据交给AI,构建智能客服或销售代理。代理负责从外部系统获取数据,大模型负责理解与生成,二者配合完成复杂业务动作。TextToSQL正是这一能力的典型应用——代理将自然语言问题转换为SQL查询,从数据库中提取结果,再由大模型组织成自然语言回答。
TextToSQL(自然语言转SQL)是让大模型操作结构化数据的典型技术路径。其基本流程是:将目标数据库的表结构(表名、字段名、字段类型、外键关系等schema信息)作为上下文提供给大模型,模型据此把用户的自然语言问题翻译成可执行的SQL语句,执行后再将查询结果交回模型组织成自然语言回答。该方案的价值在于让非技术人员用日常语言查询业务数据,但落地时有几个关键约束:schema信息需要精心裁剪以控制上下文长度,生成的SQL必须做语法校验与权限限制以防止误删误改,复杂多表关联查询的准确率仍然有限,通常需要配合示例(few-shot)与人工审核机制使用。
从零到一:企业级Agent的落地路径
结合教程思路,一个私有化部署的企业级Agent项目大致遵循以下路径:
- 环境与依赖:引入LangChain4J核心库,配置所选大模型的接入凭证。教程建议零基础学习者先跑通最简单的对话示例,再逐步增加组件。
- 数据接入:将企业文档、数据库表结构加载为框架可识别的格式。对于RAG场景,需要引入向量库存储文档嵌入;对于TextToSQL场景,需要提供数据库schema作为模型上下文。
- 链与代理编排:根据业务需求组合组件。客服问答走RAG链,数据查询走TextToSQL代理,多步骤任务则用代理调度工具。
- 私有化部署:选择可本地部署的开源模型或国内合规API,确保数据不出企业边界。教程强调,框架的抽象层让模型切换成本极低。
说个细节,教程将LangChain4J类比为JDBC或Spring框架——它不是大模型本身,而是让大模型融入软件工程体系的基础设施。对于Java开发者而言,这降低了进入AI应用开发的门槛:无需精通Python生态,用熟悉的工程思维就能构建生产级AI产品。
实践建议与常见误区
零基础学习LangChain4J,容易陷入两个误区。一是过度关注模型调参而忽视工程结构,实际上企业项目中模型只是链路中的一环,数据管道和错误处理往往更影响可用性。二是跳过基础直接上Agent,代理的调试复杂度远高于普通链,建议先掌握Components和Chains再进入Agent阶段。
教程中反复出现的一个观点值得重视:美国AI产品落地数量有限,大量精力集中在模型本身;而真正的机会在于结合企业自身数据,让AI完成具体、人性化的任务。LangChain4J的价值正在于此——它把大模型从“聊天玩具”变成“业务工具”。
对于准备动手的开发者,建议从官方文档的入门示例开始,先实现一个能读取本地Markdown文件并回答问题的RAG小应用,再逐步扩展向量库和TextToSQL能力。框架的抽象设计会让每一步扩展都相对平滑。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。