LangChain文档为何劝退新手?本地模型与产品推广之痛
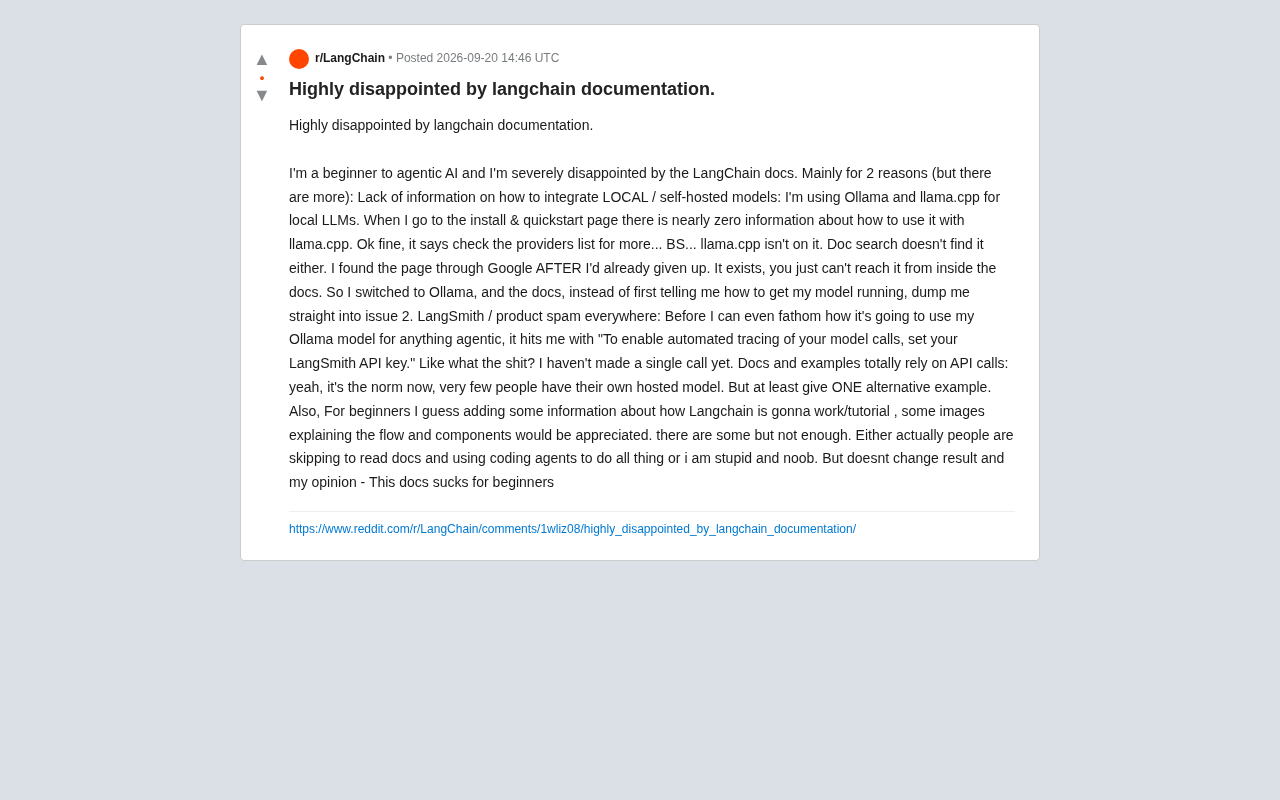
一位初学者揭示LangChain文档的四大痛点:本地模型支持隐蔽、商业产品强推、示例云端独占、概念讲解缺失。
一位Reddit用户详细记录了他在学习LangChain时遭遇的文档体验困境,指出四个具体问题:本地模型(Ollama、llama.cpp)的集成文档虽然存在,却因站内导航和搜索缺陷而实际"不可达";入门教程在用户完成首次调用之前就强插LangSmith商业服务的配置步骤;几乎所有示例均以云端API为前提,本地部署用户需自行摸索;以及缺乏帮助新手理解Chains、Agents等核心抽象的架构图与概念讲解。这些问题折射出热门开源项目普遍面临的张力:功能迭代速度碾压文档维护,商业化变现诉求与社区学习体验难以两全。作者也提出了一个行业性观察:AI编程助手的兴起正在悄悄掩盖文档质量的退化,但对真正想理解框架原理的学习者而言,清晰可导航的官方文档依然不可替代。
一位初学者的失望:LangChain文档到底出了什么问题
对于刚踏入智能体(Agentic AI)开发领域的开发者而言,官方文档往往是学习的第一道门槛。然而近日一位 Reddit 用户发帖直言,对 LangChain 的文档感到"极度失望"。他的吐槽并非情绪化的抱怨,而是指出了几个在初学者群体中相当普遍的痛点——本地模型集成信息缺失、产品推广充斥文档,以及缺乏面向新手的概念讲解。
这些批评触及了一个值得深思的问题:当一个开源框架快速迭代、功能爆炸式增长时,它的文档体验是否还能照顾到最需要帮助的初学者?
本地模型集成:藏在文档深处的信息孤岛
这位开发者的第一个也是最核心的抱怨,是关于本地/自托管模型的集成支持严重不足。他正在使用 Ollama 和 llama.cpp 来运行本地大语言模型,这是当下越来越多注重隐私、成本和离线能力的开发者的选择。
然而在安装与快速上手页面,他几乎找不到关于 llama.cpp 的任何信息。文档提示他去查看"providers 列表",但 llama.cpp 根本不在其中,文档内的搜索功能也无法定位到相关页面。讽刺的是,相关文档页其实是存在的——他最终是通过 Google 搜索才找到的,而且是在已经放弃之后。
"它确实存在,你只是没法从文档内部找到它。"
这种"信息孤岛"现象在大型开源项目中并不罕见。文档页面本身写了,但站内导航、搜索索引和交叉链接没有跟上,导致内容实际上处于"存在但不可达"的状态。对于初学者来说,找不到就等于不存在。
Ollama 是一个让用户在本地机器上一键下载并运行主流开源大语言模型(如 Llama 3、Mistral、Gemma 等)的工具,其设计目标是将云端 API 的使用体验复刻到本地环境,通过标准 REST 接口对外提供服务。llama.cpp 则是一个底层 C++ 推理库,通过量化(Quantization)技术大幅压缩模型体积与内存占用,使得消费级硬件也能运行数十亿参数量级的模型。两者代表了本地 LLM 部署的两条主要路径:Ollama 追求开箱即用的便利性,llama.cpp 则更接近底层、可深度定制。LangChain 理论上通过 ChatOllama 和 LlamaCpp 两个集成组件支持上述工具,但正如这位用户遭遇的那样,这些集成的文档入口与主干导航之间存在明显断层,形成了事实上的"隐藏功能"。
无处不在的 LangSmith 推广:还没跑通就被要求配置
转向 Ollama 后,这位用户遇到了第二个障碍:文档没有优先告诉他如何让模型跑起来,反而立刻抛出了 LangSmith 的配置提示。
"在我还没搞明白它要怎么用我的 Ollama 模型做任何智能体的事情之前,它就甩给我一句:'要启用模型调用的自动追踪,请设置你的 LangSmith API key。'我他妈一次调用都还没发出去呢。"
LangSmith 是 LangChain 官方推出的可观测性与调试商业产品。将它深度嵌入入门文档,从商业角度可以理解——这是框架方将开源流量转化为商业价值的常见策略。但从新手体验的角度看,在用户连第一个"Hello World"都还没跑通时就要求配置一个可选的商业服务,无疑增加了认知负担,也容易让人产生"被推销"的抵触情绪。
入门文档的黄金法则应该是:用最短路径让用户获得第一次成功体验。任何非必需的配置步骤,都应该往后放。
LangSmith 是 LangChain 公司推出的商业 SaaS 平台,主要提供链路追踪(Tracing)、评估(Evaluation)和监控功能,帮助开发者调试复杂的 Agent 行为和多步骤 Chain 执行过程。对于生产级应用而言,它确实是有价值的可观测性工具。然而,LangChain 在框架层面将 LangSmith 的初始化代码(设置 LANGCHAIN_TRACING_V2 与 LANGCHAIN_API_KEY 环境变量)嵌入到几乎所有官方示例的顶部,使其看起来像是运行框架的必要前提,而非可选的增强工具。这种"默认开启推广"的文档策略在以 Stripe、MongoDB 为代表的开发者工具公司中并不罕见,本质上是将开源框架的学习流量转化为商业产品注册率的漏斗设计。问题在于度的把握——当商业引导出现在用户完成第一个成功调用之前,它就从锦上添花变成了拦路虎。
过度依赖云端 API 的示例困境
第三个问题与前两个一脉相承:文档和示例几乎完全建立在调用云端 API 的假设之上。
这位用户也承认,使用托管模型 API 确实是当下的主流,真正拥有自托管模型的人是少数。但他提出了一个合理的诉求——至少提供一个本地模型的替代示例。
这个诉求背后反映的是开发者群体的分化。随着 Ollama、llama.cpp 等工具让本地部署门槛大幅降低,越来越多开发者出于数据隐私、成本控制或纯粹的学习目的选择本地方案。一份只演示 OpenAI API 的文档,等于把这部分用户挡在了门外,让他们不得不自己摸索如何把示例代码"翻译"成本地模型的版本。
缺失的概念地图:新手需要的不只是代码片段
最后,这位用户希望文档能为初学者补充更多关于 LangChain 工作原理的讲解——用流程图和组件示意图来解释各部分是如何协作的。他提到文档中虽然有一些,但"远远不够"。
这是一个非常本质的观察。LangChain 涉及 Chains、Agents、Tools、Memory 等一系列抽象概念,它们之间的关系对老手来说不言自明,但对新手而言却是一团迷雾。纯粹罗列 API 和代码片段,无法帮助初学者建立起整体的心智模型(mental model)。可视化的架构图和数据流示意,往往比大段文字更有效。
LangChain 的核心抽象体系在过去两年经历了一次重大重构:原有的 LangChain 包被拆分为 langchain-core(定义基础接口与 LCEL 表达式语言)、langchain(通用链与 Agent 逻辑)以及大量 langchain-<provider> 集成包。LCEL(LangChain Expression Language)是其中引入的声明式组合范式,允许开发者用管道符(|)将 Prompt、Model、OutputParser 等组件串联成链。这一架构变更虽然提升了模块化程度,却也让文档体系出现了新旧内容并存、概念边界模糊的问题——部分教程仍使用旧式 LLMChain 写法,另一部分已切换至 LCEL 风格,缺乏清晰的迁移指引。对初学者而言,在没有整体架构图的情况下,很难判断自己正在阅读的示例究竟属于哪个时代、是否还是推荐用法。
反思:是文档的锅,还是学习方式变了?
这位用户在帖子结尾提出了一个耐人寻味的自我怀疑:
"要么是大家其实都跳过读文档、直接用编程 AI 助手搞定一切,要么就是我又蠢又菜。但不管怎样,结果和我的看法不变——这文档对新手太糟糕了。"
这句话其实点出了一个正在发生的行业变化:越来越多开发者依赖 Cursor、Claude、Copilot 等 AI 编程助手来生成 LangChain 代码,而不是逐字阅读官方文档。这某种意义上掩盖了文档本身的缺陷——当 AI 能直接吐出可用代码时,文档的入门体验就显得没那么关键了。
但这并不能成为文档质量退步的借口。对于想真正理解框架、而非仅仅让代码跑起来的学习者来说,一份清晰、可导航、照顾本地部署场景的文档,依然是不可替代的。
作为一个快速演进的热门开源项目,LangChain 面临的挑战是典型的:功能迭代速度远超文档维护速度,商业化诉求与社区体验之间需要平衡。这位用户的批评,或许正是所有高速发展的开源工具都该警惕的镜子。
相关推荐
421M参数Laya模型玩转Flappy Bird:CPU上的OpenVINO INT8推理实践
一位开发者用OpenVINO将421M参数的Laya模型量化到INT8,成功在英特尔i7 CPU上运行Flappy Bird游戏。本文拆解OpenVINO转换、INT8量化的技术要点,以及消费级CPU运行数亿参数模型对端侧AI部署的意义。
本地27B AI Agent自主完成亚马逊购物:一次跑通全流程
一位开发者用本地运行的Qwen3 27B模型加TensorSharp运行时,让AI Agent自主完成亚马逊购买A4纸的全流程。推理、决策、代码生成全部本地化,仅登录和付款人工干预。本文拆解其技术栈与本地浏览器Agent的价值和局限。
蚂蚁AntLing开源Ming-Image-0.1-Design:6B设计图像模型登顶UI/UX榜首
蚂蚁AntLing(inclusionAI)开源Ming-Image-0.1-Design系列6B图像模型,登顶Artificial Analysis开放权重UI/UX设计榜首,附带分层模型及UI设计、图转可编辑PPT两项Agent技能。