Langfuse 是什么?大模型应用可观测性平台入门解析
Langfuse 是开源 LLMOps 平台,为 RAG 与多智能体应用提供链路追踪、成本分析、提示词版本管理和自动评估能力。
本文介绍了开源 LLMOps 平台 Langfuse 的核心定位与能力边界。Langfuse 不是智能体开发框架,而是针对已有的 RAG 和智能体项目提供可观测性与评估的专用平台,可类比为 AI 员工背后的四个角色:飞行记录仪(追踪运行链路)、质量部门(评估输出质量)、实验室(提示词与模型的 A/B 对比)以及提示词配置中心(版本管理与热切换)。它能回答生产环境中的关键问题,包括工具调用链路、token 成本与延迟、答案正确率等,并通过"记录—评估—实验—替换"的闭环推动大模型应用从经验驱动走向数据驱动。Langfuse 不提供大模型、向量数据库或运维监控,需与其他组件配合构成完整方案,支持 Python/TypeScript 并可与 LangChain、LlamaIndex、OpenAI Agent SDK 等主流框架整合。
在大模型应用从 Demo 走向生产的过程中,一个绕不开的问题是:模型和智能体在线上到底做了什么?调用了哪些工具?花了多少 token、多少钱、延迟几何?答案是否可靠?当项目从单一模型演变为多智能体协作的复杂系统时,缺乏可观测能力几乎等同于"黑盒运行"。Langfuse 正是为解决这一痛点而生的开源平台。
本文基于 B站 UP 主(马士教育大模型讲师小斌)的一门企业级智能体追踪评估实战课程,梳理 Langfuse 的核心定位、能力边界与在真实项目中的价值。该课程的整体目标,是围绕一个基于 Hugging Face 智能体架构(课程中称"哈尼斯架构")开发的财务分析多智能体,搭建一套日志追踪、评估与可观测的完整方案。
Langfuse 到底是什么
Langfuse 的官方定位是「开源的大模型 LLMOps 平台」。但仅凭这句定义,很难说清它究竟解决什么问题。更准确的翻译是:它是一个面向大模型、RAG 与智能体应用的开源 AI Engineering 平台,主要作用包括追踪运行过程、分析 token 成本与延迟、管理提示词、收集反馈、执行自动与人工标注的评估,并通过 Dataset 和 Experiment 实现持续改进。
这里有两层关键含义。第一,Langfuse 是针对已经开发好的 RAG 或智能体项目做数据收集、评估与追踪的工具,而不是用来从零构建智能体的开发框架。第二,它的能力边界集中在"观测与优化"环节——追踪运行链路、分析成本延迟、管理提示词、做各种评估。
值得强调的是它"平台"而非"框架"的属性。开发者通常不会用 Langfuse 做智能体本身的开发,而是安装其自托管(self-host)服务,再把这个服务与自己的大模型、RAG 项目、智能体项目对接整合,从而实现日志追踪与评估。它的顶层语言支持 Python 与 TypeScript/JavaScript,并能与 LangChain、LangGraph、DeepAgent、LlamaIndex、OpenAI Agent SDK 等主流智能体开发框架无缝整合。
LLMOps(Large Language Model Operations)是借鉴 DevOps/MLOps 理念衍生出的概念,专指围绕大模型应用的开发、部署、监控与持续优化所形成的一套工程实践体系。与传统 MLOps 关注模型训练、特征工程和离线评估不同,LLMOps 更侧重推理阶段的链路追踪、提示词版本管理、token 成本控制和基于真实流量的在线评估。随着 RAG 与多智能体架构的普及,一次用户请求可能触发数十次工具调用和子模型推理,传统日志系统难以结构化地还原这一调用树,LLMOps 工具因此成为生产级大模型应用的标配基础设施。Langfuse 在这一体系中扮演的是"可观测性与评估"层的角色,相当于大模型应用的 APM(Application Performance Monitoring)加上质量评估平台的结合体。
一个形象的类比:AI 员工的四个部门
如果把一个智能体比作会查资料、会用工具、会计算的"数字化 AI 员工",那么 Langfuse 就相当于这名员工背后的四个支撑角色。
飞行记录仪——追踪这个数字员工每一次运行的全过程,记录它做了什么、走了哪些步骤。质量部门——对员工生成的答案进行质量评估。实验室——当你修改了提示词或更换了模型,可以先在实验室里跑一跑,看看效果是否变好,再决定是否上线。提示词配置中心——集中管理提示词的版本。
其中提示词配置中心的价值容易被低估。很多开发者习惯把提示词直接写进项目代码里,这本身没问题,但隐患在于:提示词在运行过程中难免被修改,而修改未必让效果变好。一旦变差,能否快速回滚?能否在不重启 RAG 或智能体服务的前提下做版本切换?如果提示词硬编码在代码中,这一步几乎做不到。而 Langfuse 的 Prompt 管理正是为版本控制与热切换而设计。
提示词的热切换(Hot Reload)是指在不重新部署或重启服务的情况下,动态更新正在运行中的应用所使用的提示词内容。其实现原理通常是:提示词存储在外部配置中心(如 Langfuse 的 Prompt Management),应用在每次推理前通过 API 拉取当前生效的版本,而非在启动时将提示词静态编译进代码。这种机制的好处在于:当提示词改动引发输出质量下降时,可以秒级回滚到上一个稳定版本,无需走完整的代码发布流程。对于 7×24 小时在线的生产系统,这大幅降低了提示词迭代的风险窗口。与此同时,版本号记录也使每一条历史日志都能精确对应到当时使用的提示词快照,为后续的效果归因分析提供了可靠依据。
Langfuse 能回答哪些问题
可观测性的价值,最终体现在它能帮你回答一系列生产环境中的关键问题:
- 这次请求经过了哪些步骤?哪个子智能体做了什么事?
- 调用了哪些工具和模型?各自执行了多长时间?
- 当前使用的提示词和模型是哪个版本?
- 输入、输出的 token 统计与费用统计是多少?延迟有多高?
- 这次回答是否正确?是否有完整的正确率数据?用户是否满意(可结合人工标注)?
- 新版本是否比当前稳定版更好?
最后一个问题正对应"实验室"的能力:修改提示词或更换模型后,可以在实验中对比效果,若优于当前稳定版,再替换线上版本。这套"记录—评估—实验—替换"的闭环,正是大模型应用从经验驱动走向数据驱动的关键。
这套"记录—评估—实验—替换"的闭环在工程上对应的是 A/B 测试与回归测试的思路:在 Langfuse 的 Dataset 功能中预先准备一组带有标准答案的测试用例,每次修改提示词或更换模型后,在 Experiment 中跑完整个数据集并自动打分,与基准版本的指标对比后再决定是否上线。这与传统软件工程中"先测试、再合并"的 CI/CD 理念一脉相承,只是评估对象从代码逻辑变成了模型输出的语义质量。对于依赖大量人工审核的早期项目,这套自动化评估流程可以显著压缩从"发现问题"到"验证修复"的周期。
Langfuse 的能力边界
讲清楚一个工具"不能做什么",往往比罗列它的功能更重要。Langfuse 承担的是可观测(记录模型、工具、检索和子智能体的调用链)、评估与反馈、提示词管理、指标分析这四项工作。
而以下这些则不在它的职责范围内:它不提供智能体本身的开发框架;不提供大模型;不提供向量数据库或知识库(需要自己搭建);不负责智能体或 RAG 上线后的服务器运维、健康检查等基础设施监控。换句话说,Langfuse 专注于"应用层的可观测与评估",而不做业务决策、模型训练或运维层的工作。
厘清这条边界,有助于在技术选型时避免误区——Langfuse 不是万能平台,而是可观测性拼图中专业的一块。它需要与开发框架、模型服务、向量库和运维监控体系配合,才能构成完整的企业级智能体方案。
小结
对于正在把大模型应用推向生产的团队来说,Langfuse 提供的链路追踪、成本与延迟分析、提示词版本管理和评估能力,几乎是绕不开的基础设施。它的开源与自托管特性,也让企业能够在自有环境中掌控数据。至于"为什么要用 Langfuse"以及具体的实战对接,将在后续内容中进一步展开。
相关推荐
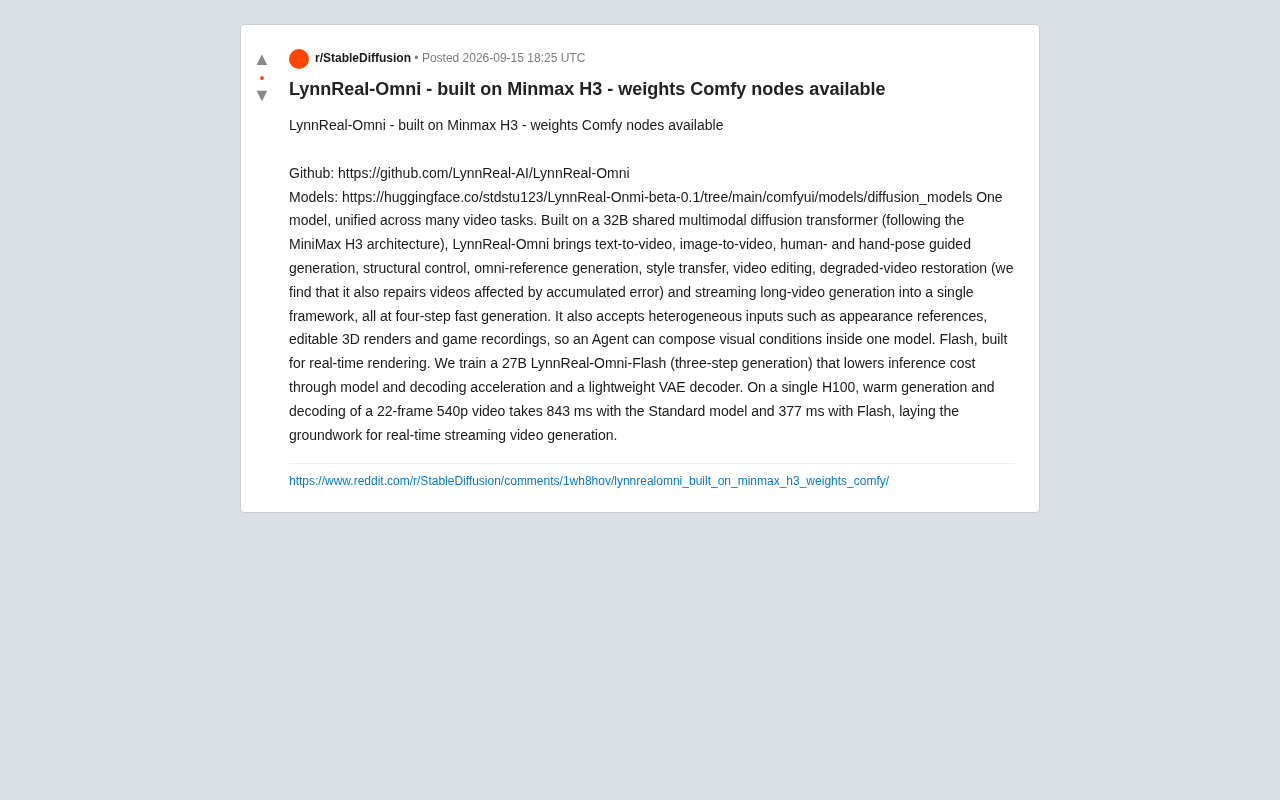
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。