Langfuse入门指南:大模型应用的可观测性平台详解

Langfuse是面向大模型/RAG/智能体的开源LLMOps平台,提供追踪、评估、提示词管理与指标分析能力。
Langfuse是一个开源的LLMOps平台,专为大模型、RAG和智能体应用的生产化观测与持续优化而设计。它的四大核心能力可用四个比喻概括:飞行记录仪(追踪调用链)、质量部门(评估答案质量与用户满意度)、实验室(对比不同提示词或模型版本的效果)和提示词配置中心(支持版本管理与热回滚)。作为平台而非开发框架,Langfuse通过自托管服务与LangGraph、LlamaIndex、OpenAI Agent SDK等主流框架无缝对接,也能追踪Claude Code等现成智能体产品的使用成本。其能力边界清晰:专注于观测与优化层,不提供大模型本身、向量数据库或服务器运维,是大模型应用从实验走向企业级生产环境的必要基础设施之一。
什么是Langfuse
在大模型应用从实验走向生产的过程中,一个绕不开的问题是:你的RAG系统或智能体到底在生产环境里表现如何?调用了哪些工具、消耗了多少Token、延迟多高、答案是否正确?Langfuse正是为回答这类问题而生的工具。
据B站大模型讲师小斌的教程介绍,Langfuse官方将自己定义为开源的大模型LLMOps平台。更准确的说法是,它是一个面向大模型、RAG和智能体应用的开源AI Engineer平台,核心能力包括追踪运行过程、分析Token成本与延迟、管理提示词、收集反馈,以及执行自动与人工标注的评估,并通过数据集(Dataset)和实验(Experiment)持续改进应用效果。
需要强调的是,Langfuse是一个平台而非开发框架。教程特别指出了这个区别:使用Langfuse通常不需要你做二次开发,而是直接安装其自托管服务,然后将服务与你自己的大模型、RAG项目、智能体项目整合对接,从而实现日志追踪、评估等操作。它的顶层语言是Python和TypeScript,如果确实需要做二次开发,推荐使用这两种语言。
LLMOps(Large Language Model Operations)是近年随大模型应用规模化而兴起的工程实践领域,可类比传统软件的 DevOps 或机器学习的 MLOps。它涵盖大模型应用从开发、测试、部署到持续监控与迭代的全生命周期管理。与传统软件不同,大模型应用的输出具有不确定性——相同输入可能产生不同输出,且质量难以用简单的单元测试衡量。LLMOps 的核心挑战因此集中在可观测性(知道系统在做什么)、评估(判断输出质量好坏)和提示词工程的版本化管理上。Langfuse 正是专门填补这一工程空白的工具,在大模型应用领域扮演着类似 Datadog 或 Sentry 在传统软件监控中的角色。
Langfuse能整合哪些框架
Langfuse的一大价值在于兼容性。它可以与LangGraph、LangChain、DeepAgent、LlamaIndex、OpenAI Agent SDK等常见的智能体与RAG开发框架无缝整合。这意味着无论你用什么技术栈构建应用,几乎都能把Langfuse作为统一的观测层接入。
一个容易被忽略的场景是:Langfuse不仅能观测你自己开发的应用,也能追踪现成的智能体产品。教程举例提到,很多团队日常使用Claude Code、Codex这类编程智能体,由于它们本质上也是智能体,完全可以对其进行日志追踪、Token分析、成本与延迟分析。这为企业统一管理各类AI工具的使用成本提供了可能。
RAG(Retrieval-Augmented Generation,检索增强生成)是目前企业落地大模型应用最主流的架构之一。其核心思路是:在将用户问题发送给大模型之前,先从外部知识库(通常是向量数据库)中检索相关文档片段,再将这些文档连同问题一起送入模型,从而让模型基于最新的、私有的知识作答,而不仅依赖训练时的参数记忆。RAG 系统的链路通常包括查询改写、向量检索、上下文拼装、模型调用等多个步骤,任何一个环节出现问题都可能导致最终答案质量下降,这也使得追踪每一步的输入输出、耗时和Token消耗变得格外重要——这正是 Langfuse 追踪能力的典型应用场景。
用一个比喻理解Langfuse的四大作用
教程用了一个形象的比喻来解释Langfuse。如果把Agent比作一名会查资料、会使用工具、会计算、会做各种操作的"数字化AI员工",那么Langfuse就相当于这名员工的飞行记录仪、质量部门、实验室和提示词配置中心。
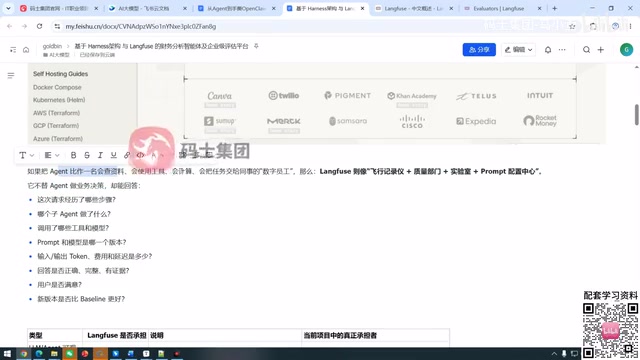
- 飞行记录仪(追踪):记录数字员工的每一步操作,完整还原调用链。
- 质量部门(评估):对生成的答案进行质量评估,判断回答是否正确、链路是否完整、用户是否满意。
- 实验室(Experiment):当你修改了提示词或更换了模型,可以在实验室里先跑一遍,对比效果。如果新版本优于当前稳定版(Best版),再决定是否替换。
- 提示词配置中心(Prompt管理):这是最容易被低估的能力。
为什么提示词管理值得重视
很多开发者习惯把提示词直接写进代码里。教程对此提出了一个现实的追问:提示词在后续运行中会不会被修改?修改后效果会不会反而变差?如果变差了能否快速回滚、能否做到不重启服务就热更新?
如果提示词硬编码在代码中,版本管理和热回滚这一步就很难做到。而Langfuse的提示词配置中心恰好解决了这个问题——支持版本管理、回滚,且无需重启RAG或智能体项目。在企业级开发中,这种能力的价值不容小觑。
热更新(Hot Reload/Hot Update)指在不停止或重启服务的情况下动态加载新的配置或代码,从而实现零停机变更。在大模型应用的生产环境中,提示词往往需要频繁调整——可能是因为模型行为漂移、业务需求变化,或者发现了更优的表达方式。若提示词硬编码在代码中,每次修改都需要走完整的发布流程(代码提交、构建、部署、重启),不仅耗时,还会造成服务短暂中断。Langfuse 的提示词管理中心将提示词从代码中解耦,应用运行时通过 API 拉取最新版本,修改提示词无需触碰代码仓库,真正实现热更新;同时每个版本都有记录,一旦新版本效果变差可以一键回滚到历史稳定版本。
Langfuse能回答哪些问题
接入Langfuse后,你可以清晰地回答一系列运维与质量问题:
- 这次请求经过了哪些步骤,哪个子智能体做了什么事?
- 调用了哪些工具和模型,各自执行了多长时间?
- 提示词和模型分别是哪个版本?
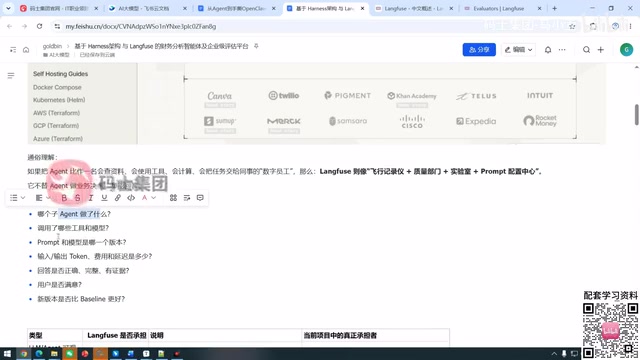
- 输入输出的Token统计、费用统计、延迟是多少?
- 回答是否正确,是否有完整的正确链路?
- 用户是否满意(可追加用户标注)?
- 新版本是否比当前稳定版(Best版)更好?
这些问题串联起来,构成了大模型应用从可观测到持续优化的完整闭环。
Langfuse的能力边界
理解一个工具的边界,和理解它的能力同样重要。教程明确梳理了Langfuse"能做"与"不能做"的清单。
Langfuse能做的:对大模型、RAG、智能体进行可观测,记录模型、工具、检索、子智能体的调用链;做评估与反馈;做提示词管理;做指标分析。
Langfuse不能做的:它不提供智能体本身的开发框架,不提供大模型,不提供向量知识库(需要自建向量数据库),也不负责应用上线后的服务器运维、监控和健康检查。
换句话说,Langfuse专注于观测、评估与优化这一层,不替代智能体或RAG去做业务决策,也不承担底层基础设施的角色。想清楚这条边界,才能在技术选型时把它放到正确的位置。
小结
Langfuse填补了大模型应用生产化过程中的观测与评估空白。它以追踪、评估、提示词管理、指标分析四大能力为核心,兼容主流智能体框架,既能观测自研应用,也能监控现成的编程智能体。对于希望把AI应用真正落地到企业环境、并持续迭代优化的团队来说,这类LLMOps平台几乎是绕不开的基础设施。该教程后续将继续讲解"为什么要使用Langfuse"以及基于Harness架构的多智能体财务分析项目的实战整合。
相关推荐

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。

承诺的新工作室去哪了?Craft Computing用五年时间给出答案
Craft Computing主理人回应观众质疑:承诺五年的新工作室因建设成本从3万暴涨至7.5万美元而搁浅,最终改为168平方英尺车库改造空间。频道收入因算法变化下滑,内容方向也将转向更务实的项目制作。