LangGraph+MCP:构建企业级ChatBI数据分析Agent实战指南

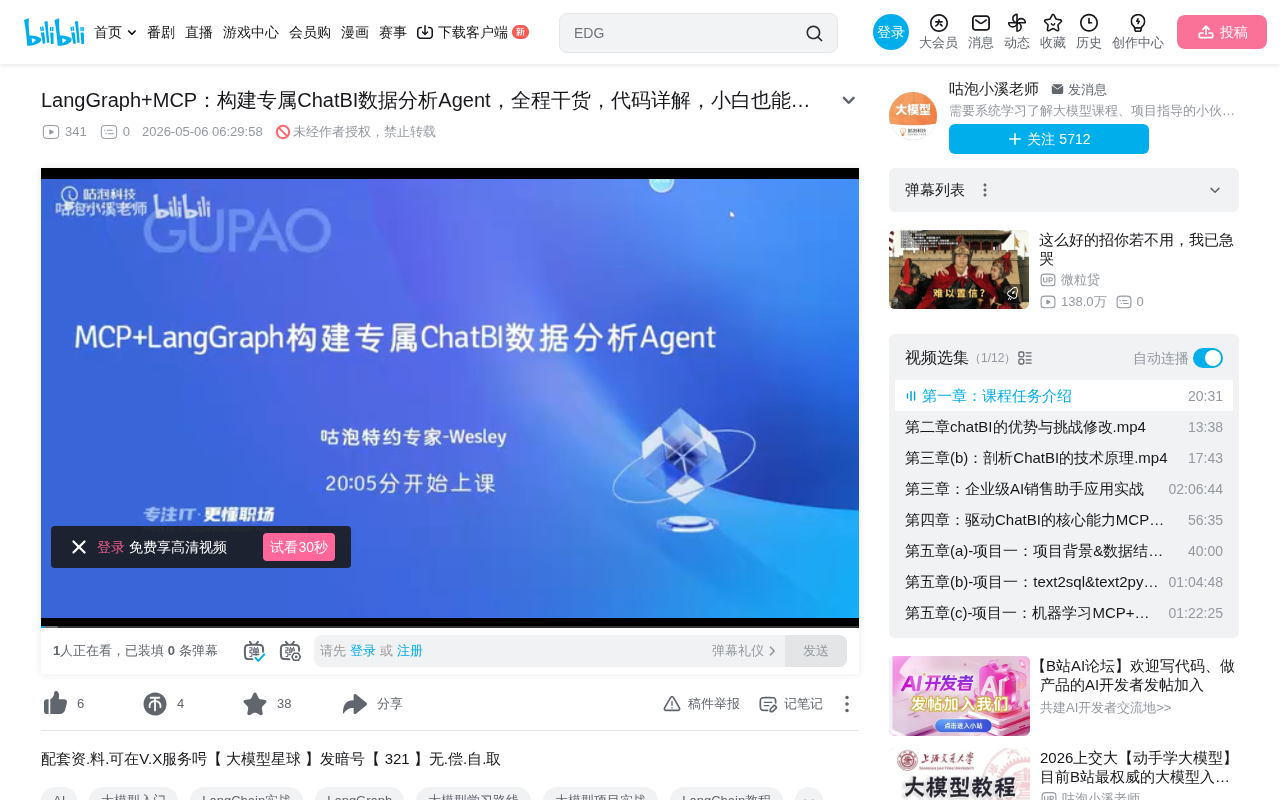
基于LangGraph+多MCP架构构建ChatBI数据分析智能体的技术方案解析
本文系统介绍了ChatBI(自然语言交互式商业智能)的架构设计与技术演进。针对传统数据分析中固定展板局限和三级协作效率瓶颈,提出用LangGraph+多MCP架构构建数据分析Agent,实现从自然语言到数据分析结果的全链路自动化。架构从中心化MCP演进到LangGraph去中心化方案,解决了稳定性和可扩展性问题,同时强调需明确能力边界并设计人机协作兜底机制。
什么是ChatBI?为什么企业需要它?
ChatBI,即基于自然语言交互的商业智能分析系统,是大模型智能体在企业数据分析领域最具潜力的应用方向之一。用户只需用自然语言描述需求——比如"帮我看一下去年双十一毛巾的销量变化"——系统就能自动完成数据查询、分析计算甚至机器学习建模,最终以图表、报告或一句话的形式返回结果。
本文基于一位拥有八年AI从业经验的UCLA数学系硕士的技术分享,系统梳理了如何利用LangGraph + 多MCP架构从零构建一套ChatBI数据分析Agent,涵盖架构设计理念、技术选型对比以及从中心化到去中心化的演进路径。

传统数据分析流程的痛点
固定展板的局限性
企业中常见的数据展板(Dashboard)虽然美观直观,但存在几个根本性问题:
- 内容固定:展板展示的指标和维度是预先设定的,每次新增一列数据都需要找数据分析师、产品经理排期开发
- 交互性差:无法动态适配个性化需求,比如"不显示订单编号"或"计算平均完成时长"这样简单的临时需求都无法满足
- 不适合低频需求:很多分析需求是一次性的(如对比今年和去年双十一的销量),为此投入多人协作开发极其浪费人效
三级协作结构的效率瓶颈
传统企业数据分析通常遵循一个三级结构:需求方 → 数据分析师 → 机器学习工程师。
需求方(运营人员、老板等)提出需求后,数据分析师从数据库中提取数据、做基础统计;如果涉及预测类的复杂需求,则需要进一步交给机器学习工程师进行建模。

这个流程的核心问题在于:
- 需求方的需求往往不是一次性说清楚的,反复修改导致整个链路被多次重走
- 同一份分析经过多人之手,沟通成本和时间成本极高
- 低频临时需求与高频固定需求混在一起,资源分配不合理

ChatBI的系统架构设计
整体流程:从自然语言到分析结果
ChatBI系统的核心设计理念是:用户只需提出自然语言需求,系统自主完成全链路的数据分析。其流程可以概括为以下几个关键环节:
- 语义理解与业务分流:系统首先对用户输入进行意图识别——是闲聊、画图还是数据分析?不同意图路由到不同的智能体处理
- NL2SQL数据获取:对于数据分析类需求,系统自动将自然语言转换为SQL查询语句,从数据库中提取所需数据。NL2SQL(Natural Language to SQL)是ChatBI的核心能力之一,早期依赖规则匹配和模板填充,准确率有限;大模型时代准确率得到质的飞跃,但仍面临多表关联、业务术语歧义等挑战。工程实践中通常需要结合Schema注入(将数据库表结构喂给模型)、Few-shot示例以及执行结果验证等手段来提升可靠性。
- 智能决策:获取数据后,系统自主判断是直接生成统计结果,还是需要进一步进行机器学习建模(如销量预测)
- NL2Pattern建模:对于预测类需求,系统基于历史数据自动构建时间序列等模型,生成预测结果
- 智能总结输出:最终以图表、报告或简短回答的形式返回给用户
这套架构的精妙之处在于它的高度可扩展性——语义理解模块本身就是一个路由器,你可以随时融入RAG模块处理专业知识问答,或者接入其他功能智能体,而不仅仅局限于数据分析。
RAG技术补充:RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与大语言模型结合的技术架构。其核心思路是:在模型生成回答之前,先从向量数据库或文档库中检索与问题相关的上下文片段,再将这些片段连同问题一起输入模型,从而让模型能够回答其训练数据之外的专业问题。在ChatBI场景中,RAG模块可用于处理企业内部的业务术语解释、指标定义查询等知识问答需求,与数据分析能力形成互补,构成完整的企业知识服务闭环。
能力边界:ChatBI不是万能的
你可能没注意到,分享者特别强调了ChatBI的能力边界问题。目前市面上真正好用的ChatBI产品并不多见,这说明这类产品确实面临不少挑战。正确的做法是:
- 明确哪些场景适合用ChatBI(如标准化的统计查询、趋势分析)
- 哪些场景比较难处理(如极其复杂的多表关联分析)
- 对于难以处理的场景,通过路由到人工来解决,实现人机协作
从中心化MCP到LangGraph去中心化架构的演进
第一阶段:中心化多MCP架构
课程首先介绍了一种简易实现方案:以大语言模型作为中心调度者,通过多MCP(Model Context Protocol)实现数据分析智能体。
MCP协议背景:MCP是Anthropic于2024年底提出的开放标准协议,旨在统一大语言模型与外部工具、数据源之间的交互方式。在此之前,每个AI应用都需要为不同工具编写定制化的集成代码,维护成本极高。MCP通过标准化的客户端-服务器架构,让模型能够以统一方式调用数据库、文件系统、API等各类外部资源,类似于USB接口对硬件生态的统一作用,极大地降低了工具集成的门槛。
这种方案的优点是搭建简单、代码量少,但存在明显缺陷:
- 不稳定性:当工具数量增多时,大模型作为单一调度中心容易"反应不过来"
- 可扩展性差:所有决策都依赖一个中心节点,难以灵活扩展新功能
- 工具调用混乱:工具太多时,模型可能选错工具或调用顺序出错
第二阶段:LangGraph去中心化架构
为了解决中心化架构的问题,课程引入了LangGraph——一个企业级的智能体编排框架。
LangGraph技术背景:LangGraph是由LangChain团队开发的智能体编排框架,基于有向图(DAG及循环图)的计算模型,专为构建复杂的多智能体工作流而设计。与传统的链式调用不同,LangGraph允许工作流中存在循环和条件分支,这对于需要反复迭代、自我纠错的AI Agent至关重要。其核心抽象包括节点(Node)、边(Edge)和状态(State)——状态在节点间流转并被持久化,使得整个系统具备记忆能力和断点续跑的特性,非常适合企业级的复杂数据分析场景。
LangGraph的核心优势在于:
- 图结构编排:将智能体的工作流程定义为有向图,每个节点是一个独立的智能体或处理单元
- 去中心化调度:不再依赖单一大模型做所有决策,而是让每个节点各司其职
- 无限扩展:可以随时向图中添加新的节点和边,融入新功能而不影响现有流程
- 稳定性提升:每个节点只需关注自己的任务,降低了单点故障的风险
MCP的串行与并行调用策略
在MCP的使用层面,课程详细讲解了两种调用模式:
- 串行调用:工具按顺序依次执行,适合有依赖关系的任务链
- 并行调用:多个工具同时执行,适合独立的数据获取任务,可显著提升效率
将这两种模式与LangGraph结合,可以在图的不同节点中灵活运用,实现既高效又稳定的智能体调度。
ChatBI核心技术栈一览
整个ChatBI系统的技术栈可以归纳为以下几个核心模块:
| 模块 | 技术 | 作用 |
|---|---|---|
| 智能体编排 | LangGraph | 定义工作流图结构,管理节点间的状态流转 |
| 工具调用 | MCP / Function Calling | 连接数据库查询、图表生成等外部工具 |
| 数据查询 | NL2SQL | 将自然语言转换为SQL语句 |
| 数据建模 | NL2Pattern | 自动构建机器学习预测模型 |
| 语义理解 | LLM | 意图识别与业务分流 |
总结:ChatBI如何重塑企业数据分析
ChatBI代表了企业数据分析从"人找数据"到"数据找人"的范式转变。通过LangGraph + 多MCP的架构组合,我们可以构建一套既稳定又灵活的数据分析智能体:
- 对普通用户:只需用自然语言描述需求,无需掌握SQL或数据分析技能
- 对数据分析师:可以将重复性的取数、制表工作交给系统,专注于更有价值的洞察
- 对企业:大幅降低低频临时需求的人效成本,提升数据驱动决策的效率
当然,ChatBI并非万能。在实际落地中,明确其能力边界、做好人机协作的兜底设计,才是让这类系统真正产生价值的关键。未来随着大模型能力的持续提升和工具生态的完善,ChatBI有望成为企业数据分析的标配基础设施。
核心要点
- ChatBI通过自然语言交互替代传统三级数据分析流程,大幅降低沟通成本和人效浪费
- 中心化多MCP架构实现简单但存在不稳定性和可扩展性差的问题,LangGraph去中心化架构可有效解决
- 系统核心链路为:语义理解→业务分流→NL2SQL数据获取→智能决策→NL2Pattern建模→智能总结输出
- MCP的串行与并行调用模式结合LangGraph图结构,可实现灵活高效的智能体调度
- 明确ChatBI的能力边界并设计人机协作兜底机制,是系统落地的关键
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。