LangGraph人机协同:interrupt()该放哪?六组do/don't

LangGraph人工审批的六个do/don't判断标准与设计要点。
本文基于Reddit实践笔记,用do/don't成对的方式总结了在LangGraph中为智能体添加人工审批的六个关键判断标准:只在难以撤销且出错不易暴露的步骤前暂停;interrupt载荷应展示实际效果而非模型自述;副作用必须放在interrupt()之后以避免恢复时重复执行;必须用checkpointer和稳定thread_id持久化;审批通过率不能作为成功指标,应跟踪拒绝与抽样;审批权限设计要让拒绝和通过一样低成本。文章还指出两个开放问题:interrupt()与interrupt_before的取舍,以及长时间等待与超时处理。
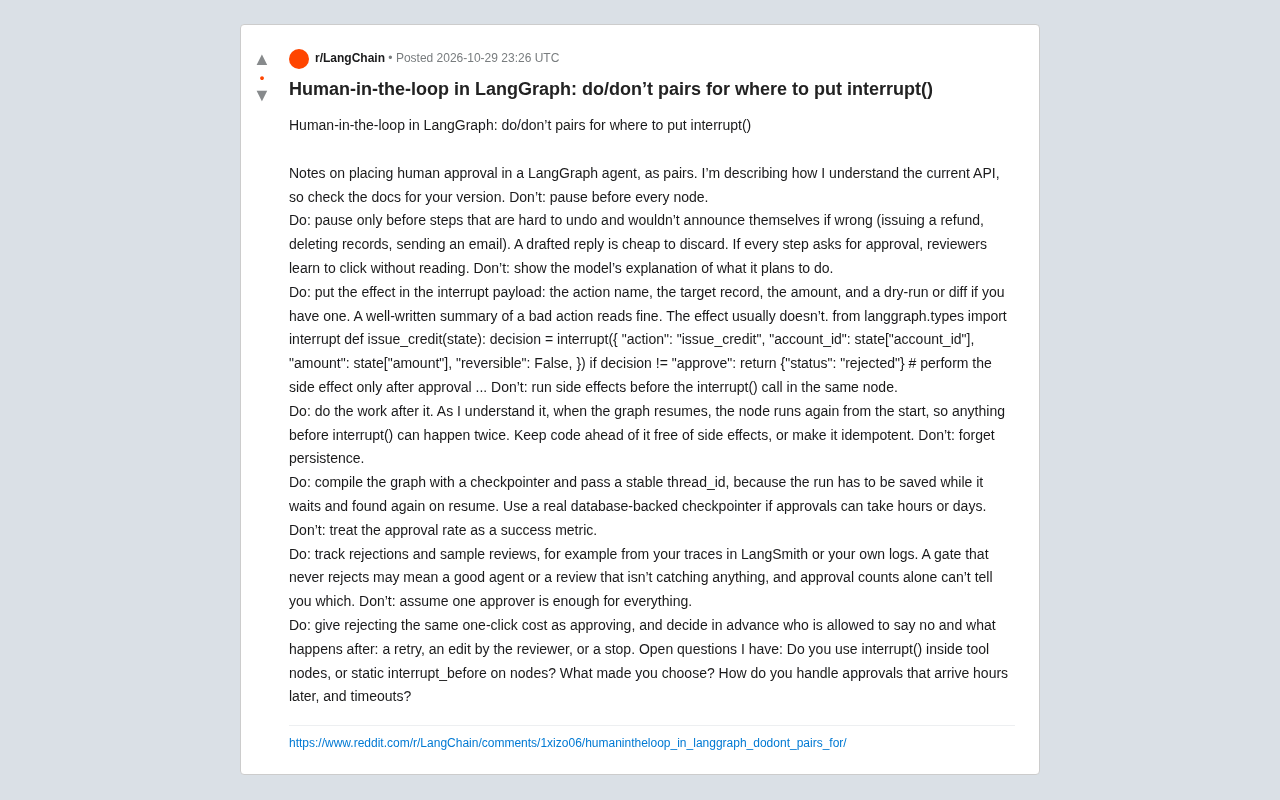
在LangGraph里给智能体加人工审批,最难的往往不是调API,而是决定审批点放在哪。Reddit上有一篇实践笔记用do/don't成对的方式,给出了六个直接可用的判断标准。作者也说明这是基于对当前API的理解,具体版本仍需对照文档确认。下面结合原文逐条展开。
一、不要在每个节点前暂停,只在难撤销的步骤前拦
原文的第一组对照很明确:不要在每一个节点前都设置暂停;只在那些难以撤销、而且出错时不会自我暴露的步骤前暂停,比如发起退款、删除记录、发送邮件。草拟的回复丢掉成本很低,不值得拦一道。
这背后的成本是注意力。如果每一步都要审批,审核者会逐渐学会不看内容直接点通过。审批环节的价值来自稀缺性,一旦泛滥就退化成形式。把审批留给真正会有外部影响的操作,才是让人工介入有意义的前提。
二、别让模型自己解释要做什么,把实际效果放进interrupt载荷
第二组对照针对的是审批界面显示什么。不要展示模型对自己计划的解释,而要把实际效果放进interrupt的payload:动作名称、目标记录、金额,以及能提供的话放上dry-run或diff。原文的理由很尖锐——一个写得漂亮的摘要配上糟糕的动作,读起来依然通顺;但效果本身通常不会骗人。
原文给出的代码结构大致如下:
from langgraph.types import interrupt

def issue_credit(state):
    decision = interrupt({
        "action": "issue_credit",
        "account_id": state["account_id"],
        "amount": state["amount"],
        "reversible": False,
    })
    if decision != "approve":
        return {"status": "rejected"}
    # perform the side effect only after approval
    ...
注意载荷里带了reversible: False这类结构化字段,审核者看到的是可核对的参数,而不是一段自述。这比让模型写“我将为账户X发放信用额度”要可靠得多。
三、副作用必须放在interrupt()之后
第三组对照是技术性最强的一条。不要在同一个节点里、在调用interrupt()之前执行副作用;要把真正的工作放到它后面。作者的理解是:图恢复运行时,节点会从头重新执行,所以interrupt()之前的任何代码都可能被执行两次。
应对方式有两种——让interrupt()之前的代码不含副作用,或者把操作做成幂等的。这条如果忽略,轻则重复扣款,重则重复发邮件。它也是很多人在第一次接入人工审批时最容易踩的坑,因为单步调试时根本看不出来,只有真正恢复执行才会暴露。
LangGraph 中检查点(checkpoint)与中断(interrupt)的恢复机制
LangGraph 的持久化执行模型基于"检查点"。图的每一步执行后,checkpointer 都会保存一个状态快照(checkpoint)。当调用 interrupt() 时,当前节点会抛出内部信号,图进入中断状态,但此时已保存的检查点指向的是该节点开始执行之前的状态。当外部批准信号到达、图被恢复时,LangGraph 会从最近一次检查点重新调度该节点,节点函数会从头开始执行,而不是从 interrupt() 调用处继续。这就是为什么 interrupt() 之前的代码会被执行两次:恢复不是"续执行",而是"重放"。理解这一点是排查重复副作用问题的关键,也是设计幂等操作或把副作用后置的根本原因。
四、别忘持久化:checkpointer和稳定的thread_id缺一不可
第四组对照关于图的编译方式。不要忘记持久化;要用checkpointer编译图,并传入稳定的thread_id,因为运行需要在等待期间被保存下来,恢复时才能找回来。如果审批可能拖上数小时甚至数天,就该用真正由数据库支撑的checkpointer。
这条限制直接决定了审批流程的形态。内存级的checkpointer适合开发和短时等待,但跨天审批一旦遇到进程重启就全丢了。原文把“审批能等多久”作为选择checkpointer的依据,是很务实的切分线。
Checkpointer 的类型与 thread_id 的作用
在 LangGraph 中,checkpointer 决定了图的状态在何时、以何种介质被保存。常见选项包括 MemorySaver(进程内内存,仅适合开发和短时演示)、SqliteSaver(本地文件,适合单机持久化)以及基于 Postgres 等数据库的 saver(适合生产环境和跨进程、跨天等待)。thread_id 是恢复状态的钥匙:每次调用图时传入的 thread_id 标识一条独立的执行线程,checkpointer 按 thread_id 存取状态快照。如果 thread_id 不稳定(例如每次运行随机生成),恢复时就找不到对应的检查点,审批流程会直接断掉。因此"用 checkpointer 编译图"和"传稳定 thread_id"是同一件事的两面,缺一不可。
五、审批率不是成功指标,要看拒绝和抽样
第五组对照容易被忽略:不要把审批通过率当成成功指标;要跟踪拒绝情况和抽样复核,比如从LangSmith的trace或自己的日志里取样。
原文的逻辑是,一个从不拒绝的关卡可能意味着智能体确实做得好,也可能意味着审核根本没在起作用,而单看通过数量无法区分这两种情况。只有拒绝样本和抽查记录才能说明这道关卡究竟有没有价值。这也是把人工审批从“流程装饰”变成“可度量控制点”的关键一步。
六、一个审批人不够,拒绝要和通过一样便宜
最后一组对照涉及审批权限设计。不要假设对所有事情来说一个审批人就够;要让拒绝拥有和通过一样的单击成本,并提前决定谁有权说不、说不之后发生什么——是重试、由审核者修改,还是直接停止。
如果拒绝操作比通过更麻烦,审核者会倾向于放行,审批就失去了意义。而“拒绝之后怎么办”如果没有预先定义,流程会在第一次真正的拒绝时卡住。这两点都属于设计阶段就该定下来的事,而不是上线后再补。
原文留下的开放问题
作者在末尾列了两个自己还没答案的问题,对正在搭建类似流程的人同样有参考价值:一是在工具节点内部使用interrupt(),还是在节点上使用静态的interrupt_before?是什么让你做出这个选择?二是对于数小时后才到达的审批,以及超时情况,该如何处理?
这两个问题分别指向控制粒度和时间维度。前者影响的是审批点与工具逻辑的耦合方式,后者影响的是等待、超时与重试的状态设计。原文没有给出结论,但把问题摆出来本身就有价值——它们正好覆盖了do/don't清单之外、仍然需要按具体业务判断的部分。
整套对照的共同思路其实只有一句话:审批点应该放在副作用真实、不可逆、且审核者能看懂实际效果的地方,其余环节交给自动化和事后的抽样检查。
interrupt_before 与 interrupt() 的取舍
原文末尾提到的第一个开放问题,涉及 LangGraph 提供的两种中断方式。interrupt_before 是编译图时声明的静态断点,在指定节点执行之前暂停,适合审批点固定、逻辑简单的场景;而节点内调用 interrupt() 是动态的,可以把实际参数(如金额、目标记录)放进 payload,并让暂停点与业务逻辑紧密耦合。静态断点无法携带运行时数据,恢复后节点照常执行;动态 interrupt() 则允许审核者看到具体效果并影响后续分支。选择哪一种,本质上是在"审批点的可配置性"与"审批信息的丰富度"之间权衡。
相关推荐

Vibe Coding全栈实战:AI编程从入门到企业级落地
从Cursor到Claude Code,这套B站AI编程实战课程以四个递进项目覆盖全栈开发、开源二次开发与团队协作。文章解析AI编程带来的前端岗位震荡、五人选五十人的效率变革,以及企业级项目所需的方法论。

大卫·布莱恩全球寻访真魔术:从南非到日本与印度
大卫·布莱恩在《Do Not Attempt》特辑中走访南非、日本与印度,记录Spinning车手、黑曼巴蛇保护者、居合术大师与苦行者的真实绝技,探讨魔术与人类极限挑战之间的边界。

触屏MacBook要来了?Vergecast爆料苹果高管回应
Vergecast播客披露记者与苹果高管John Ternus的对话,谈及触屏MacBook与Apple Pencil支持问题。Ternus回应称iPad才是手写笔最佳设备,记者则押注MacBook终将支持Apple Pencil。