LangGraph四路智能体对决:Plan-and-Execute成本高2.3倍却无优势

四种智能体架构在240个法律问题上准确率无显著差异,但复杂架构成本更高。
一位开发者在LangGraph上实现了四种智能体架构(ReAct、Plan-and-Execute、Supervisor、Draft-Verify),使用相同模型、工具和预算,在240个日本法律问题上进行预注册对比测试。结果显示,所有设计在准确率上无统计显著差异(最小p=0.0525),但成本差异明显:Plan-and-Execute的token消耗是ReAct的2.3倍以上,且被其他设计全面支配。额外token主要消耗在工具循环而非规划。Draft-Verify看似领先,但优势主要源于验证器移除了虚构引用,剩余差距与运行噪声无法区分。此外,符号化“正确”评分仅检查引用编号,部分正确回答存在内容捏造。实验统计功效有限,不能排除中小幅度的真实差异。
一位开发者用相同的模型、工具和预算,在LangGraph上构建了四种智能体架构,并用240个关于日本法律条文的问题进行了预注册对比测试。结果出人意料:成本最低的设计与成本最高的设计在准确率上并无统计显著差异,而Plan-and-Execute架构消耗了2.3倍以上的token,却没有带来可检测的收益。
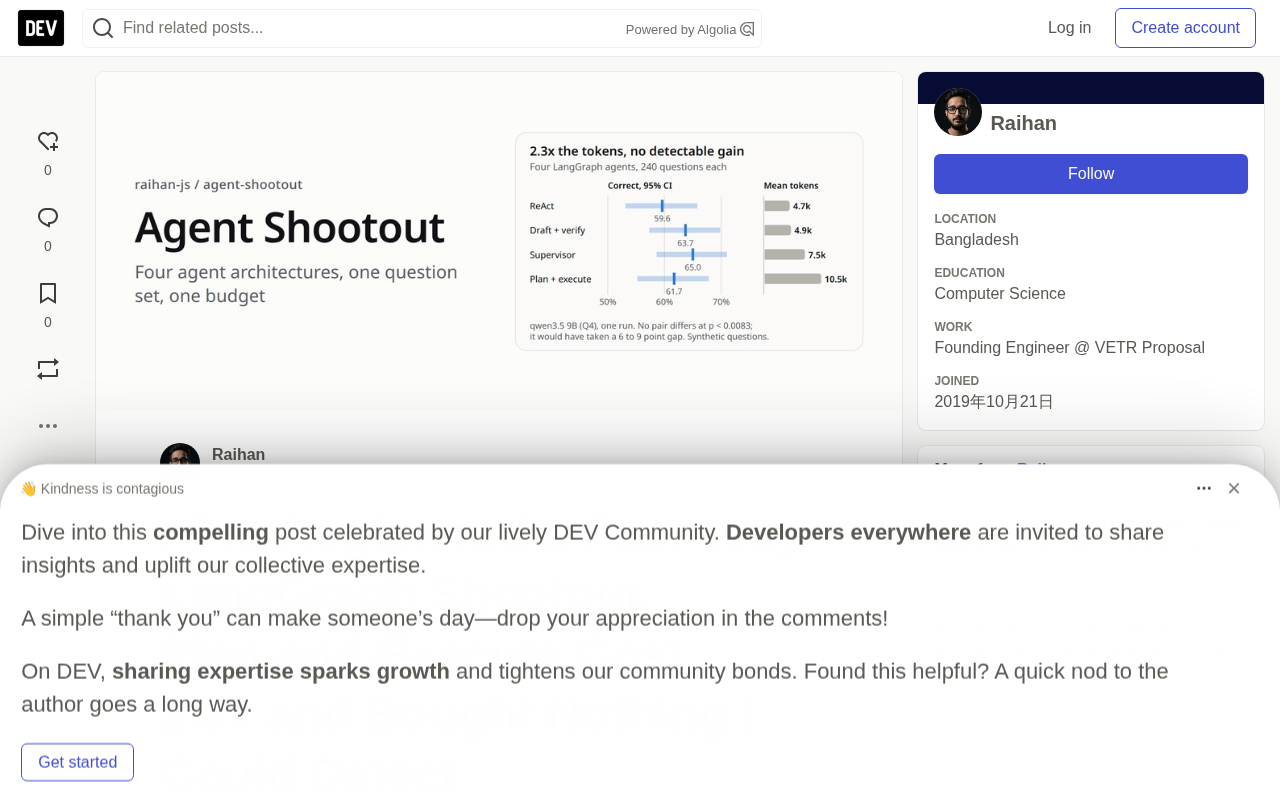
实验设计:四种架构,控制变量
作者在LangGraph中实现了四种智能体设计,所有其他条件保持不变:相同的三个工具(search_articles、get_article、verify_citation)、相同的基础提示词、相同的本地模型(qwen3.5 9B,Q4_K_M量化,温度0),以及每个问题24,000 token和20次模型调用的预算上限。
- A, ReAct:单一的模型-工具循环。
- B, Plan-and-Execute:规划器写出最多三个步骤,执行器循环运行每一步,最后由综合器撰写答案。
- C, Supervisor:监督者在研究员循环和写手之间路由。
- D, Draft-Verify:先由ReAct循环生成草稿,然后对每个引用进行符号化校验,最多进行两次修订。
测试集包含120个问题,以日语和英语提问,共240个问题。问题类型分为主题型、相邻型和配对型,且问题中不直接命名条文编号(例如“X条文之后的那一条是什么?”),因此搜索能力至关重要。评分完全符号化,不依赖语言模型裁判:引用提取器、注册表存在性检查,以及基于注册表的黄金条文匹配。
预注册与噪声基线
在运行测试集之前,作者提交了预注册文件,包括输入哈希、指标定义、配对检验方法(按问题精确McNemar检验,六对比较的阈值设为0.05/6=0.0083)以及五个假设。提示词在36个独立的开发问题上进行调优,每种设计使用相同的轮次,且没有针对单一设计做特殊修改。
为了测量噪声下限,作者在相同设置下将开发集运行了两次:同一设计在相同36个问题上,正确性变化了1到5个问题,而答案文本完全相同的只有2到5个。这意味着即使完全相同的配置,也存在不可忽视的随机波动。
McNemar检验是一种用于配对二分类数据的统计检验,常用于比较两种方法在同一组样本上的表现差异。它关注的是两种方法结果不一致的配对样本,通过构建2x2列联表并计算卡方统计量(或精确二项检验),判断不一致的方向是否具有系统性。在本实验中,每个问题被两种设计分别回答,正确与否构成配对数据,因此McNemar检验适合检测两种设计在正确率上的显著差异。作者还采用了Bonferroni校正,将显著性阈值除以比较次数(6对比较,阈值设为0.05/6≈0.0083),以控制多重比较带来的假阳性风险。
核心结果:准确率无显著差异,成本分化明显
240个问题的测试结果如下:
| 设计 | 正确率 | 每题平均token | 每正确回答token | p50延迟(秒) |
|---|---|---|---|---|
| ReAct | 59.6% [53.1, 65.8] | 4,663 | 7,826 | 14 |
| Plan-execute | 61.7% [55.2, 67.8] | 10,535 | 17,084 | 40 |
| Supervisor | 65.0% [58.6, 71.0] | 7,494 | 11,530 | 31 |
| Draft-verify | 63.7% [57.3, 69.8] | 4,905 | 7,694 | 16 |
没有任何一对设计在正确率上达到统计显著阈值,最小的p值为0.0525。但成本差异清晰:ReAct和Draft-Verify的平均成本均低于Plan-and-Execute和Supervisor,且自助法置信区间不重叠,同时准确率没有可检测的下降。Plan-and-Execute被其他三种设计全面支配。
额外token主要消耗在工具循环轮次上(更多的搜索和条文阅读,每次都会重新发送不断增长的上下文),而非规划文本——其90%的token花在执行器循环中。
五个假设中有四个按预期成立:正确率差距均在10个百分点以内;成本排序为A < D < C < B,且B至少是A的两倍;虚构引用率低于5%;ReAct和Draft-Verify在不到25%的运行中跳过工具。唯一半成立的是:作者原本预期Plan-and-Execute在配对型问题上会表现更好,但实际并未突出(80题中正确39题,与Supervisor相同)。
统计功效的局限
当设计之间在9%到23%的问题上存在分歧时,一对设计需要大约6到9个百分点的差距才能被判定为不同。Supervisor相对于ReAct的5个百分点领先(p=0.085)既未被证实也未被排除。这意味着实验的统计功效有限,不能排除中小幅度的真实差异。
统计功效(Power) 指当真实差异存在时,实验能够检测出该差异的概率。功效受样本量、效应大小和显著性阈值影响。在本实验中,由于样本量有限(240题)且设计间分歧比例在9%到23%之间,实验只能可靠检测较大的差异(约6-9个百分点)。因此,即使Supervisor比ReAct高出5个百分点,也可能因功效不足而无法达到统计显著。作者明确指出,这种不显著的结果不能解释为“无差异”,而应理解为“当前实验不足以区分中等或小幅差异”。
看似胜利的Draft-Verify
Draft-Verify比ReAct多对了10个问题(16题仅它正确,6题仅ReAct正确)。这看起来像是验证机制在起作用。但深入检查后发现:在这16题中,有5题是ReAct产生了虚构引用,1题未作答。移除虚构引用正是验证器所做的——使用与评分相同的注册表——因此其0.4%的低虚构率是实验设置的属性,而非成就。剩余10题中,ReAct引用了真实条文但遗漏了黄金条文,验证器无法察觉。两种设计之间无法区分,它们的分歧(240题中的22题)大致相当于单一设计自身的运行间噪声。
“正确”只是引用检查
作者打印出的第一条记录就暴露了问题:问题要求民法730条之后的条文,ReAct回答了731条——编号正确——并声称该条规定了扶养义务的终止。但731条实际规定的是最低结婚年龄。模型只从搜索结果中看到了730条,然后猜测了下一个编号。
由于工具是确定性的,作者重放了每一次记录的工具调用,检查每个黄金条文是否真的被返回给模型。在91%到99%的正确回答中确实如此。但剩余部分(ReAct的143题中有13题,Supervisor的156题中有12题,Draft-Verify的153题中有14题,Plan-Execute的148题中有1题)并非如此:编号正确,但内容捏造。本研究中没有任何指标检查回答对正确引用的条文内容是否准确。在“正确且黄金条文被阅读”这一更严格标准下,配对检验仍未达到显著(最小p=0.036),因此结论依然成立,但作者最谨慎对待的数字正是那个被称为“正确”的数字。
符号化评分(Symbolic Scoring) 是指不依赖语言模型判断,而是通过规则或确定性程序评估答案正确性的方法。本实验的符号化评分包含三个步骤:从答案中提取引用的条文编号,检查该编号是否存在于法律条文注册表中,以及是否与预先标注的黄金条文匹配。这种方法避免了主观性和模型偏差,但仅验证了引用编号的存在性与匹配性,并未检查答案对条文内容的描述是否准确。因此,符号化“正确”可能高估实际法律准确性,正如作者发现部分正确回答存在编号正确但内容捏造的情况。
实验中出现的错误
- 看似模型结果的评分bug:最初的开发集评分使用了需要
第740条的模式,但模型写出的是第 740 条和民法709条。28个答案被评分为“无引用”。修复后从文本重新评分。 - 早期项目提取器的bug:每个分支引用(第二条の二)的前缀被计为第二个幻影引用。重新评分了该项目全部1,800条已发布回答并修正了数字。
- 测量标题的指标:预注册的“不支持引用”率对所有设计均为86%到90%,因为答案引用了问题中的 statute heading,而标题是说明文字而非条文正文。作者报告但未使用该指标。
- 挑剔的工具:
get_article接受415-2但不接受415条の2或250の6,对存在的条文返回“无此条文”。Plan-Execute的34次失败查找中有11次属于此类。工具对所有设计相同,预注册后未更改。
结论与局限
这项实验传达的核心信息是:在控制变量、预注册和符号化评分的条件下,更复杂的智能体架构(规划器、监督者、验证器)并未带来可检测的准确率提升,而成本却显著增加。Plan-and-Execute尤其被证明是低效的——额外消耗的token主要来自工具循环而非规划智能。
但作者也明确列出了局限:这些结果仅适用于合成问题、单一模型、单一提示词集和单一预算;问题规律性强,英语问题直接引用日语标题;“正确”仅是引用检查而非法律准确性。不同提示词、不同模型或不同预算都可能改变排序。代码、预注册文件、报告、事后分析(已标注)以及每个问题的记录均已在GitHub和Hugging Face上公开。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。