LangSmith Fine-Tuning 上线:一条 CLI 打通微调全流程
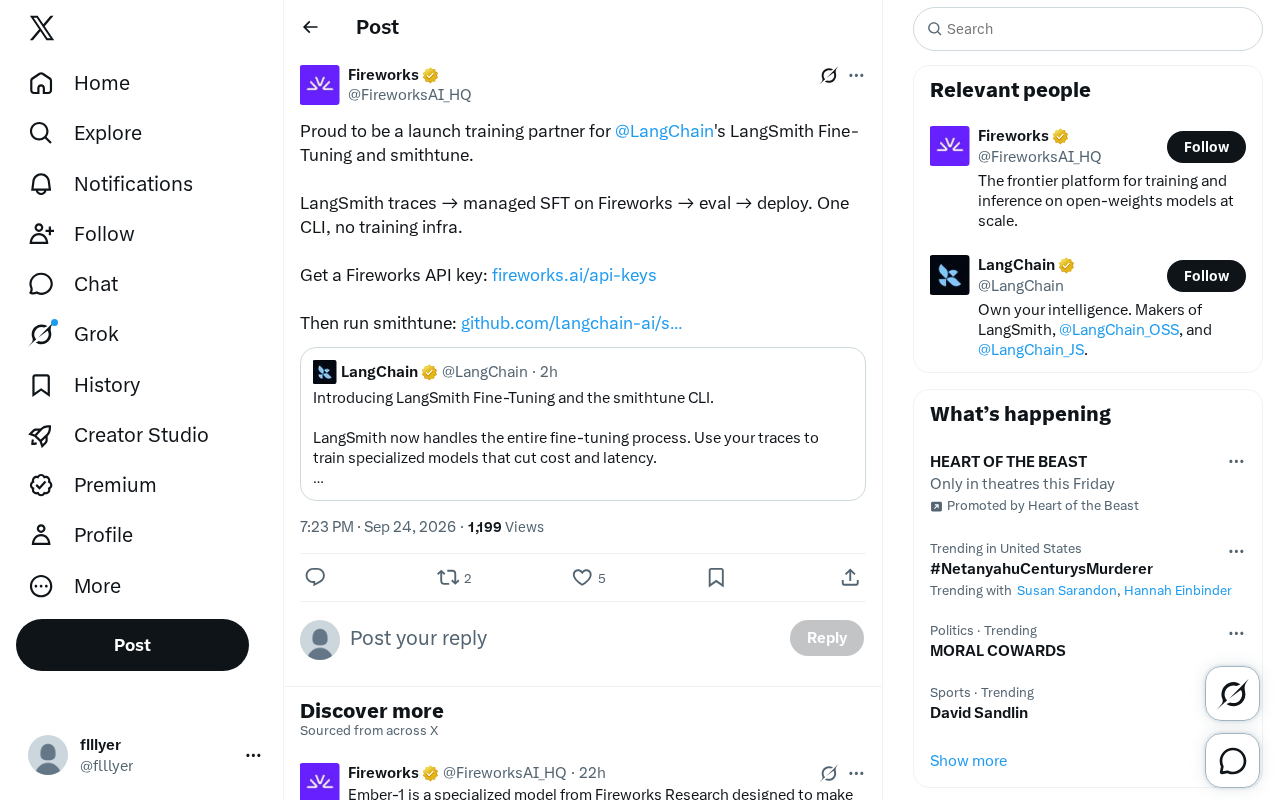
LangChain 推出 smithtune,打通 LangSmith traces 到模型微调部署的完整闭环,一条 CLI 替代繁琐的训练基础设施搭建。
LangChain 正式发布 LangSmith Fine-Tuning 及命令行工具 smithtune,联合 Fireworks 提供托管式监督微调(SFT)能力。其核心链路为:将 LangSmith 在生产环境采集到的真实运行 traces,直接转化为训练语料,在 Fireworks 上完成微调,再经过评估后部署上线。对开发者而言,整个过程通过一条 CLI 命令驱动,无需自建 GPU 集群或配置训练框架。这一工具的推出补齐了 LangSmith 生态中"观测—评估—优化"闭环里最重的优化环节,也体现出 LLM 应用开发正从调用通用 API 向利用自有数据持续优化专属模型演进的大趋势。定价与支持的基础模型范围等细节尚需参考官方文档。
LangChain 推出 LangSmith Fine-Tuning
LangChain 正式发布了 LangSmith Fine-Tuning 与配套工具 smithtune,Fireworks 作为首批训练合作伙伴参与其中。这套工具的核心卖点很直接:把开发者原本散落在多个环节的模型微调工作,压缩到一条命令行里完成,且无需自行搭建和维护训练基础设施。
对于长期使用 LangChain/LangSmith 做应用开发和链路追踪的团队来说,这意味着从数据采集到模型部署的闭环被显著缩短。过去要做一次监督微调(SFT),往往需要处理数据导出、清洗、上传训练平台、配置资源、评估、再部署等一系列步骤,而现在这些环节被整合进了统一的工作流。
工作流:从 traces 到部署的完整闭环
根据官方描述,smithtune 的完整链路为:LangSmith traces → 在 Fireworks 上做托管 SFT → 评估(eval)→ 部署(deploy)。
这条路径的关键在于以 LangSmith 追踪到的真实运行数据(traces)作为微调语料的起点。开发者在生产或测试环境中通过 LangSmith 记录下来的模型调用轨迹,可以直接转化为训练样本,用于对模型进行监督微调。
为什么 traces 作为起点很重要
用真实的追踪数据做微调,相比人工构造的数据集,更贴近应用的实际使用场景。这些 traces 包含了真实用户输入、模型响应以及上下文信息,理论上能让微调后的模型在特定任务上表现得更加对齐业务需求。这也是把追踪平台(LangSmith)与微调能力打通的价值所在——数据不再需要在系统间来回搬运。
LangSmith 的 traces(追踪记录)本质上是对 LLM 应用运行过程的结构化日志,记录了每一次调用链中的输入、输出、中间步骤、延迟、token 消耗等信息。与传统机器学习中需要人工标注的训练集不同,traces 是应用在真实场景下自然产生的数据,天然携带了业务上下文。在构造 SFT 数据集时,开发者可以从 traces 中筛选出"好的"响应(例如评分高、用户满意、符合预期的样本)作为正例,形成"输入→理想输出"的配对数据,直接用于监督微调。这种方式有时也被称为"从生产数据中蒸馏",其优势在于数据分布与实际推理时高度一致,能有效减少微调后模型在线上的表现落差。
托管式 SFT 降低门槛
微调过程在 Fireworks 上以托管方式运行,开发者不需要关心 GPU 资源调度、训练框架配置等底层细节。这对没有专职 MLOps 团队的中小团队尤其友好,等于把训练基础设施的运维负担外包出去。
监督微调(Supervised Fine-Tuning,SFT)是目前最主流的大模型定制化手段,其核心思路是在预训练模型的基础上,用带标注的"输入-输出"对继续训练,使模型的行为向目标分布靠拢。相比全量预训练,SFT 所需的数据量和算力要小得多,但仍需要 GPU 集群、分布式训练框架(如 DeepSpeed、FSDX)以及完善的检查点管理和实验追踪能力。对多数应用开发团队而言,这些基础设施的搭建和维护成本极高。Fireworks 作为面向推理和微调的托管平台,将这部分复杂度封装在服务层,开发者只需提供数据和目标模型,训练过程的资源调度与管理由平台负责,大幅降低了 SFT 的工程门槛。
一条 CLI 的意义
官方强调的 "One CLI, no training infra"(一条命令行,无需训练基础设施),是这次发布最直观的体验改进。
开发者上手只需两步:
- 获取一个 Fireworks API key;
- 运行 smithtune 命令。
这种设计延续了近年来 AI 工具链 "降低微调门槛" 的整体趋势。微调本身不再是少数具备深厚基础设施能力的团队的专利,而是逐渐变成应用开发者工具箱里的常规能力。命令行式的交互也便于集成进 CI/CD 流程,实现模型迭代的自动化。
将微调集成进 CI/CD 流程,意味着模型迭代可以像软件版本发布一样被自动化管理。例如,当生产环境积累了足够数量的新 traces,或评估指标低于设定阈值时,可以触发 smithtune 自动执行一轮微调并将新模型推送至部署环境。这种"持续训练"的模式在传统 MLOps 领域已有实践,但在 LLM 应用层面此前门槛较高。命令行工具的存在让这条路径在工程上变得可行,是 LLM 应用向"模型随数据持续进化"范式迈进的重要一步。
对开发者生态的影响
对于已经在使用 LangSmith 做可观测性和评估的团队,这次更新补齐了 "观测—评估—优化" 中优化环节里最重的一块拼图。整个链路在同一生态内闭环,减少了跨工具切换带来的摩擦。
从更大的视角看,这也反映出 LLM 应用开发正在从 "调用现成 API" 向 "用自有数据持续优化专属模型" 演进。当追踪数据能够直接反哺模型训练,应用与模型之间形成了正向循环,长期来看有助于团队构建差异化的模型能力。
需要提醒的是,本文信息主要来自官方发布的简短公告,关于定价、支持的基础模型范围、微调效果等具体细节尚需参考官方文档进一步了解。感兴趣的开发者可以获取 Fireworks API key 后实际试用 smithtune 体验完整流程。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。