LangSmith成本失控?大规模场景下的LLM可观测性替代方案盘点
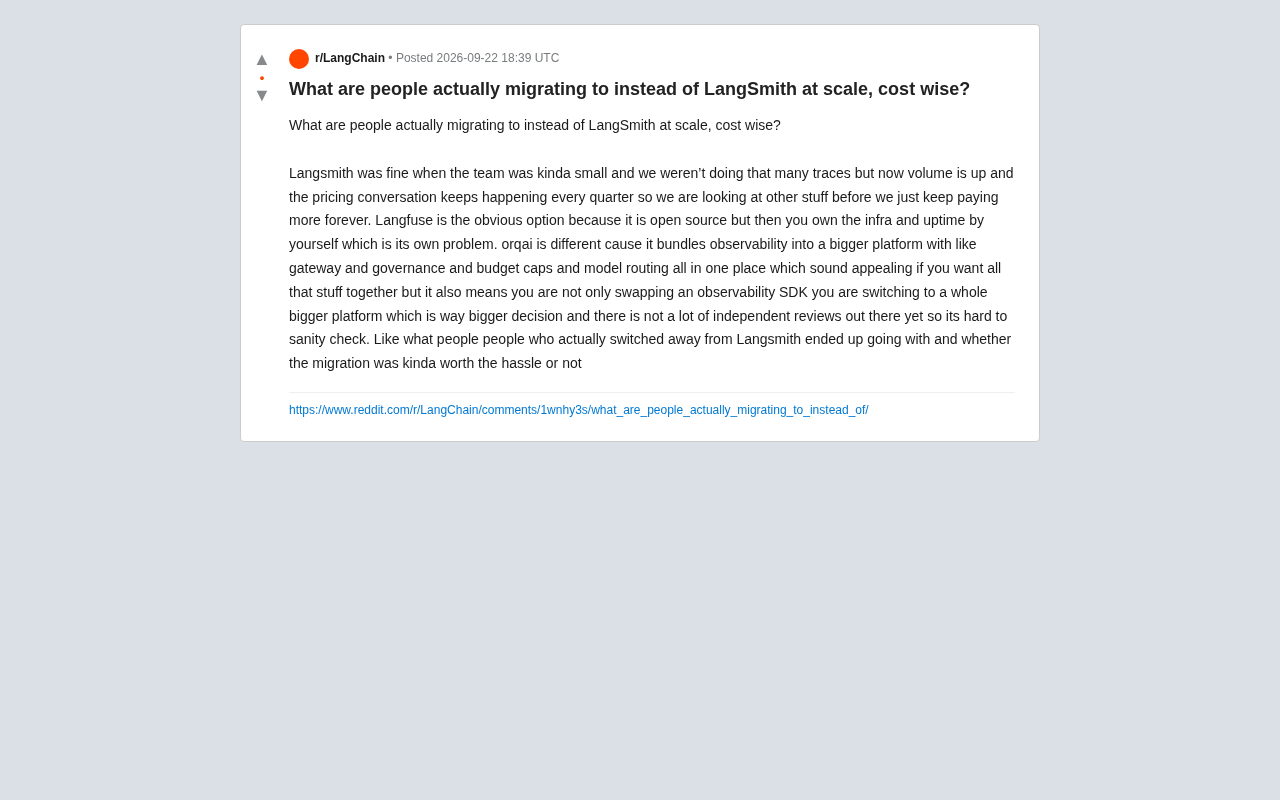
LangSmith成本随规模攀升,团队在Langfuse自托管与orqai一体化平台间权衡迁移路径
随着LLM应用进入规模化生产,LangSmith的按trace计费模式让越来越多团队面临持续上涨的可观测性账单。本文梳理了Reddit上一场典型的选型讨论,呈现了两条主要替代路径:Langfuse作为开源自托管方案,理论上能将成本从按量订阅转为固定基础设施投入,但代价是团队需自行承担运维、可用性保障与扩展性调优;orqai则代表一体化平台路线,将可观测性与网关、预算治理、模型路由捆绑,功能覆盖更广,但迁移意味着更重的架构决策,且当前缺乏足够的独立评测支撑选型验证。迁移决策的本质是在成本节省、运维负担、平台成熟度三个维度间权衡,而迁移本身的隐性成本——工作流重建与历史数据迁移——同样不可忽视。
当LLM应用从小团队试验走向规模化生产,一个绕不开的话题浮出水面:可观测性工具的成本。一位Reddit用户抛出了不少AI工程团队正在面对的现实困境——LangSmith在团队规模小、trace量不大时用得挺顺手,但随着调用量激增,每个季度都要重新评估一次定价,与其无止境地为不断上涨的账单买单,不如趁早研究替代方案。
这不是一个孤立的抱怨,而是LLM应用进入生产阶段后普遍会遇到的成本结构问题。可观测性(Observability)本质上是按数据量计费的服务,trace数量随业务增长呈线性甚至指数级上升,SaaS订阅模式的边际成本很容易失控。
问题的本质:可观测性不是可选项,而是成本变量
对于运行LLM应用的团队来说,trace和监控并非锦上添花,而是排查幻觉、追踪链路、评估模型表现的刚需。问题在于,一旦调用量上规模,托管式可观测性平台的定价模型会让成本随业务增长而水涨船高。
原帖作者的核心焦虑在于「keep paying more forever」——这种持续增长且不可控的成本曲线,是推动团队寻找替代方案的直接动力。这也解释了为什么开源自托管方案会重新进入视野:把可变的订阅成本转换为相对固定的基础设施成本。
LLM应用的可观测性(Observability)与传统软件的监控有本质区别。传统服务的trace数据相对轻量,而LLM应用的每一次调用都需要记录完整的prompt输入、模型输出、中间推理步骤(尤其是使用LangChain等框架时的多步链路)、token消耗、延迟分布以及评估结果。一次复杂的RAG(检索增强生成)调用可能产生数十个子span,数据体积远超普通API调用。这导致主流LLM可观测性平台(包括LangSmith、Langfuse Cloud、Helicone等)普遍采用「按trace量阶梯计费」的SaaS定价模型——初期用量低时单价尚可接受,一旦日活用户增长或调用频率提升,账单增速往往超过业务收入增速,形成典型的「成本剪刀差」困境。
开源自托管路线:Langfuse
Langfuse是讨论中被点名的「明显选项」,核心优势在于开源。这意味着团队可以自行部署,摆脱按trace计费的定价模式,在数据量大的场景下理论上能显著压低成本。
但开源从来不是免费的午餐。原帖作者一针见血地指出了代价:「you own the infra and uptime by yourself」——一旦自托管,基础设施的运维和可用性(uptime)就全部压在自己团队身上。这本身就是一个新的问题。
自托管的隐性成本
从SaaS切换到自托管,省下的订阅费需要和以下投入做权衡:
- 运维人力:需要专人维护部署、监控系统健康度
- 可用性保障:SLA不再由厂商兜底,宕机风险自负
- 扩展性:随着数据量增长,存储和查询性能需要自己调优
对于工程资源充裕的团队,Langfuse的账算得过来;但对于人手紧张的团队,把可观测性系统自己维护起来,可能只是把成本从财务账单转移到了工程负担上。
Langfuse于2023年开源,核心架构由Next.js前端、PostgreSQL存储trace数据、ClickHouse(可选)加速分析查询,以及Worker服务组成,支持通过Docker Compose或Kubernetes部署。它提供与LangSmith高度相似的功能集:完整的trace树视图、prompt管理、评估(evaluation)流水线和数据集管理。对于从LangSmith迁移的团队,Langfuse提供了兼容OpenAI SDK的集成方式,以及针对LangChain、LlamaIndex等主流框架的原生SDK,迁移的代码改动量相对可控。其商业模式是「开源核心+云托管版本」:自托管完全免费,云版本按席位和trace量收费,这使得数据量大的团队通过自托管能获得显著的成本优势,代价是需要自行管理数据库存储增长和查询性能调优。
一体化平台路线:orqai
讨论中提到的另一个方向是orqai,它代表了一种截然不同的思路。与Langfuse这种专注可观测性的工具不同,orqai把可观测性打包进了一个更大的平台,捆绑了网关(gateway)、治理(governance)、预算上限(budget caps)和模型路由(model routing)等一系列能力。
对于希望「所有东西放在一起」的团队来说,这种一体化方案很有吸引力——尤其是budget caps这类功能,恰好直击成本控制的痛点。
一体化的决策门槛更高
但原帖作者保持了清醒:选择orqai不再是「换一个可观测性SDK」这么简单,而是「switching to a whole bigger platform」——迁移到一个更庞大的平台,这是一个大得多的架构决策。
更现实的障碍是:目前市面上缺乏足够的独立评测(not a lot of independent reviews out there yet),这让团队很难对其做客观的可行性验证(sanity check)。对于要承载生产流量的核心基础设施,缺乏第三方背书是一个实实在在的顾虑。
orqai(Orq.ai)所代表的「LLM Gateway + 可观测性」一体化架构,是近年来兴起的另一种产品形态。其核心理念是将所有LLM调用统一经由一个中间层代理,从而在单一控制面板内同时实现:流量路由(在不同模型供应商间自动切换或负载均衡)、成本治理(预算上限、按团队/项目分配配额)、缓存(语义缓存以降低重复调用成本)、安全过滤(PII检测、内容审核)以及完整的可观测性记录。这类方案的优势在于「副作用为零的可观测性」——团队无需改动业务代码即可获得trace数据,因为所有调用本已通过网关。劣势在于网关本身成为新的关键路径,其延迟、可用性和供应商锁定风险都需要纳入评估。类似定位的产品还包括Portkey、Helicone Pro等。
迁移决策的三个权衡维度
综合这场讨论,从LangSmith迁移的选择本质上是在三个维度间做权衡:
- 成本 vs 运维负担:SaaS省心但贵,自托管便宜但要自己扛运维
- 单一工具 vs 一体化平台:专注可观测性迁移成本低,一体化平台功能全但决策重
- 成熟度 vs 前沿性:成熟工具有社区和评测背书,新平台功能新颖但验证困难
原帖最后提出的问题其实是所有面临同样处境的团队都想知道的答案:真正切换走的人最后选了什么,迁移到底值不值得这个折腾(whether the migration was kinda worth the hassle or not)。
写在最后
这场讨论没有给出标准答案,但清晰勾勒出了LLM可观测性选型的决策框架。对于正在评估LangSmith替代方案的团队,建议先明确自身处境:如果工程资源充足且数据量巨大,Langfuse的自托管方案值得认真评估;如果需要的不只是可观测性,还包括成本治理和模型路由,那么orqai这类一体化平台可以纳入考量,但务必做好充分的POC验证。
无论选哪条路,都别忘了迁移本身的隐性成本——切换可观测性栈不仅是技术工作,还涉及团队工作流的重建和历史数据的迁移。有时候「值不值得折腾」的答案,取决于你现在的账单到底有多痛。
相关推荐
从奥斯卡到SVM算法:John Platt谈AI如何重塑科学研究
谷歌奥斯卡得主 John Platt 谈 AI 如何重塑科学研究:从 sklearn 中的 SVM 算法到自动化科学、气候变化应对,以及超级智能时代下一代人如何为科学做贡献。
Snorkel AI估值翻三倍达35亿美元,AI训练数据成新风口
AI数据服务公司Snorkel AI完成3.5亿美元E轮融资,估值翻三倍至35亿美元。本文解析AI训练数据为何成为资本新风口,以及数据即服务模式背后的行业信号。
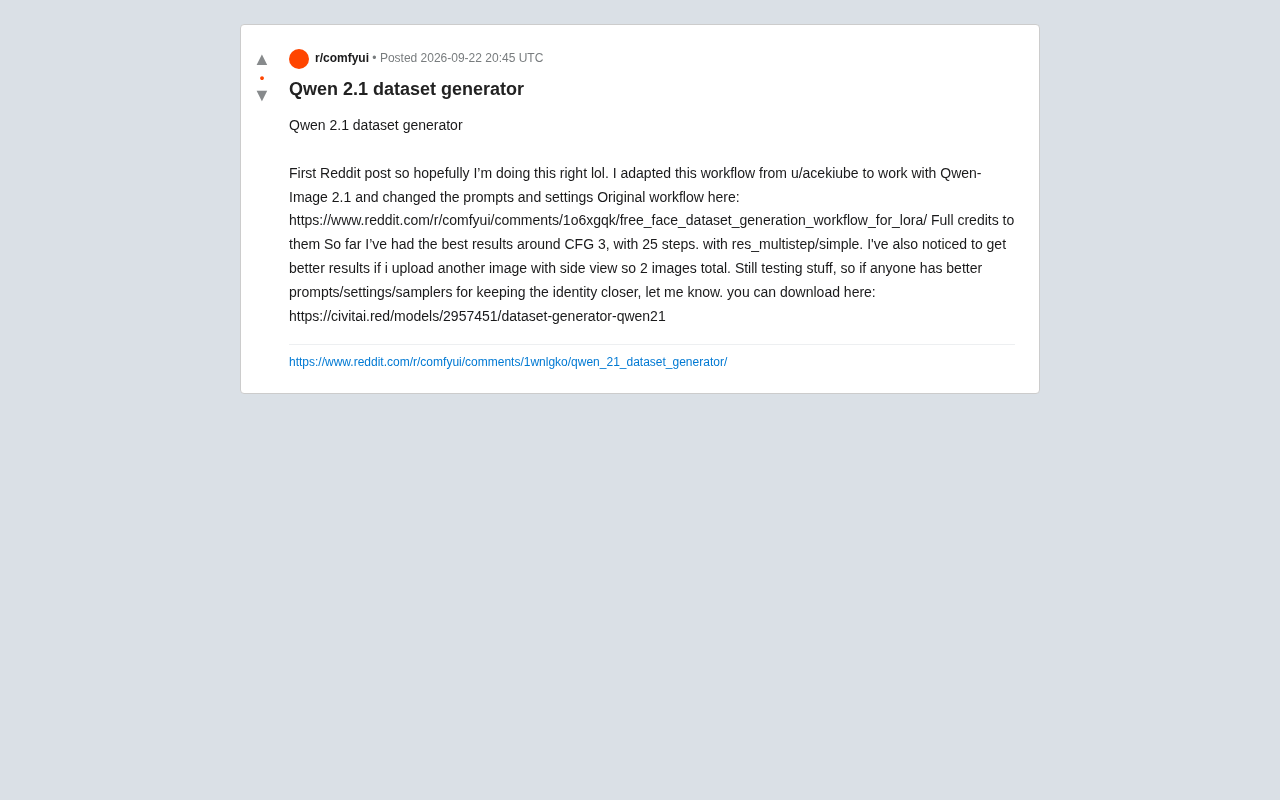
Qwen-Image 2.1 数据集生成器:LoRA训练人脸素材新工作流
一位Reddit用户分享了基于Qwen-Image 2.1的LoRA数据集生成工作流,改编自社区方案。文章解析其CFG 3、25步、res_multistep采样器等关键参数,以及双图输入提升人脸身份一致性的实用技巧。