LangSmith评估滞后真相:CI通过后如何对账?

LLM 应用中延迟真值使 CI 通过只能代表同步验证成立,需两阶段对账与历史可归因。
文章从 Reddit 社区的一个提问出发,讨论 LLM 工作流在 CI 中评估通过、但真实可信结果要数天后才到达时,这次 PASS 究竟意味着什么。核心问题是同步评估与滞后真相之间的时间错位:CI 只能覆盖 schema 和确定性约束,无法代表最终业务正确性。作者介绍了提问者提出的两阶段方案——同步阶段做结构与契约校验并把外部依赖结果标为 PENDING,异步阶段在固定契约下把延迟真值关联回原始 run 并重新评估。文章强调历史可归因是最大难点,需要 pin 住契约、评估器版本与产物哈希。最后比较了更新原结果、创建独立对账 run、维护外部验证账本三条实践路线,并建议将评估状态显式多态化。
LangSmith评估滞后真相:CI通过后如何对账?
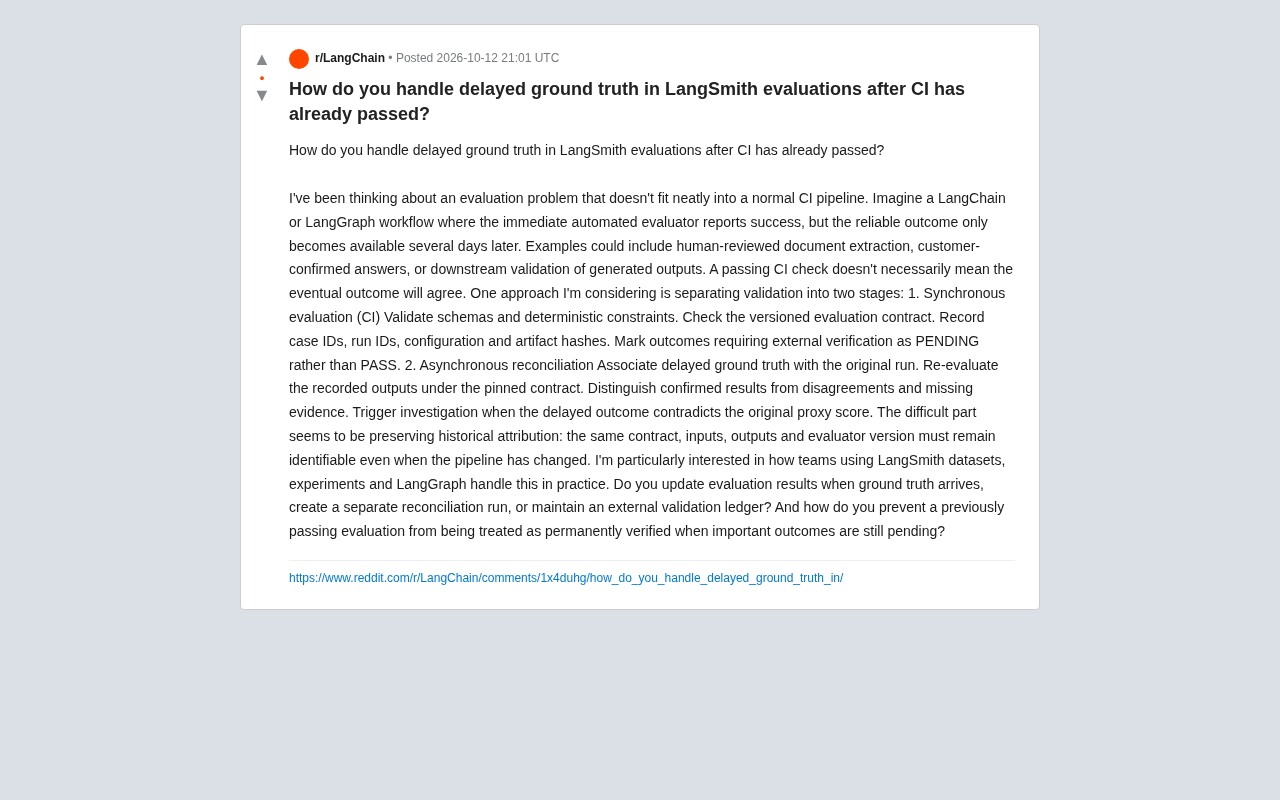
在 Reddit 的 LangChain 社区里,有人抛出了一个很多做 LLM 应用工程化的人迟早会撞上的问题:如果你的 LangChain 或 LangGraph 工作流在 CI 里跑通了、评估器给了满分,但真正可信的结果要几天后才拿得到,那么那次 CI 通过到底还意味着什么?
提问者给出的典型场景很有代表性——人工复核的文档抽取、客户确认的回答、生成内容在下游系统里被验证。这些场景的共同点是:同步评估只能覆盖结构和确定性约束,无法代表最终业务正确性。一次绿色的 CI 检查,和几天后回来的真值,完全可能互相打脸。
问题本质:同步评估与滞后真相的时间错位
CI 评估的假设是「输入决定输出,评估即时可得」。但真实生产里,很多任务的真值来源在时间上根本不配合你——它来自人工、客户、或下游系统,天生带延迟。
于是出现了一个尴尬状态:一次评估在 CI 里被标记为 PASS,但这个 PASS 只对「当时可验证的部分」成立,对尚未回来的真相没有任何承诺。如果团队把这次 PASS 当成永久验证,后续的失败案例就会被淹没在绿色记录里,回归检测失效。
据提问者描述,他考虑的方案是把验证拆成两段:同步阶段负责 schema 校验、确定性约束检查、版本化评估契约核对,并记录 case ID、run ID、配置与产物哈希,把需要外部验证的结果标为 PENDING 而不是 PASS;异步阶段则负责把延迟到达的真值关联回原始 run,在固定的契约(pinned contract)下重新评估已记录的输出,区分「确认正确」「分歧」和「证据缺失」,并在延迟结果与原始代理分数矛盾时触发调查。
这个拆法的聪明之处在于:它把 PASS 从「结论」降级为「阶段性状态」,给后续对账留了入口。
**真值(ground truth)**在机器学习与 LLM 评估语境里,指的是对某个输入而言被公认为「正确答案」的标签或输出。传统监督学习里,真值通常由标注团队在训练前一次性准备好,成本可控、获取即时。但在 LLM 应用的工程化场景里,真值的来源发生了根本变化:它可能来自人工复核员的最终判定、客户对生成回答的确认、或下游业务系统实际执行后的反馈。这些来源不仅比 CI 环节慢,而且延迟时间不稳定——可能几小时,也可能几天。延迟真值(delayed ground truth)因此成为一个独立的工程问题:你无法在评估发生的那一刻就拿到它,只能先把 run 的结果冻结下来,等真值回来后再做一次「事后对齐」。
最难的部分:历史可归因性
提问者自己点出了真正的硬骨头——历史归因。当 pipeline 已经改动过之后,你还得能识别出「当时用的是哪份契约、哪组输入、哪份输出、哪个版本的评估器」。
这不是一个纯粹的存储问题,而是评估语义的问题。如果契约(contract)本身可以漂移,那么几天后拿旧真值去对账时,你可能连「这次失败该归咎于模型还是归咎于契约变更」都说不清。所以 pin 住契约版本、评估器版本、产物哈希,是让对账结果可信的前提。
这也解释了为什么提问者强调「重新评估要 under the pinned contract」——不是拿最新评估器去评历史输出,而是把当时的那套判据原样搬出来。
**评估契约(evaluation contract)**指的是在一次评估开始前,团队对「用什么输入、跑什么流程、由谁判、按什么标准判」达成的显式约定。它至少包含四类信息:输入数据集或 case 集合的版本、被评估 pipeline 的配置与产物哈希、评估器(evaluator)的版本、以及判定阈值或评分规则。把契约 pin 住,意味着这些内容在评估发生时被快照化,之后任何一次对账都必须引用当时的快照,而不是用最新配置去重跑。没有 pin 契约,延迟真值回来时你面对的是一个已经漂移的评估环境,「这次失败是模型退步还是评估器变严」将无法回答。这也是为什么评估契约要把版本信息纳入 CI 检查——它同时是回归检测的锚点。
实践中的三条路线
提问者向社区抛出了几个具体选项,实际也代表了团队常见的三种做法:
更新原评估结果。 真值到达后直接改写原来那次 run 的评估记录。优点是单一事实来源,缺点是会破坏评估历史的不可变性,审计时很难说清哪个分数是当时产生的。
创建独立的对账 run。 保留原始 run 不动,新建一个 reconciliation 运行来记录延迟真值及其匹配结果。历史清晰、可追溯,代价是查询时要跨 run 关联,报告逻辑更复杂。
维护外部验证账本(validation ledger)。 在 LangSmith 之外单独存一份对账表,记录 run ID、契约版本、真值到达时间、一致性结论。灵活度最高,但也意味着评估状态被拆到两个系统里。
至于怎么防止「一次 PASS 被当成永久验证」,社区共识方向是把状态做成显式的多态:PASS、PENDING、CONFIRMED、DISAGREED、MISSING_EVIDENCE。只要 PENDING 在报表里不被折叠成绿色,回归监控就不会误判。
**validation ledger(验证账本)**是一种在评估系统之外独立维护的对账记录,通常以表格或数据库形式存在,每一行对应一次需要外部验证的 run。它的字段一般包括:run ID、case ID、契约版本、评估器版本、产物哈希、真值到达时间、一致性结论(CONFIRMED/DISAGREED/MISSING_EVIDENCE)。之所以要把账本放在 LangSmith 之外,是因为 LangSmith 的 experiments 模型假设评估在 run 结束时完成,缺少表达「真值稍后到达」的原生字段。账本方案的代价是状态被拆到两个系统,查询时需要 join,但它也带来了最大灵活性:可以自定义对账周期、告警规则和报表口径,而不受评估框架的数据模型约束。
对 LangSmith 用户的启示
这个讨论的价值不只在 LangSmith 本身,而在于它暴露了 LLM 评估工程的一个结构性缺口:大多数评估框架是按「即时评估」设计的,而很多真实业务指标天然滞后。
对正在用 LangSmith datasets、experiments 和 LangGraph 的团队来说,可以落地的最小动作是:在评估契约里显式引入延迟真值字段和对账状态,把需要外部验证的 case 从「通过/失败」二元判断里拆出来。这样 CI 依然能快速反馈,但对账阶段有据可依,历史也能保持可归因。
如果你也遇到类似的时间错位问题,不妨先在团队内部明确一件事:你们的 PASS,究竟是「已验证」,还是「暂时没发现问题」。这两个词背后的工程含义,差了整整一套对账机制。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。