老板在卖你的数据?AI公司高价收购工作消息
AI公开语料枯竭,科技公司转向收购员工邮件与Slack记录训练模型。
文章从 Google 以约 1000 万美元收购破产公司 Sprint Airlines 的 1 亿封邮件和 5 亿条 Teams 消息切入,解释这一高价背后的逻辑:公开互联网文本已被 AI 公司接近耗尽,高质量语料日益稀缺,数据价值重心转向「真实工作如何发生」的对话、争论与决策记录。更值得警惕的是,数据经纪商已开始向仍在运营的公司出价六到七位数收购 Slack 私信和邮件,再转售给 AI 实验室。员工既是这些数据的创造者,却通常不被征询、也拿不到分成。文章指出工作数据商业转售在所有权归属、隐私边界和收益分配上都缺乏清晰规则,并追问创造者是否应分享收益。
当一家公司破产时,它的数据资产往往会被摆上货架。据YouTube视频披露,Sprint Airlines破产后,Google花了约1000万美元买下其数据,包括1亿封邮件和5亿条Teams消息。问题来了:为什么有人愿意为旧工作邮件付这么多钱?
答案指向一个正在成形的趋势:AI公司对公开互联网数据的挖掘已接近饱和,它们现在想要的是「真实工作如何发生」——对话的来回、争论、决策过程。而这些数据,恰恰藏在每个员工的Slack私信和邮箱里。
旧邮件为什么值钱:AI训练数据的稀缺转向
公开互联网上的文本正被AI公司消耗殆尽。论坛、博客、新闻网站的内容早已被大规模抓取,高质量、多样化的公开语料越来越难获取。于是,数据的价值重心开始向「非公开但真实」的内容转移。
工作场景中的沟通记录正好满足这个需求。一封邮件里可能包含项目背景、利益权衡、反对意见;一条Slack消息可能记录了一次快速决策或一次冲突化解。这些内容不是精心撰写的文章,而是人类协作的原始痕迹——对于训练AI理解真实工作流程、模拟人类决策,这类数据具有公开语料无法替代的价值。
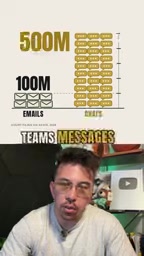
这也解释了Google的算盘:1000万美元买的不是1亿封邮件的存储空间,而是其中蕴含的「如何做事」的模式。
「公开互联网数据接近枯竭」并非修辞。Epoch AI 等机构的追踪显示,可用于训练的高质量公开文本总量约在数十万亿 token 量级,而主流大模型的训练消耗正以每年数倍速度增长,二者交汇点被普遍估算在 2026—2032 年之间。更关键的是质量维度:Common Crawl 等抓取语料中重复、低质、机器生成内容占比不断上升,需要大量过滤才能使用,等于实际可用量远低于名义存量。这催生了「数据墙」概念——模型规模继续扩大,但高质量语料供给跟不上。行业应对方式包括合成数据、多模态数据和授权私有数据,其中最后一项正是工作通讯记录被高价收购的宏观背景。
从破产公司到活公司:数据经纪商的中间生意
如果只是破产公司卖数据,这件事的影响范围还有限。但视频指出,情况已经变了。数据经纪商开始向仍在运营的公司出价,金额从六位数到七位数不等,收购它们的Slack私信和邮件,再转售给AI实验室。
这意味着,你的工作通讯记录可能正在被你的雇主当作资产变现。而整个链条中,写这些消息的人——也就是员工——通常既不被征询意见,也拿不到任何分成。
这里存在一个明显的价值错位:数据由员工创造,价值由AI公司认可,交易由雇主和经纪商完成,收益却与创造者无关。员工在入职时签署的隐私政策或数据使用条款,往往覆盖了「公司有权使用工作通讯数据」这类模糊授权,但是否包括「出售给第三方用于AI训练」,多数人并不清楚。
「数据经纪商」在美国法律语境下指专门收集、整合并转售消费者或商业数据的公司,受《公平信用报告法》等部分约束,但长期处于监管灰区。传统业务是人口统计、消费行为和营销画像,近年则扩展到 AI 训练语料采购:由经纪商出面与数据持有方谈判、做脱敏与授权链条梳理,再打包卖给实验室,从而让 AI 公司避免直接面对众多数据主体。这一模式的关键风险在于授权是否「可传递」——雇主与员工之间的数据使用条款,未必允许将内容转售给第三方;经纪商的介入并不自动补齐这一授权缺口,反而可能让责任链条更模糊。
员工数据权益:一个尚未被回答的问题
视频最后抛出的问题很直接:如果你旧消息值几百万,你应该分一杯羹吗?
从法律角度看,工作场景中产生的通讯数据归属复杂。雇主通常主张对工作设备和通信内容的所有权,员工则可能认为私人对话内容涉及个人隐私。现行法规对「工作数据商业转售」的界定并不清晰,尤其是当数据被用于AI训练这种新兴用途时。
从伦理角度看,AI公司购买工作数据训练模型,本质上是在将人类的协作经验商品化。员工在Slack里争论方案时的思考过程、在邮件里安抚客户时的措辞选择,都成了模型能力的养料。如果这些数据确实价值千万,创造者被完全排除在收益分配之外,这种安排是否可持续,值得追问。
目前来看,这个问题没有现成答案。但可以确定的是:随着AI公司对高质量工作数据的需求持续上升,雇主、员工、数据经纪商和AI实验室之间的利益博弈只会更加频繁。作为员工,了解自己的工作通讯可能被如何处置,是这场博弈中最起码的一步。
欧盟《通用数据保护条例》(GDPR)赋予数据主体访问、更正、删除和反对处理的权利,但第 88 条允许成员国通过劳动法对雇佣场景中的数据处理作出更具体规定,实践中员工的反对权常受限于雇主的「正当利益」。美国则缺少统一的联邦隐私法,工作通讯内容多依公司政策与各州法律处理,加州《消费者隐私法》对雇佣场景的适用也经历了分阶段扩展。中国《个人信息保护法》第 13 条允许「为订立、履行个人作为一方当事人的合同所必需」处理个人信息,但将工作数据用于 AI 训练通常超出「必需」范围,需另行取得同意。总体而言,跨司法辖区看,工作通讯数据能否商业转售,仍是立法与判例尚未闭合的空白。
相关推荐

Claude Code v2.1.330 更新解读:组织登录、内置图表与海量修复
Claude Code v2.1.330 发布,新增企业组织登录、内置图表工具 easel、自托管运行器指标,并修复压缩冻结、WebFetch 卡顿、设置丢失等大量问题。本文解读关键更新。
Replit Desktop发布:云端模型本地执行,Agent触及浏览器盲区
Replit 推出 Replit Desktop,让 AI Agent 在本地沙箱中执行代码并访问用户指定的文件夹,模型仍在云端运行。本文解析其云端推理加本地执行的混合架构、微软 Execution Containers 沙箱与权限控制设计。
纳斯达克回吐全年涨幅:科技股AI行情遭遇压力测试
纳斯达克综合指数回吐全部2026年年内涨幅,据Hacker News消息。本文分析这一信号对AI科技股叙事、融资环境与开发者决策的含义,并提醒避免单一归因的解读陷阱。