老代码交给AI改,为什么先写AGENTS.md是错的?

老仓库交给AI前应先给测试当裁判,再让AI自己画地图。
文章提出一个反直觉的迁移顺序:把老代码库交给AI重构前,应先提供可靠的测试而非详尽的AGENTS.md。原因是Claude Code等工具在“觉得活干完了”时就会停止,测试是它唯一的退出条件和正确性裁判。地图(文件依赖关系)可由AI和确定性工具自行绘制,人只需补充项目特有的隐含要求。检查应按从便宜到贵的顺序执行,任何一关失败即丢弃改动。对没有测试的遗留代码,可让AI生成特征测试锁定现有行为。但测试全绿不等于质量达标,Burn迁移后仍出现19个语义回归,需模糊测试与安全审查补位。
把跑了十年的老仓库交给AI重构,大多数人的第一反应是写一份详尽的AGENTS.md,把每个模块的职责、架构、注意事项都交代清楚。但Kaolab在B站分享的一个反直觉观点是:这个顺序应该反过来——先给测试,再给地图。因为地图AI自己画得出来,而"改对了没有"它给不了自己。
测试是AI改代码的退出条件
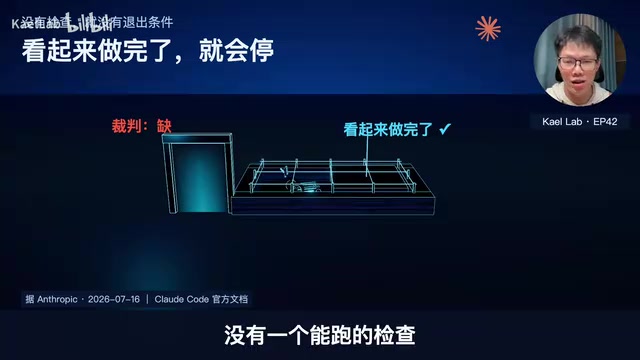
Anthropic在一篇大规模代码迁移的总结中,把"先有一个靠得住的裁判"排在所有步骤之前。原因很直接:Claude Code的官方文档写明,它觉得活干完了就会停。如果没有一个能跑的检查,"看起来做完了"就是它唯一的信号——这次迁移既没有退出条件,也无法衡量成功。
反例很有说服力:Burn把53万行Zig代码交给Claude翻成100多万行Rust,合并前测试套件全部通过,包含100多万条断言(测试用TypeScript写,与实现语言无关,所以换语言不用换裁判)。可即便全绿,合并后还是冒出了19个细小的语义回归。测试覆盖率说明它没有违反测试写下来的那部分行为,没写下来的那部分,测试管不到。
地图该由谁来画
地图当然要有。AIbin在迁移测试文件时自己总结的头号成功因素是:给它挑出正确相关的文件。问题在于这张地图该让谁来画。
Claude Code文档专门列了AGENTS.md不该写什么:逐个文件介绍代码库的内容不写,它读代码就能搞清楚的东西也不写。该写的是它猜不到的东西——要跑的命令、项目特有的架构决定、那些不明显的坑。至于文件之间谁引用谁,交给工具去查:Google在内部代码迁移中用代码索引顺着引用一层层往外找,Anthropic的迁移总结里依赖关系也是用确定性脚本画出来的。
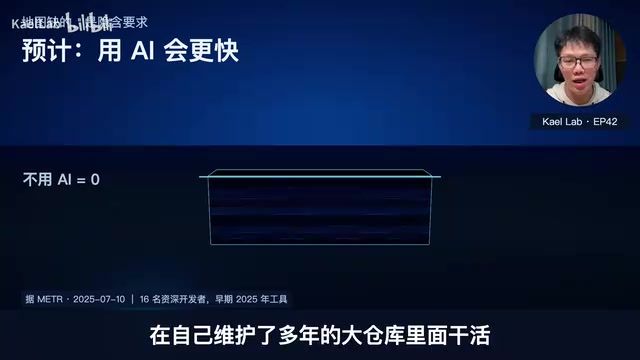
人手写的那几行为什么反而值钱?METR做过一个随机对照实验:16位资深开源开发者在自己维护多年、平均超过100万行代码的大仓库里干活,用AI之前他们预计能快24%,实际结果却是比不用AI慢了19%。研究者给出的解释之一是,这类项目里有大量隐含要求——文档怎么写、测试覆盖到什么程度、格式怎么排——人要花很长时间才学得会。地图上真正缺的正是这一块,而它恰恰是AI读代码读不出来的。
检查要按从便宜到贵的顺序过
Google那套迁移流程里,大模型改完的每一处都要按从便宜到贵的顺序过检查:空白、语法、语法解析、编译,最后跑回归测试。任何一关没过,这次改动直接丢掉,交给人来改。39次迁移、595个代码变更中,74%是大模型生成的。论文还记录了一个失败原因:有些测试本来就是红的,测试那一关根本跑不起来——所以测试不关要用,交给他之前还得先保证主干是绿的。
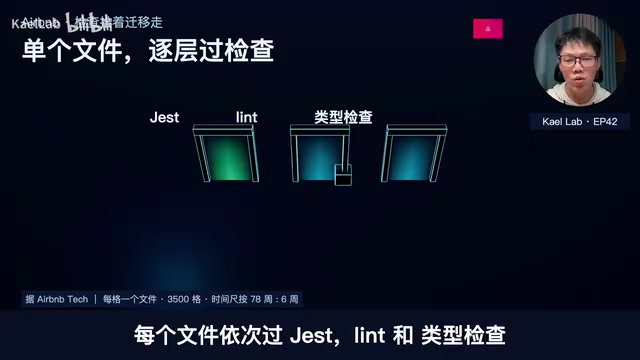
AIbin的做法同样是由检查来驱动:3500个测试文件从Enzyme迁移到React Testing Library,每个文件依次过just、lint和类型检查,哪一层报错才把报错交给大模型去修。4个小时迁完75%,又调了4天推到97%,原本估计人工要一年半,最后6周做完。他们自己的总结是:反复重试比把提示词磨到完美更管用。
模糊测试(Fuzzing) 是一种自动化软件测试技术,通过向程序持续输入大量随机或半随机的畸形数据,观察程序是否崩溃、挂起或产生异常行为,从而发现边界条件和未处理输入导致的缺陷。它与单元测试的互补性在于:单元测试验证的是开发者“想到并写下来”的场景,而模糊测试能覆盖人意料之外的输入组合。实践中常配合覆盖率引导(coverage-guided)策略,让变异器优先探索尚未被覆盖的代码路径。文中所说的“不间断的模糊测试”,即持续集成中长时间运行的 fuzz 任务,适合在 AI 生成的大规模代码上补足传统测试覆盖不到的安全与健壮性盲区。
老代码没有测试怎么办
最难的情况是老代码根本没有测试。Michael Feathers在《修改代码的艺术》(Working Effectively with Legacy Code)里给遗留代码下的定义就是"没有测试的代码"。他的方法是:先找到要改的点,再找能测的点,解开依赖,写好测试,最后才去改代码。这时写的测试叫特征测试(characterization test)——它不判断代码对不对,只把当前行为原样记下来,连bug一起锁住。
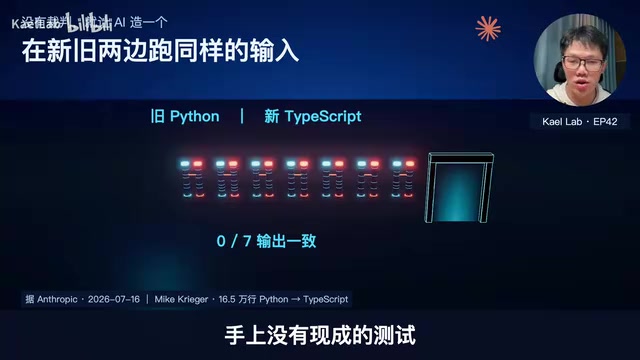
这一步现在可以交给AI。Anthropic那篇总结的原话是:继承不到裁判,就让Claude造一个,原来的代码库永远是标准答案。Mike Krieger把165,000行Python迁移到TypeScript时手上没有现成测试,就让Claude写了个脚本,拿7个真实场景在新旧两边一起跑、对比输出,一直修到7个全部通过:裁判到位了,还要故意把代码改坏,确认它真的会红。
特征测试(Characterization Test) 是 Michael Feathers 在《修改代码的艺术》中提出的概念,指在修改遗留代码前编写的、用于锁定代码当前实际行为的测试。与常规测试不同,它不以“正确性”为标准——即使代码存在 bug,测试也会把 bug 的行为原样断言下来,目的是建立一张“行为快照”,使后续重构或迁移一旦无意改变现有行为就能立刻被发现。编写特征测试的典型流程是:在代码中寻找可观测的输出点(返回值、日志、副作用),为其编写断言,然后运行并记录实际结果作为期望值。由于它只关心“是否变化”而非“是否正确”,非常适合作为 AI 迁移过程中的裁判:旧系统即为标准答案,新实现必须逐字节对齐旧行为。
测试是AI的退出条件,不是质量的证明
回到Burn那19个回归。Zig语言的作者Andrew Kelley曾公开质疑,这套测试够不够兜住100万行没人逐行评审过的代码。Burn后来做了11轮安全审查,给每个解析器挂上不间断的模糊测试,又修出了15个PR。这说明即使测试全绿,也不能把"通过测试"等同于"质量达标"。
所以老代码库交给AI之前,先问三件事:有没有一条命令能告诉他改对了没有?这条命令现在主干上是不是全绿的?故意改坏一处,它会不会变红?三个都是,再让他自己去画地图——你只管去补那几行他从代码里读不出来的东西。
核心要点:
- 测试是AI改代码的退出条件,决定它何时停、改得对不对
- 地图该由AI画,人只需补它读不出来的项目隐含要求
- 检查按从便宜到贵的顺序过,任何一关失败直接丢弃改动
- 老代码没测试时,让AI生成特征测试,把现有行为连bug一起锁住
- 全绿不等于质量达标,模糊测试与安全审查仍需补位
背景补充
语义回归(Semantic Regression) 指代码在语法、编译和既有测试全部通过的情况下,行为却在语义层面发生了细微而真实的改变。这类问题难以被测试捕获,因为测试只断言了编写者显式写下的那部分行为契约;未被测试覆盖的语义——例如浮点精度处理、空值边界、错误码映射、迭代顺序——一旦在重写中悄悄改变,就可能在下游引发难以定位的故障。这也是“全绿不等于质量达标”的技术根源:测试覆盖率本质上是“已写断言的行为占比”,而非“全部行为的正确性证明”。因此大规模自动迁移后,通常需要补充差分测试、模糊测试与人工审查来兜住语义层面的遗漏。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。