老派分类器仍胜Jev:嵌入+sklearn误差降37%
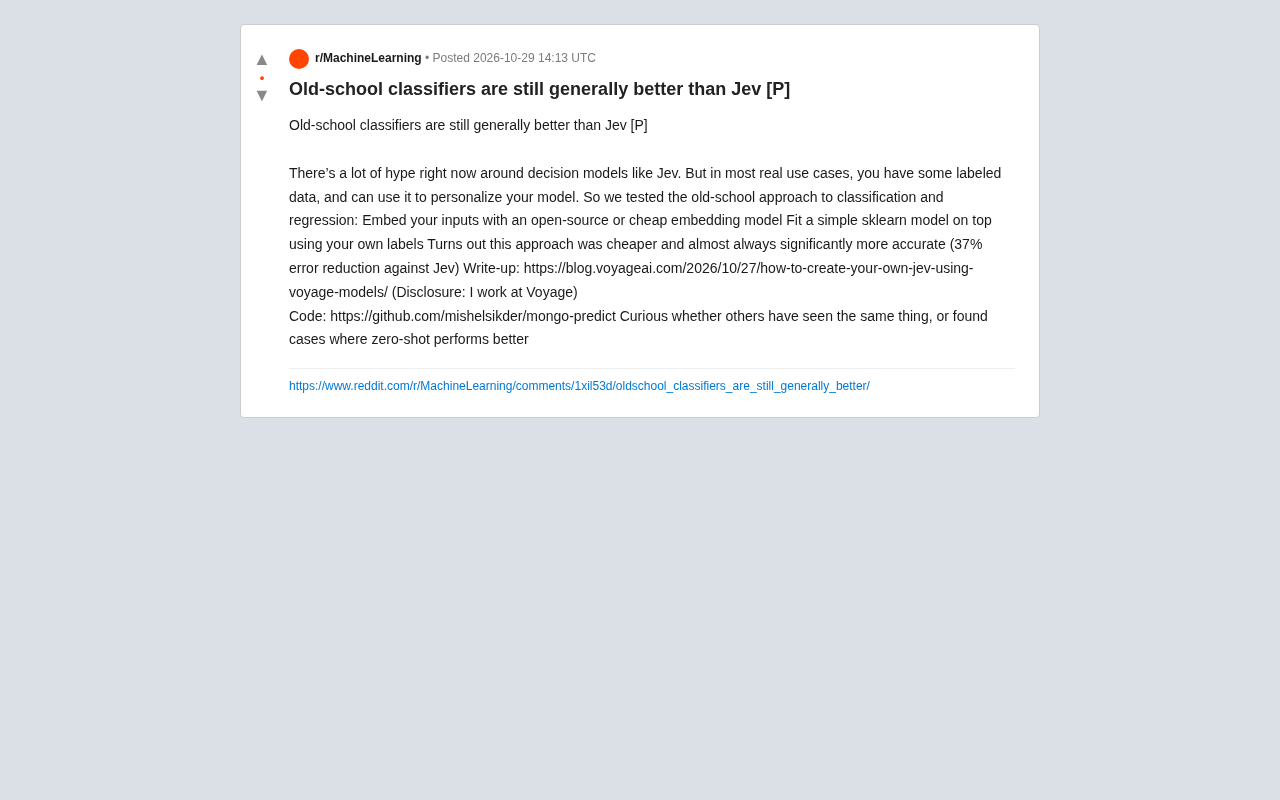
有标注数据时,嵌入加sklearn比零样本决策模型Jev错误率低37%且更便宜。
Voyage AI 工程师在 Reddit 分享的测试显示,用开源或低成本嵌入模型将输入转为向量,再在其上训练简单 sklearn 分类器或回归器,相比当红的零样本决策模型 Jev,成本更低且几乎总是显著更准,错误率相对降低 37%。该方案本质是深度学习兴起前的标准 NLP 流程,作者强调真实场景中通常总有可用标注数据。讨论由此引出零样本与有监督方法的边界问题:有标注数据时嵌入加浅层模型往往更优,缺乏标注或任务需要复杂推理时决策模型仍有价值,嵌入质量与领域匹配度也会显著影响结果。作者开源代码并邀请社区提供反例。
当红决策模型Jev,为何输给老派分类器?
Reddit上一位来自Voyage AI的工程师发帖称,他们测试了传统分类与回归方案:用开源或低成本嵌入模型处理输入,再在嵌入之上拟合一个简单的sklearn模型。结果这个方案比当红的决策模型Jev更便宜,且几乎总是显著更准——错误率降低了37%。
帖子引发了不少讨论:在拥有标注数据的现实场景中,零样本决策模型是否被高估了?
实验设计:嵌入+sklearn的极简组合
据发帖人(Voyage员工,已披露利益相关)描述,测试方案非常直接:
- 使用开源或便宜的嵌入模型将输入文本转为向量
- 用自有标注数据训练一个简单的sklearn分类器或回归器
- 与Jev这类决策模型进行效果和成本对比
这种“嵌入+浅层模型”的做法在深度学习兴起前是NLP分类任务的标准流程,如今常被视为“老派”。但作者强调,在大多数真实用例中,你总有一些标注数据,完全可以用来个性化模型。
嵌入模型(Embedding Model) 是一类将离散输入(文本、图像等)映射为稠密向量的神经网络模型,代表如 OpenAI 的 text-embedding-ada-002、Voyage AI 的 voyage 系列,以及开源 BGE、E5、GTE 等。其核心特性是语义相近的输入在向量空间中距离更近,因而可以直接作为下游模型的输入特征。与直接生成答案的大模型不同,嵌入模型只负责"表征",参数量更小、推理成本低得多,且不依赖提示词工程。在本实验中,嵌入模型的角色是把原始文本压缩为定长向量,从而让一个浅层分类器可以在低维空间中学到判别边界。
sklearn(scikit-learn) 是 Python 生态中最主流的经典机器学习库,提供逻辑回归、支持向量机、随机森林、梯度提升等大量现成算法。它的特点是接口统一、训练极快、可解释性强,在数百到数万条样本规模上通常只需数秒即可完成拟合。所谓"在嵌入之上拟合一个简单的 sklearn 模型",本质是把嵌入向量当作特征输入,训练一个监督分类器或回归器,属于典型的"特征提取 + 浅层学习"两段式范式。
成本与精度双赢:37%误差降低意味着什么
最核心的发现是:老派方案不仅更便宜,而且几乎总是显著更准确,错误率相对Jev降低了37%。这意味着在相同数据条件下,传统方法能带来更少的误判,同时避免调用昂贵决策模型的成本。
作者在Voyage AI博客中给出了完整写-up,代码也已在GitHub开源(mongo-predict),方便复现。
零样本 vs 有监督:何时该用哪种?
发帖人最后抛出一个问题:是否有人见过零样本表现更好的场景?这触及了方法选择的关键——
- 有标注数据时:嵌入+sklearn通常更优,尤其当标注量足以覆盖任务分布
- 零样本场景:缺乏标注数据时,Jev这类决策模型仍有价值
- 任务复杂度:对于需要复杂推理的任务,决策模型可能占优,但简单分类回归任务中传统方法不落下风
讨论中也有用户指出,嵌入模型的质量和领域匹配度会显著影响最终效果。
零样本(Zero-shot) 指模型在完全没有见过目标任务标注样本的情况下直接给出预测,依赖的是预训练阶段积累的通用知识与指令跟随能力;与之相对的 有监督(Supervised) 学习则需要一定数量的"输入—正确输出"配对样本用于训练。二者并非简单的替代关系:零样本的优势是启动成本为零、可快速覆盖长尾任务,但精度受制于任务与预训练分布的匹配度;有监督方法在标注充足时通常精度上限更高,但需要标注投入且难以泛化到分布外数据。
实践中常被忽视的中间地带是 少样本(Few-shot)微调 与 提示学习(Prompt Learning):当标注量只有几十到几百条时,直接训练分类器容易过拟合,此时可考虑用少量样本做嵌入模型微调,或采用 k 近邻分类(在嵌入空间中找最近邻标签)。因此方法选择应沿着"标注量—任务复杂度—成本预算"三个维度权衡,而不是在零样本与全监督之间二选一。
对从业者的启示
这项测试提醒我们,在追逐新模型之前,先确认手头是否有标注数据。如果有,一个便宜的嵌入模型加sklearn可能就能解决问题,且效果更好、成本更低。这并非否定决策模型的价值,而是强调方法选择应基于数据条件和任务需求,而非热度。
作者也邀请社区分享相反案例,以更全面地理解两种范式的边界。
相关推荐
Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。

Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。
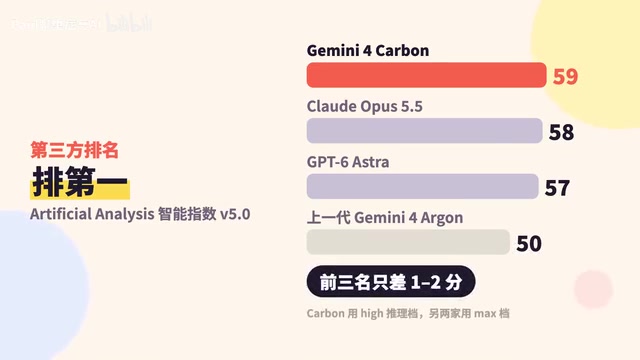
谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。