LARA:为冻结大模型注入可组合行为的轻量适配方案
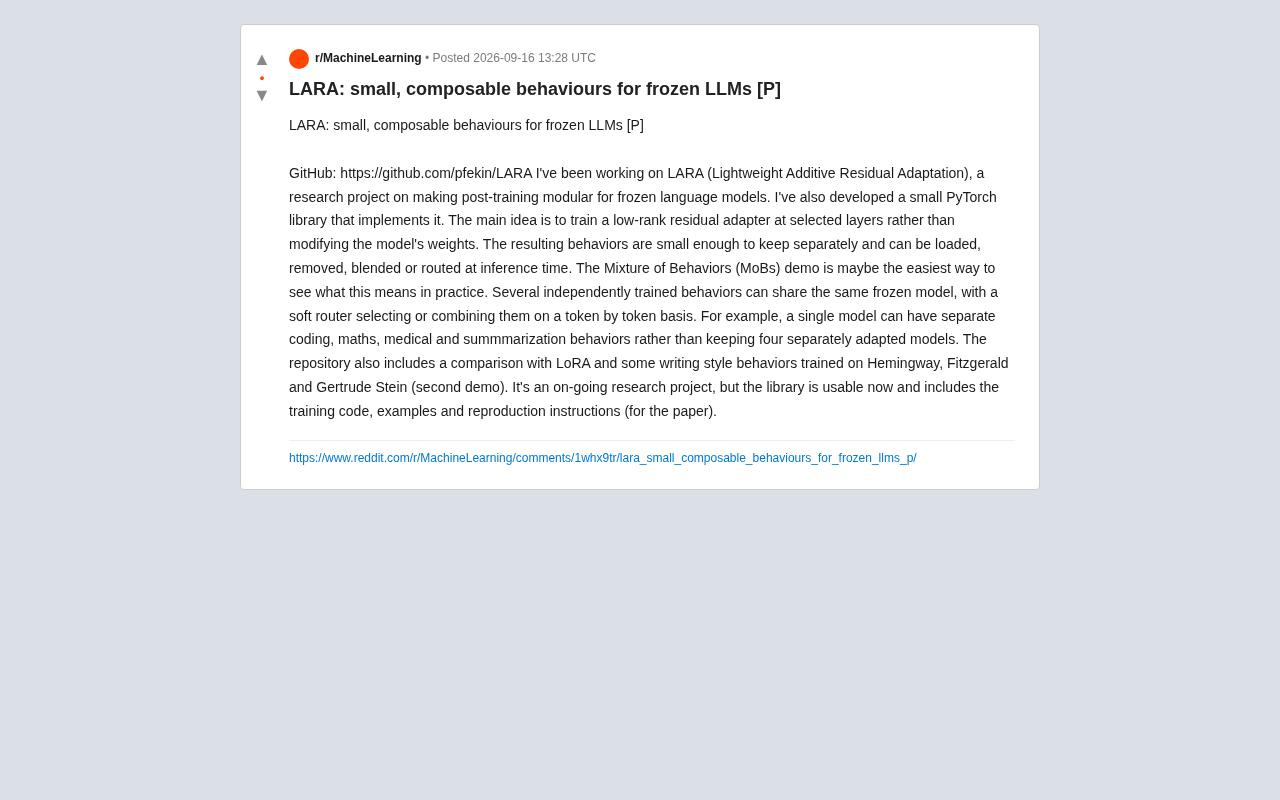
LARA 通过低秩残差适配器与软路由机制,让多种行为以插件形式共享同一冻结大模型。
LARA(轻量加性残差适配)是一个面向模块化后训练的开源研究项目,核心思路是在冻结的语言模型选定层上叠加低秩残差适配器,将「行为」封装为可单独保存、按需加载或移除的轻量模块。项目的标志性演示「Mixture of Behaviors」允许编程、数学、医疗、摘要等多个独立行为共享同一基础模型,并由 token 级软路由器动态选择或融合,本质上是 MoE 思想的极轻量化变体。仓库还提供了与 LoRA 的直接对比实验,以及模仿海明威等作家文风的风格化行为演示。配套 PyTorch 库已可用,含完整训练代码与论文复现说明。目前该项目仍处于研究阶段,缺乏第三方独立评测,软路由稳定性与相对 LoRA 的实际收益有待更多实验支撑。
在大模型微调成本居高不下的今天,一种更轻量、更模块化的思路正在被反复验证。近期一位研究者在 Reddit 上开源了名为 LARA(Lightweight Additive Residual Adaptation,轻量加性残差适配) 的项目,其核心目标是让「后训练」(post-training)变得模块化——在不改动基础模型权重的前提下,为冻结的语言模型叠加可插拔的行为能力。
LARA 到底解决了什么问题
传统的模型定制往往意味着要么全参微调、要么为每个任务单独训练一份 LoRA 适配器,随之而来的是存储膨胀和部署复杂度。LARA 的做法是在选定的若干层上训练一个低秩残差适配器(low-rank residual adapter),而不是直接修改模型的原始权重。
这带来一个直接的好处:训练得到的「行为」体积足够小,可以单独保存。更关键的是,这些行为在推理阶段可以被加载、移除、混合(blend)或路由(route)——也就是说,模型本身保持冻结不变,行为作为外挂模块灵活挂载。这种设计思路与近年来「适配器即插件」的趋势一脉相承,但 LARA 更强调行为之间的可组合性。
低秩残差适配器的设计灵感来源于矩阵分解理论:假设模型权重的更新量本质上处于一个低维子空间中,那么用两个小矩阵的乘积(即低秩分解)来近似这一更新,就能以极少的参数捕获大部分行为变化。LoRA 率先将这一思想系统化,而 LARA 在此基础上进一步强调「残差叠加」——适配器的输出以残差形式加回原始激活值,确保冻结权重的语义不被破坏。这种叠加方式在数学上等价于对原始前向传播做局部扰动,既保留了基础模型的通用能力,又为特定行为留出了专属的参数空间。体积小(通常只有原始层权重的 0.1%–1%)是低秩设计的直接结果,也是「行为即插件」可以成立的工程前提。
Mixture of Behaviors:多行为共享同一冻结模型
项目中最能体现设计理念的是 Mixture of Behaviors(MoBs,行为混合) 演示。它允许多个独立训练的行为共享同一个冻结基础模型,并通过一个**软路由器(soft router)**在 token 级别上逐个选择或组合这些行为。
作者给出的例子很直观:一个模型可以同时具备编程、数学、医疗和摘要四种独立行为,而不必维护四份各自微调过的独立模型。这在实际部署中意味着显存占用和管理成本的显著下降——基础模型只需加载一次,行为按需切换或融合。
这种 token 级别的软路由机制,本质上是在 MoE(专家混合)思想与轻量适配器之间找到了一个折中点:既保留了「专家分工」的灵活性,又避免了训练完整专家网络的开销。
MoE(Mixture of Experts,专家混合) 是 LARA 软路由机制的重要参照背景。传统 MoE 架构会在模型内部训练多个完整的「专家」子网络,并由门控网络在 token 或序列级别决定激活哪些专家;代表性实现包括 Mixtral、Switch Transformer 等。其优势是容量大、专业化强,但代价是训练所有专家网络的完整开销,以及推理时复杂的负载均衡问题。LARA 的软路由器则仅在轻量适配器层面做选择与加权融合,专家本身只是低秩矩阵而非完整网络——这使得新增或移除一种「行为」的成本接近零,且无需重新训练路由器或其他已有行为,是对 MoE 思想的一种极轻量化变体。
与 LoRA 的对比及写作风格实验
值得关注的是,项目仓库中包含了 与 LoRA 的直接对比,这为评估 LARA 的实际效果提供了参照基准。LoRA 作为当前最主流的参数高效微调方法之一,是绕不开的对照对象。作者选择正面比较,说明其对 LARA 的定位有明确的技术判断。
第二个演示则更具趣味性:作者训练了几种写作风格行为,分别模仿海明威(Hemingway)、菲茨杰拉德(Fitzgerald)和格特鲁德·斯泰因(Gertrude Stein)的文风。这类风格化行为恰好展示了「可组合行为」的表现力——理论上,用户可以在推理时混合不同作家的文风,产生介于两者之间的输出效果。
LoRA(Low-Rank Adaptation) 由微软研究院于 2021 年提出,目前已成为参数高效微调(PEFT)领域的事实标准。其核心做法是在 Transformer 的注意力权重矩阵旁并联一对低秩矩阵 A 和 B,训练时只更新这两个矩阵,推理时将其合并回原始权重(或保持分离)。LoRA 的广泛采用得益于其实现简单、显存占用低、与原模型无缝兼容等优点。然而 LoRA 适配器通常是针对单一任务或领域训练的,若需同时服务多个任务,要么合并多个 LoRA(可能产生干扰),要么为每个任务维护独立的适配器副本并在请求间切换。LARA 的差异化定位正在于此:它将「多行为共存与动态路由」作为一等公民纳入设计,而非 LoRA 的事后拼接。
工程可用性与研究定位
作者明确表示,LARA 目前仍是一个进行中的研究项目,但配套的 PyTorch 库已经可用。仓库中提供了完整的训练代码、示例,以及论文结果的复现说明(reproduction instructions),这对希望验证或二次开发的研究者相当友好。
从工程角度看,LARA 的价值在于把「一个模型 + 多个轻量行为」的范式做成了可落地的工具链。对于需要在同一基础模型上服务多种任务的场景——比如一个既要写代码、又要做摘要、还要处理专业领域问答的助手系统——这种架构能有效降低运维复杂度。
一点冷静的观察
补充一点,作为 Reddit 上的开源发布,目前公开信息主要来自作者本人的描述,缺乏第三方的独立评测数据。低秩残差适配在多行为混合时的性能损失、软路由在复杂任务边界上的稳定性、以及相比 LoRA 的实际收益幅度,都还需要更多实验来支撑。
对于关注参数高效微调和模块化 LLM 部署的开发者而言,LARA 提供了一个有意思的思路和一份可直接上手的代码库。它是否能在更大规模、更严苛的基准上站稳脚跟,值得持续观察。项目地址已在 GitHub 公开,感兴趣的读者可以自行复现验证。
相关推荐
AI Agent审批工作流:如何处理编辑与重试
详解AI Agent人工审批工作流的设计要点:如何审阅精确请求、恢复执行,以及处理编辑与重试。以Airlock为例,探讨Agent走向生产环境所需的安全与可控机制。
MCP授权治理:为什么工具调用需要超越OAuth的安全防线
MCP工具调用为何需要超越OAuth的授权治理?本文解析工具权限的执行位置、请求内容检查与数据泄露测试,并介绍Airlock如何为AI代理的工具调用建立分层安全防线。
如何区分AI Agent流量与真实用户流量
AI Agent流量正被访问日志误记为真实用户行为。本文解读如何通过身份声明机制区分Agent流量与用户流量,帮助开发者与平台还原真实数据、优化风控策略。