Laya AI模型本地部署实测:35毫秒决策的智能体利器
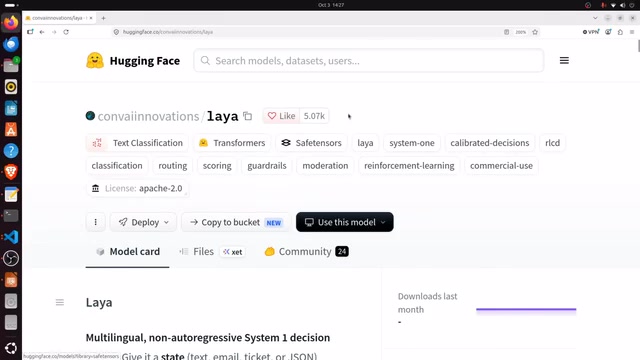
Laya AI以850MB体量和35毫秒推理,用非自回归架构实现低延迟决策
文章介绍了一款名为Laya AI的非自回归决策模型,它基于BERT/M-BERT骨干,不逐词生成文本,而是对候选答案直接打分,单次前向传播约35毫秒即可输出带校准概率的答案。模型仅850MB,CPU和GPU均可运行,实测20核CPU上占用约30%。文章基于B站教程拆解了部署流程:创建Python虚拟环境、pip安装(自动拉取CUDA、transformers等依赖)、首次运行自动下载模型,并用客服工单路由示例演示了“状态+问题+候选选项”的调用方式。作者指出Laya擅长封闭式选择题而非开放式生成,可与传统LLM互补,并支持在自定义领域数据上微调,适合机器人实时决策与智能体语义护栏。
在AI智能体(Agent)和机器人领域,决策延迟往往决定成败。传统大语言模型动辄数百毫秒甚至数秒的推理时间,让实时性要求高的场景捉襟见肘。最近,一款名为Laya AI(视频中称为LIA)的非自回归决策模型进入了开发者视野——它能在单次前向传播中输出带校准概率的精确答案,耗时仅约35毫秒,且CPU和GPU都能运行。B站UP主通过一期视频完整演示了从安装到测试的全过程,本文基于该教程,结合模型特性,为你拆解Laya的部署要点与适用场景。
Laya AI是什么:非自回归的决策专用模型
据视频介绍,Laya AI与传统生成式模型有着本质区别。它不逐词生成文本,而是将输入状态和结构化问题送入BERT/M-BERT骨干网络,直接对候选答案进行打分。这种非自回归架构省去了重型Transformer的逐token解码开销,因此速度极快——官方示例中,单次推理只需约35毫秒。
模型文件(saved tensors)仅约850MB,体积小巧,意味着它可以在普通CPU上高效运行,无需高端GPU。UP主在视频中特别纠正了自己的口误:“这个模型不是超级慢,实际上它非常快。”对于机器人平台,Laya可充当语义护栏,实时评分安全标准并选择行为原语;对于AI智能体,它能把结构化遥测数据转化为即时概率决策,而无需调用庞大的生成式模型。
非自回归(Non-Autoregressive) 是相对于GPT类模型逐token自回归生成而言的架构范式。自回归模型必须串行地一次预测一个词,每一步都依赖前一步输出,因此延迟随输出长度线性增长;非自回归模型则假设各输出位置条件独立,可一次性并行预测全部候选的分数。Laya采用BERT/M-BERT骨干,本质上是把决策建模为对候选答案的判别式打分而非生成式解码,因此单次前向传播即可完成,延迟与答案长度无关。代价是丧失了开放式文本生成能力,换取确定性和低延迟。
M-BERT(Multilingual BERT) 是BERT的多语言预训练版本,在104种语言的维基百科语料上联合训练,共享词表和参数。这解释了示例中模型能直接识别客户投诉文本的语言(输出“语言为英语”)——多语言骨干让Laya无需额外的语言检测模块即可处理跨语言输入,对国际化客服场景尤为实用。
安装步骤:虚拟环境隔离是关键
UP主强调,Laya的安装“超级简单”,但建议始终在Python虚拟环境中进行测试,以隔离依赖。教程在Linux终端中操作:先更新系统包(sudo apt update && sudo apt upgrade),然后回到主目录创建workspace文件夹,进入后执行python3 -m venv venv创建虚拟环境,再用source venv/bin/activate激活。
接下来安装Laya库。看似一条简单的pip命令,实际会拉取大量依赖,包括NVIDIA CUDA相关库、transformers、tokenizers、huggingface-hub等。UP主提醒,首次运行程序时模型会自动下载,因此需保持网络畅通。
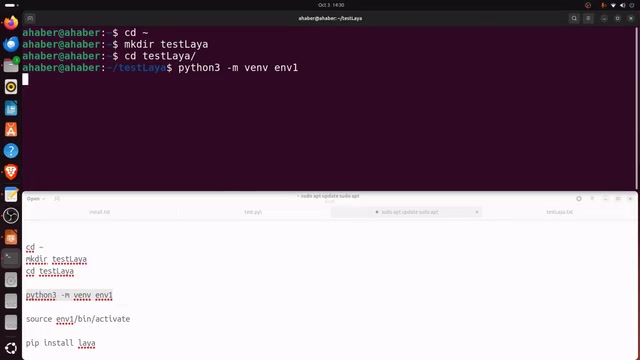
代码实战:一个客服工单路由示例
安装完成后,UP主使用VS Code创建test.py,并从Hugging Face仓库复制示例代码。代码逻辑清晰:导入router并初始化,定义“状态”(state)——例如一段客户投诉文本:“Hi, we were billed twice for March. Please refund the duplicate today or we will cancel our plan.”(3月被重复收费,请今天退款否则取消套餐)。
然后定义问题:部门(department)、紧急程度(urgency)、流失风险(churn risk)。类型为choice,指令是“哪个部门应处理此事”,候选答案为billing(账单)、invoices(发票)、payments(支付)、refunds(退款)、technical bugs(技术故障)、outage(宕机)等。运行代码后,模型输出:应路由至billing部门,并给出“是”的概率,语言为英语。整个过程无需生成冗长文本,直接给出决策与置信度。
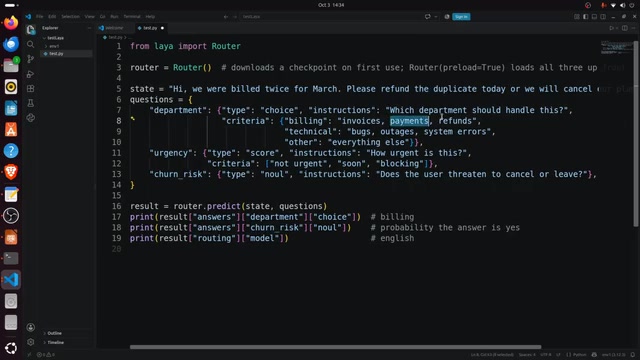
示例中的**“类型为choice”指Laya支持的离散选择题任务形式:调用方提供一组候选标签(如billing、refunds、technical bugs),模型对每个候选独立打分并归一化为概率分布。这与分类模型的softmax不同——候选集在运行时动态指定,无需固定输出维度,因此同一份权重可服务任意数量的选项。输出中的“是”的概率则是二值判断题(如“是否属于流失风险”)的置信度。这种结构化问答(state + question + choices)** 接口让决策结果天然可解释:概率直接反映模型对每个选项的相对倾向,便于设置阈值触发人工兜底或升级流程。
性能实测:CPU占用仅30%
为了验证资源消耗,UP主打开两个终端:一个运行nvtop监控GPU,另一个运行htop监控CPU。在20核CPU的系统上重新运行模型,观察到进程仅占用约30%的CPU。这印证了Laya的轻量特性——它不需要占满算力,适合与其它任务共存。
UP主在视频中打开VS Code并信任工作区文件夹,随后完成代码编写与运行。整个流程没有出现复杂配置,对新手友好。
适用场景与定制化潜力
Laya的定位非常明确:即时决策与智能体。在机器人场景中,它可实时评估传感器数据与环境状态,快速选择行为;在客服自动化中,它能将工单精准路由到对应部门,并给出可解释的概率。视频提到,基础检查点(base checkpoints)可在自定义领域数据上微调,以提升特定任务的精度。这意味着企业可以用自己的业务数据训练Laya,让它成为专属的决策引擎。
不过,Laya并非通用聊天模型。它擅长的是封闭式问题——给定状态和选项,快速打分。如果你的场景需要开放式生成、多轮对话或复杂推理,传统LLM仍是更好的选择。两者可以互补:LLM负责理解与生成,Laya负责低延迟的确定性决策。
基础检查点(base checkpoints)微调指在官方预训练权重之上,用领域标注数据继续训练。由于Laya是判别式打分架构,微调数据只需“状态—问题—正确选项”的三元组,无需构造生成式目标文本,标注成本显著低于训练对话模型。典型做法是冻结BERT骨干、仅训练顶部分类头(参数高效),或在数据量充足时全量微调。企业可将历史工单的处理部门作为标签,让模型学习自身业务的路由规则;机器人场景则可用行为原语的选择日志作为监督信号。
总结:小而快的决策专用模型
Laya AI以850MB的体量、35毫秒的推理速度和CPU友好的特性,为实时智能体提供了一个务实的选择。B站教程展示了极简的安装流程和直观的客服路由案例,验证了其易用性。对于需要快速决策、资源受限的边缘设备或机器人平台,Laya值得一试。但需注意,它解决的是“选择题”而非“问答题”,理解其边界才能发挥最大价值。
相关推荐
AI大模型测试三阶段:从断言到评估的测试变革
AI大模型测试正从断言走向评估。本文梳理用AI测试、和AI测试、对AI测试三阶段演进,解析概率性输出为何让传统断言失效,并介绍版本固定、三层评估对象及Promptfoo工具选型思路。
DeepSeek Harness:让AI测试从单机工具走向团队平台
DeepSeek Harness以服务端运行和插件机制改变AI测试协作方式,本文解析其与Codex等单机工具的核心差异,探讨测试开发如何借平台化思维构建团队级AI测试能力。
两球相交体积期望值:一道几何概率谜题
一道几何概率谜题:两个半径1的球体随机相交,求相交部分期望体积。本文解析问题设定、概率建模思路与积分求解框架,适合数学爱好者挑战。