Laya开源决策模型:421M参数用RLCD超越Jev基准
421M参数的开源非自回归决策模型Laya,以低延迟和校准概率输出为核心优势
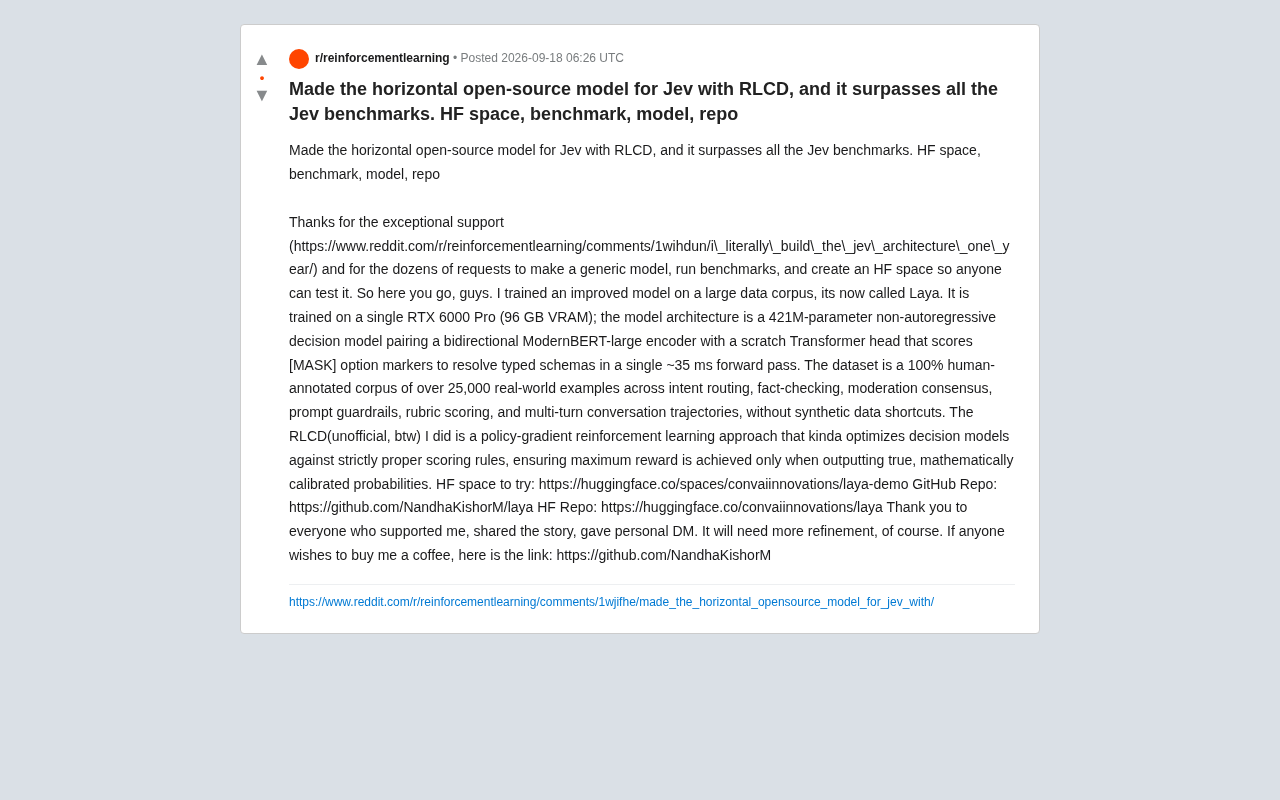
Laya是开发者NandhaKishorM推出的421M参数开源决策模型,基于ModernBERT-large双向编码器配合从零训练的Transformer头,采用非自回归架构实现约35ms的单次前向传播决策。区别于主流自回归大模型,Laya专注于意图路由、内容审核、事实核查等"做决定"类任务,训练数据为25000+个100%人工标注的真实样本,并通过自创的RLCD策略梯度强化学习方法优化概率校准性。整个模型在单张RTX 6000 Pro(96GB)上完成训练,模型权重、代码、基准测试与在线演示均已完全开源。作者坦承模型仍需打磨,但其"小而专"的技术路线为资源受限场景下的生产级决策系统提供了值得关注的参考方向。
一个开源决策模型的诞生
在强化学习社区的持续关注下,开发者NandhaKishorM推出了名为Laya的开源决策模型。这是基于此前Jev架构的进化版本——据其在Reddit上的介绍,社区此前给予了大量支持,并有数十位用户请求他打造一个通用模型、跑出完整基准并搭建可供公开测试的Hugging Face Space。这些呼声最终促成了Laya的问世。
与当下动辄数十亿甚至上千亿参数的大语言模型不同,Laya走的是一条截然不同的技术路线。它只有4.21亿参数,却声称在所有Jev基准测试中超越了原始架构。这种"小而专"的思路,在决策类任务日益受重视的当下颇具讨论价值。
非自回归架构:为决策任务而生
Laya最核心的技术特征在于它是一个非自回归(non-autoregressive)决策模型,这与主流的自回归生成式模型有本质区别。
具体来说,它将一个双向的ModernBERT-large编码器与一个从零训练的Transformer头部配对。这个头部专门负责对[MASK]选项标记进行打分,从而在单次约35毫秒的前向传播中解析出带类型的schema(typed schemas)。
这种设计的意义在于:对于意图路由、内容审核、事实核查这类需要"做决定"而非"写文章"的任务,逐token生成的自回归方式往往是过度设计。Laya用一次前向传播直接输出决策结果,35毫秒的延迟对于生产环境的实时路由和审核场景相当友好。选择ModernBERT-large作为编码器基座,也反映出作者对双向上下文理解能力的重视——决策任务通常需要同时考虑前后文才能做出准确判断。
自回归模型(如GPT系列)在生成文本时逐个token串行输出,每一步都依赖前一步的结果,这种方式天然适合"写作"类任务,但对于只需输出一个分类标签或概率分布的决策任务而言,产生了不必要的计算开销和延迟。非自回归模型则打破了这一顺序依赖,可以在单次前向传播中并行计算所有输出位置,从而大幅降低推理延迟。BERT系列模型是典型的非自回归双向编码器,其[MASK]填充机制本质上也是非自回归的——Laya正是借鉴了这一范式,将[MASK]标记的打分机制直接用于选项选择,而非用于生成流式文本。ModernBERT是2024年底发布的BERT架构改进版,在保留双向注意力优势的同时,引入了旋转位置编码(RoPE)、交替局部/全局注意力等现代化设计,相比原始BERT在长文本理解和推理效率上均有显著提升,是当前轻量级编码器任务的主流基座之一。
25000+人工标注数据:拒绝合成数据捷径
在数据层面,作者强调了一个在当下AI训练中相对稀缺的做法:100%人工标注。
Laya的训练语料包含超过25,000个真实世界样本,覆盖了多个决策场景:
- 意图路由(intent routing)
- 事实核查(fact-checking)
- 审核共识(moderation consensus)
- 提示词护栏(prompt guardrails)
- 评分标准打分(rubric scoring)
- 多轮对话轨迹(multi-turn conversation trajectories)
作者明确指出"没有走合成数据的捷径"。在合成数据大行其道的今天,坚持全人工标注是一把双刃剑:一方面保证了数据质量和真实性,避免了合成数据可能带来的分布偏移;另一方面,2.5万样本的规模在数据量上相对有限,这也是作者自己承认"仍需更多打磨"的原因之一。
RLCD:用强化学习追求校准的概率
Laya另一个技术亮点是作者自称的RLCD方法(他特别注明这是"非官方"命名)。
这是一种基于策略梯度(policy-gradient)的强化学习方法,用于针对严格正确评分规则(strictly proper scoring rules)来优化决策模型。其核心思想是:只有当模型输出真实且数学上校准(mathematically calibrated)的概率时,才能获得最大奖励。
这一点在实践中价值不小。许多分类和决策模型虽然准确率不错,但输出的置信度概率往往是"过度自信"或"校准失准"的。而在审核、护栏这类高风险场景中,一个能给出可信概率的模型远比一个只给出硬标签的模型有用——你可以据此设定阈值、决定是否需要人工复核。通过强化学习直接优化校准性,Laya试图从训练目标层面解决这个长期痛点。
严格正确评分规则(strictly proper scoring rules)是概率预测领域的一个数学概念,其核心性质是:当且仅当预测者报告自己真实相信的概率时,期望得分最大。常见的例子包括对数似然损失(log loss)和Brier分数。"严格正确"意味着任何试图通过扭曲概率来"套利"的行为都会导致期望得分下降,这在理论上强制模型输出诚实且校准的概率。策略梯度(policy-gradient)是强化学习中的一类方法,通过对奖励信号的梯度估计直接更新策略参数,无需像Q-learning那样建立值函数,适合处理离散决策空间和非可微奖励。RLCD将这一机制与严格正确评分规则结合,意味着模型的奖励信号本身就是一个惩罚概率失准的数学函数,从而将校准性从后处理问题转化为训练目标,这是其区别于传统交叉熵训练的核心创新点。
单卡训练的工程实践
值得关注的还有Laya的训练成本。整个模型是在**单张RTX 6000 Pro(96GB显存)**上完成训练的。
对于一个421M参数、追求专用决策能力的模型而言,这样的硬件门槛相对亲民,也印证了"小模型+高质量数据+针对性训练目标"这条路线在资源受限条件下的可行性。相比之下,通用大模型的训练动辄需要成百上千张GPU集群,两者的定位和适用场景完全不同。
可以直接上手体验
作者已将Laya完整开源,提供了多个入口供社区验证和使用:
- Hugging Face Space在线演示:可直接在浏览器测试模型效果
- GitHub仓库:包含完整代码
- Hugging Face模型仓库:可下载模型权重
这种"模型、代码、基准、演示"一次性全部开放的做法,体现了作者对社区反馈的重视,也让感兴趣的开发者能够快速验证其"超越Jev基准"的说法。
小结
Laya代表了一种与主流大模型不同的思路:不追求通用的生成能力,而是聚焦于决策任务本身,用非自回归架构换取低延迟,用人工标注数据保证质量,用强化学习优化概率校准。对于需要在生产环境部署意图路由、内容审核、护栏系统的团队来说,这类"小而专"的开源决策模型值得纳入技术选型的考量。
当然,作者本人也坦承模型"仍需更多打磨",2.5万样本的数据规模和非官方的RLCD方法都还有验证与迭代的空间。但作为一个由个人开发者在单卡上完成、完全开源的项目,Laya的技术选择本身就足够引人思考。
相关推荐
厦门大学AI编程课落地实践:从教材到教学的全解析
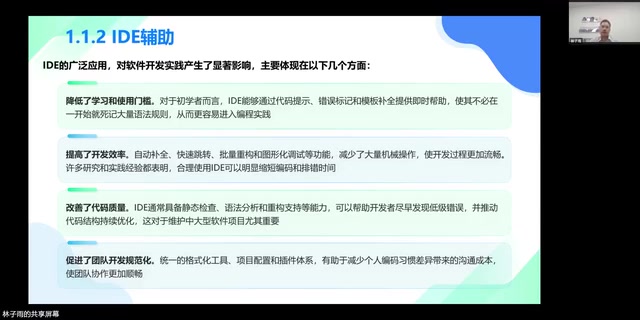
厦门大学林子雨副教授分享《AI编程与智能体开发》课程建设实践,涵盖AI编程三段演进、Claude Code生产级拐点、三种编程方法论及教材设计,详解免费可复现的高校教学落地方案。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
n8n 自动化实战:AI 工作流如何为中小企业降本增效
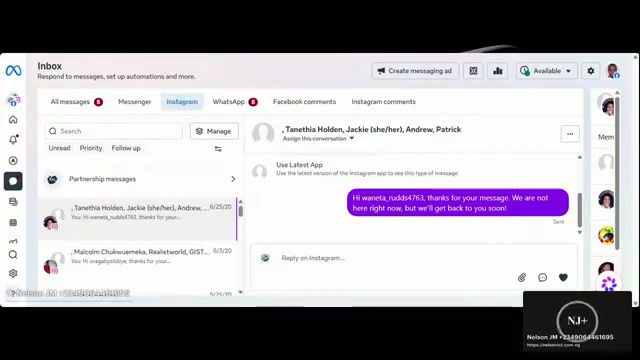
本文基于一线从业者的实战分享,讲解如何用 n8n 与 AI 工具构建工作流自动化,涵盖多平台消息聚合、AI 自动回复、批量数据录入与智能校验,帮助中小企业降本增效。