Layla真是开源版Jev吗?深度扒开开源决策模型的真相

开源决策模型Layla用双向编码器替代生成式架构,速度与成本有优势,但零样本泛化差、工程硬伤多,适合合规敏感场景下的定制部署。
Layla是在闭源决策模型Jev发布三天后开源的替代方案,采用双向编码器加决策头架构,彻底放弃文本生成能力,一次前向计算直接输出结构化决策(选择、打分、是非),从而规避了幻觉和格式错误。网络热炒的"快7.8倍至50倍"存在严重水分——对比基准是本地单卡推理对阵跨国云端API,省掉的是光缆延迟而非模型算力;换成普通i5 CPU后速度反而更慢。准确率方面,基础模型零样本成绩仅0.35,低于随机基线,必须用业务数据微调;多语言版存在概率坍缩和静默截断等工程硬伤。尽管缺陷明显,Layla凭借开源权重可100%自托管、数据不出境的合规优势,在国内开发者群体中迅速走红,并催生出MLX、ONNX、NPU等多平台部署生态,验证了本地极速决策模型这条技术路径的可行性。
一个三天诞生的"平替":Layla凭什么火
在闭源决策模型Jev(TypeSafe AI推出)发布仅三天后,一个名为Layla的开源模型家族横空出世。它采用Apache 2.0许可直接开源权重,姿态上正好打在Jev"闭源收费API"的反面。网络上随之炒出"比Jev快7.8倍"甚至"快50倍"的夸张口号,让不少开发者涌入它的视野。
据B站UP主碳龟同传翻阅Layla官方长文、作者早年两篇论文以及国内外同行实测后的分析,Layla并非单一模型,而是一个包含英文、多语言和类型化决策三个检查点的家族,让开发者能按需挑选底座。它和上一代的System 1类模型思路一致,在物理层面上切断了生成文本的能力——一次前向计算只输出结构化决策,要么是挑选项,要么是打分数,要么是判断是非。
正因为它压根不"吐字",只输出概率和数字,传统生成式大模型的幻觉、JSON格式报错问题在它身上根本不存在。作者的核心观点是:用几百亿参数的大模型去做工单分类纯属大材小用,业务线上真正需要的是30毫秒内出结果的"直觉",低延迟和低成本才是落地的硬指标。
架构内核:双向编码器加决策头
拨开外壳看内核,Layla的架构和生成式模型完全不同。它用的是双向编码器,然后把传统的语言头直接砍掉,换成了一个由两层Transformer组成的决策头,每个选项都有专属的编码标记。
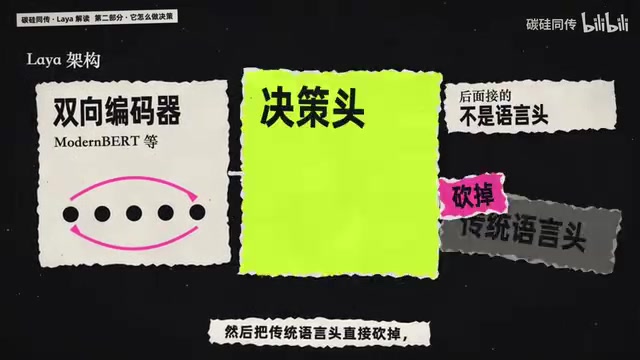
在这个机制下,一次前向计算就能给所有选项打分,再用Softmax转成概率,没有自回归循环,没有解码开销——这是它速度极快的核心秘密。它的输出原语分三种:Choice负责单选并输出选中项与分布概率,Score负责打分题给出期望等级,Bool处理是非题只返回一个概率值。
部署层面它切分了三个检查点:英文版4.2亿参数,多语言版3.2亿参数覆盖上百种语言,还有一个专门针对工作流微调的版本。它们都在同一个仓库下,开发者按需拉取子文件夹即可,省去了下载全量权重的麻烦。
不过这里存在一个关键技术争议。官方宣称"一次调用里的多个问题是在同一次前向计算中完成的",但同行做移植和评测时发现并非如此。据Anthros团队实测,每多一道题实际上就多跑一次前向计算;AXERA NPU的部署包里也写明,包含四个问题的请求实打实跑了四次计算。
双向编码器与生成式模型的根本区别在于信息流动方向。GPT系列等自回归模型使用单向(因果)注意力机制,每个token只能看到它之前的内容,因此必须一个字一个字地顺序生成输出。BERT等双向编码器则让每个token同时关注序列的左右两侧,一次性对整段输入形成完整的上下文表征。这种"全局感知"非常适合分类和打分任务,却无法用于文本生成——因为生成时尚不存在"右侧"内容可供参考。Layla正是利用了这一天然限制:选择双向编码器意味着从架构层面锁死了生成能力,同时获得了对输入的深度理解和极低的推理延迟。Softmax层将所有选项的原始得分归一化为概率分布,使得各选项概率之和恒为1,便于比较和阈值判断。
速度神话的水分:在和什么比?
网上炒翻天的"7.8倍""50倍"究竟是怎么比出来的?这是理解Layla最关键的一环。
官方给出的绝对值是:在单张T4显卡上,多语言版单题耗时约32.8毫秒,凑成10道题并发平均每题只要7.2毫秒。这个本地速度确实拔尖,但问题出在对比方式上。
Layla作者根本没拿到Jev的API权限,从未亲自测过。表中Jev那200多毫秒的数据是别人从法国调用云端API测出来的。换句话说,作者是拿自己本地单卡的极限,去对比别人的跨国公网延迟——这两者显然不在一个水平线上。所谓"省下的几百毫秒",省掉的其实是光缆的物理传输延迟,而不是模型处理变快了。
一旦把高级GPU拔掉,局面立刻逆转。在普通的i5处理器上跑Layla,单题就飙到416毫秒;50道题并发直接卡死14.5秒,比调云端还慢。所以Layla的速度强依赖本地算力,脱离了好显卡,神话不攻自破。

网络往返延迟(Round-Trip Latency)在评估云端API性能时是一个经常被忽视却至关重要的变量。从法国发起API调用到美国或其他地区的云服务器,仅光缆物理传输就需要约80-150毫秒,再加上TLS握手、负载均衡、排队等候等网络栈开销,总延迟轻松超过200毫秒——这与模型本身的推理速度完全无关。T4 GPU是NVIDIA面向推理场景的数据中心显卡,具备16GB显存和约65 TFLOPS的INT8算力,是云端部署中低成本推理的常见选择。将本地T4上的裸推理时间与包含完整网络往返的云端API响应时间相比,本质上是在比较两个不同系统的不同指标,对实际落地决策几乎没有参考价值。
准确率里的坑:微调前后判若两人
快是一回事,准才是及格线。官方拿出Typed Decisions数据集0.766的高分,确实比Jev高,但这是在自家训练集上专门微调出来的成绩。
如果用没微调过的基础模型去跑,成绩只有0.35左右——而闭眼全猜多数选项的基线都有0.461。这意味着Layla根本做不到Jev那样的开箱即用零样本泛化。官方也坦承:它只是一个带专门化的快速底座,不是宣称拥有前沿智能的"零样本神器",想上生产环境必须用自己的业务数据做微调。
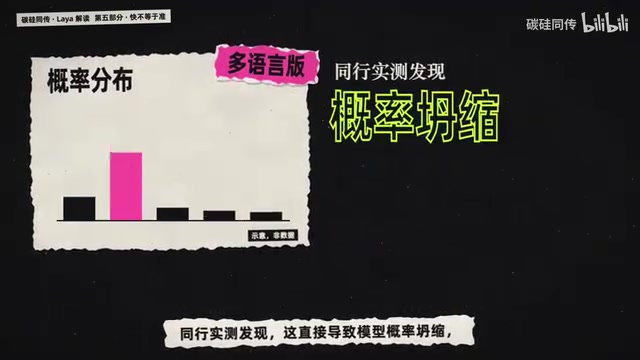
校准误差同样有水分。官方宣称0.081的校准误差比Jev漂亮,但这是重新拟合温度后的结果,原生态的校准误差其实比Jev还差。更离谱的是多语言版出厂温度表居然是空的,同行实测发现这直接导致"概率坍缩"——模型经常抛出1.0满分的错误答案,错得理直气壮。
长文里那些"过滤垃圾邮件、抓钓鱼99%"的神级数据,原因很简单:这些数据本就在训练集里。一旦遇到没见过的流出集,比如内容审核任务,准确率立马掉到53%,基本就是抛硬币。此外,Layla对选项基数和位置极度敏感——77类分类题上它跌到0.425,打乱选项顺序能让20%的答案发生翻转。
零样本泛化(Zero-shot Generalization)指模型在从未见过的任务或数据分布上直接推理的能力,是衡量大型语言模型通用性的核心指标之一。GPT-4、Claude等生成式大模型之所以被称为"开箱即用",正是因为它们在海量文本预训练中积累了广泛的世界知识,面对陌生任务时能靠语言理解和推理能力迁移。Layla的双向编码器架构在设计上就放弃了这条路:它的参数规模(3-4亿)远小于主流大模型,预训练目标也聚焦于分类表征而非广泛知识积累,因此必须依赖特定领域的监督微调数据才能达到可用水准。校准误差(Calibration Error)则衡量模型输出概率与实际准确率的吻合程度——校准好的模型说"80%把握"时,其实际答对率应接近80%;校准差的模型则可能在答错时仍给出接近满分的置信度,这正是多语言版"概率坍缩"问题的根源。
多语言与本地部署的真实挑战
在多语言测试中有一个极端翻车点:作者扫了51种语言,发现英文模型碰到高棉语这类完全不认识的字符时,准确率直接是0,但给出的平均置信度居然高达95%以上——在"理直气壮地胡说八道"。
这证明了一旦文字跨区,模型内部置信度就彻底失灵。所以做工程架构时,绝不能指望"跑完看置信度低再换路"的兜底方案,判别语言必须在前向计算之前完成。Layla自带了一个纯Python路由模块,开销不到0.1毫秒,但如果放任流量乱打导致CPU不断重建检查点,线上延迟会直接崩盘。
上下文长度也是短板。英文版只有512,多语言版只有1024,远不如Jev动辄几万的上下文。更要命的是,面对超长输入,Layla会直接静默截断——不报错、不提示,拿残缺的一半文本硬算,这在线上是个定时炸弹。
尽管坑多,开源的魅力让开发者各显神通:苹果全家桶有MLX和CoreML版,普通CPU有100%离线的ONNX版,芯片厂AXERA也光速发了NPU部署包。
ONNX(Open Neural Network Exchange)是一种开放的神经网络中间表示格式,由微软和Facebook联合推出,旨在让模型能够跨框架、跨硬件部署。将模型导出为ONNX格式后,可以使用ONNX Runtime在CPU上高效推理,无需依赖PyTorch或CUDA环境,这正是实现"100%离线、断网推理"的关键技术路径。MLX是苹果针对Apple Silicon(M系列芯片)推出的机器学习框架,充分利用了M芯片统一内存架构(CPU与GPU共享内存池)的优势,避免了传统GPU推理中的数据拷贝开销。NPU(Neural Processing Unit)是专为神经网络矩阵运算设计的专用芯片,功耗远低于GPU,适合边缘设备上的持续推理场景。这些生态工具的快速跟进,使Layla得以在多种算力基础设施上落地,极大降低了本地部署门槛。
说不清的渊源:谁借鉴了谁
既然缺陷明显,为什么还能掀起这么大风浪?这就要提Layla和Jev之间那段纠葛。
据碳龟同传复盘:9月15日TypeSafe AI率先发布Jev,高调定义了"System 1 Models",用放弃生成文本换取极速结构化决策,走的是闭源API按Token计费的商业路线,产品极度成功。眼看Jev大火,Layla作者贴出自己的两篇旧论文,表态自己一年多前就做过这件事,对TypeSafe拿这个概念做闭源收费和"新突破"营销表示不满。
但较真来看,那两篇旧论文的底层技术和今天Layla用的双向编码器加选项打分根本不是一回事。第三方分析指出,旧论文更像是基于嵌入向量做系统编排,作者延续的是"非自回归、快速决策"的思路,而非直接发明了这套架构。至于Jev这边,创始人在播客里被问到"有人一年前做过"时,仅敷衍了一句"耶"——人家只在乎能否继续领先。

为什么国内开发者还是买账
抛开技术八卦,Layla在国内的火爆速度是实打实的。9月18日上线后紧接着登陆Hacker News和各大技术论坛,几天内GitHub星数破万。
但真正打动国内开发者的,其实不完全是那几十毫秒的速度,而是数据合规和隐私保护。Layla的杀手锏是开源权重可以100%自托管,几百兆的模型一点内存就能跑,彻底阻断数据出境风险,后续也没有API费用,只有电费。
国内同行的行动力也令人佩服:Hugging Face连不上马上有ModelScope镜像,苹果生态做出MLX Edge版,有团队实现纯CPU断网推理,爱芯元智做出NPU部署包。更有意思的是,像Appos这样没拿到Jev架构的团队,干脆用通义千问广告从头复现了这套快速决策流,补齐了整条本土基建链路。
当然,狂热也伴随大量水分。很多测评根本不提对比前提,硬拿本地推理耗时去踩跨洋网络往返,导致不少国内开发者一测就翻车——有40条中文工单的测试里,Jev API拿到78%,Layla本地跑只有57%,复杂对抗下甚至掉到40.3%。
结语:验证了一条可行路径
综合两期分析,无论是闭源标杆Jev还是开源"平替"Layla,都不该只盯着33毫秒的极限速度看。从跑通一个本地分支到投入生产,还要越过静默截断、概率坍缩等诸多关卡。
Layla绝不是万能神器,它的零样本泛化、长文本处理、多语言稳定性都存在明显短板。但它确实验证了一条"本地极速决策模型"的可行路径,并把数据主权交还到了开发者手中。开源与闭源的这场较量,还要靠时间来给出答案。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。