LeadRadar:用AI代理替代一下午的Google Maps找客户

开源AI代理LeadRadar把Google Maps找客户流程自动化,输出打分线索与邮件草稿。
LeadRadar 是开发者 mudit-palvadi 在 Hacktoberfest 开源 AI 挑战赛中提交的项目,用 AI 代理替自由职业者完成「翻 Google Maps 找客户」的漫长流程。输入职业与城市,系统通过 SerpApi 执行 Maps 查询,再对每家商家打出 0-100 分,并为排名第一的线索草拟个性化外联邮件。其核心设计是把事实提取交给搜索记录、把观点判断交给模型,打分采用 75/25 加权;提示词与代码层面都做了约束以弥补 7B 模型的不足。两位真实用户测试暴露了职业适配缺陷,也验证了速度这一核心优势。项目已开源,采用 MIT 许可。
自由职业者找客户的过程,往往是从打开Google Maps开始的一场漫长滑屏。挨个翻看商家有没有官网、评价有没有人回复,复制粘贴到表格,最后写出一封「我偶然发现了您的生意」的邮件——而真相是,你可能已经滑过了四百家店铺。开发者mudit-palvadi在Hacktoberfest开源AI挑战赛第二周提交的LeadRadar,正是冲着这个痛点来的:一个自动读取Google Maps、给本地商家打分、并草拟外联邮件的AI代理。
LeadRadar是什么
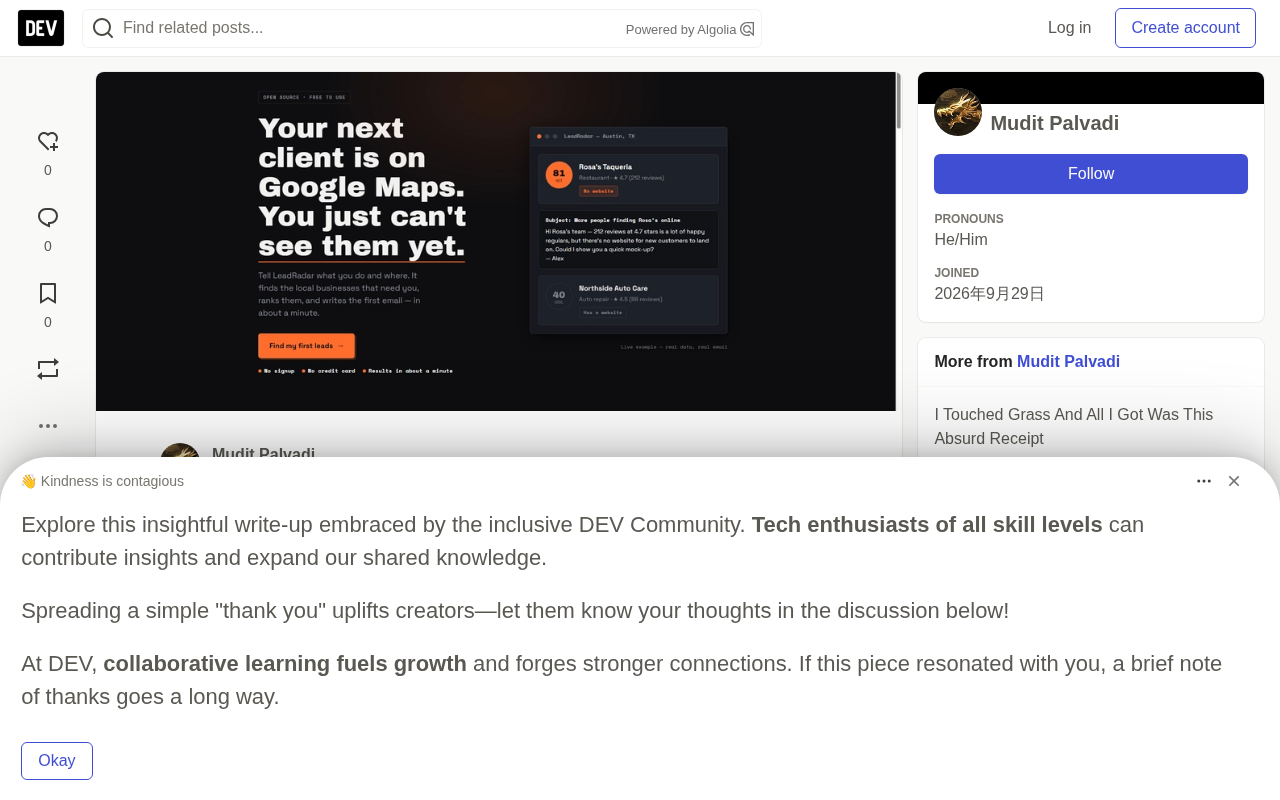
LeadRadar的输入极其简单:你从事什么职业、在哪个城市、你的名字、想要多少条线索。例如输入「graphic designer in Austin, TX」,代理会自行搜索、给每条结果打分,返回一份带排序的线索列表,并为排名第一的线索准备好一封邮件。把职业换成「content writer」或「web developer」,流程完全一致——职业只改变代理「找什么」,不改变它「怎么想」。
系统由四个模块组成:
- 搜索层:把你的职业与城市拼成一条Google Maps查询,通过SerpApi执行。
- 打分层:为每家商家打出0-100分。大部分分数来自搜索结果中可直接验证的事实,比如有没有官网、评分是否正在悄悄拖累它。
- 邮件层:为排名靠前的线索草拟一封简短的个性化邮件,并署上你的名字。
- Temporal工作流:把搜索、打分、写信拆成独立步骤并带重试,一次限流不会让整次扫描报废。
技术栈刻意选了保守组合:Express做API,MongoDB Atlas做存储,Groq免费额度的allam-2-7b模型(本地回退用Ollama),搜索用SerpApi。整套部署在单个Render服务上,MIT许可,附带68个测试。
SerpApi 是一个第三方搜索数据 API 服务,它把 Google、Google Maps、Bing 等搜索引擎的结果抓取并结构化成 JSON 返回,开发者无需自己维护爬虫和代理池。对 LeadRadar 这类项目而言,它解决的是「如何以编程方式稳定获取 Google Maps 商家信息(名称、地址、电话、官网、评分、评论数、品类)」的问题。免费额度有限,通常用于原型与低频调用,生产环境需付费扩容。
Temporal 是一个开源的工作流编排引擎,核心价值在于把一段多步骤业务逻辑拆成可持久化、可重试、可观测的独立 activity。它记录每一步的执行状态,某个步骤因限流或网络失败时只重跑该步骤,而不是让整条流程从头再来。LeadRadar 用它包裹「搜索—打分—写信」三段流程,正是为了避免一次 SerpApi 限流导致整次扫描作废。
演示与使用体验
扫描表单只问四件事:你的职业、你的工作地点、你的名字、想要多少条线索。提交后,工作流每完成一步,界面上对应的步骤就会亮起。
结果返回时是一份排好序的列表,每条分数旁边都列出触发信号,让你看得见一家商家为什么排在那个位置。排名第一的线索已经附带一封写好的外联邮件,手机上也能正常使用——如果你是在通话间隙查看线索,这一点很重要。
服务运行在Render免费套餐上,冷启动后首次访问大约需要一分钟。整个项目开源在GitHub,采用MIT许可。
三个关键设计决策
查询由代理替你写,而不是你手输
你从不自己组织搜索词。输入「graphic designer」后,代理会先问模型:哪些本地商家会雇佣这样的人?再把答案拼成一条Maps查询,例如「coffee shop OR bakery OR restaurant OR bar OR food truck OR real estate agent OR gym OR salon ... in Austin, TX」。一次SerpApi的Google Maps调用后,你就拿到了名称、地址、电话、官网、评分、评论数和品类。
这里踩过两个坑。第一个坑是提示词只懂一种职业。作者的设计师朋友跑扫描时,代理推荐的是玩具店、宠物店、洗车行、书店(书店还出现了两次)——这些确实是商家,但没有一个在等一位设计师。原因是提示词里只放了一个网页设计的示例,模型完全没有泛化。作者跑了三遍诊断脚本,看到同一份错误列表,随后重写提示词,加入跨职业示例,并把问题问得更尖锐:哪些商家是老板会自掏腰包买单的?同时加入去重,并让职业过滤能识别「design studio」这类与「graphic designer」擦边的结果。修改后同一脚本返回的是咖啡店、面包店、餐车和一家画廊,一次真实的Austin扫描产出了15家作者真的愿意发邮件的商家。
第二个坑是SerpApi偶尔会返回一条根本不是商家的记录,最常见的是只返回城市名、没有真实标题。一条叫「Austin」的线索会诱导模型编造细节,所以isUsableResult()会在进入列表前把这类行丢掉。作者最近一次扫描的日志写着「dropped 1 unusable result」——正好少了一封尴尬的邮件。
事实来自搜索,观点才交给模型
初版打分器完全信任模型,结果它对每一条线索都回答70分,无论商家有没有官网。一个永远不变的分不是分,是装饰。
于是分工被严格切分:detectSignals()读取SerpApi原始记录,推导可验证的事实——没有官网对任何职业都是强烈的购买信号,低评分加大量评论是另一个。模型只返回一个数字和一句推理,最终分数是加权混合:
// src/workflow/activities.ts
let base = 30;
if (has('no_website')) base += 55;
if (has('bad_reviews_no_response')) base += 15;

const blended = base * 0.75 + clamp(modelScore, 0, 100) * 0.25;
75%的分数是任何人都能读懂的算术,模型只拿到四分之一投票权——足以打破平局,不足以假装它看到了没看到的东西。
信号(signal)与打分 是这里的关键抽象。detectSignals() 不做判断,只做提取:某条商家记录有没有官网链接、评分与评论数处于什么组合区间、是否呈现「高分但无人回复评论」等模式,输出一组布尔或离散标签。真正的评分逻辑是把这些标签映射为固定权重——例如「无官网」+55 分,因为对任何自由职业者来说,一个连官网都没有的商家更有可能是尚未被外联覆盖的潜在客户。这种把「事实提取」与「价值判断」分离的做法,让分数来源可追溯、可审计:每个数字都能对应回原始搜索记录中的某一项,而不是模型的黑箱直觉。
邮件要能在7B模型手里活下来
提示词要求模型署名,并要求它不要评论自己从未看过的东西,但模型依然会愉快地照做。所以检查放在代码里:ensureSignOff()检查草稿结尾,模型忘了署名(它经常忘)就补上你的名字;cleanEmailBody()删掉模型「坦白」自己没查过官网的句子,以及那句被明令禁止却仍然写出来的「I hope this email finds you well」;pitchGuidance()则防止一位平面设计师在邮件里提议帮客户建网站——这类内容会让外联邮件一眼看出是生成的。
作者总结出的规则是:能靠代码检查输出解决的事,就不要在提示词里跟模型较劲。
7B 模型 指参数量约 70 亿的小型语言模型,如文章提到的 allam-2-7b。相比 GPT-4 级别的模型,它在指令遵循、长上下文推理和「知道自己不知道什么」方面明显更弱,容易产生幻觉或无视负面约束(比如被明确要求不要写某句话却仍然写出来)。因此在工程实践中,可靠的策略不是反复雕琢提示词去「说服」模型,而是在输出后加一层确定性的代码校验:检查署名、过滤违禁措辞、纠正与职业不符的建议。这也是「能靠代码检查解决的事就不要在提示词里较劲」这条规则背后的现实依据。
为什么开源这件事重要
找客户的工具,通常反过来卖给最需要它的人。多年来,线索发现的选择要么是付不起的月度数据库,要么是被人包装成服务的爬虫。而作者真正用来构建的库,是免费且可读的。
Google Maps作为线索来源并非新思路,社区里已有多个类似开源项目。开源改变的是推理过程:任何人都能读出一家面包店为什么排在精品店前面,可以质疑权重,可以提pull request。「只能买的黑箱线索列表」和「可读的线索列表」不是同一种产品。
两位真实用户给出的反馈
发布前,作者把LeadRadar交给两位真正在做自由职业的朋友测试。
做网页开发的那位跑了一次扫描,最惊讶的是速度。他挑了一条线索,把代理草拟的邮件发了出去,回来说没有转化——一封邮件本来就很难转化。但他真正说的是他喜欢这个应用,肯定会再用,而且现在他有了一份以前没有的候选名单,大约一分钟就做出来了。
做平面设计的那位结果相反。应用找不到适合他职业的好线索,他直接说这个应用看起来更像是为其他技能优化的。他说得对,而且说得毫不客气——而这正是最有用的部分。就是这句抱怨,把作者推向了诊断脚本和提示词重写。修复后,他这类扫描返回的是咖啡店、面包店和活动场地,而不是玩具店。
两位都没有付费,作者也没有开口问。到目前为止唯一的「投票」是那位开发者承诺会回来继续用——这比作者自己录的任何演示都有说服力。
作者留下两条经验:速度比任何功能都更打动开发者,因为他比较的对象是自己滑一下午的Google Maps;而「适用于所有自由职业技能」这种说法,只有在真人测试过的每一种技能上都成立时才算诚实。目前测试了两种职业,这个说法仍然小于作者的野心——他宁愿把这话说出来,也不愿藏在脚注里。
目前还做不到的事
- 分数只在同一次扫描内部相互比较才有意义。Austin的81分不代表你所在的城市也会给81分。
- 邮件只是草稿。发之前请自己读一遍,署名的是你。
想在手机上试试的话,可以在浏览器里打开那个Render地址,冷启动大约一分钟。如果你的职业返回的线索和作者朋友遇到的一样离谱,去GitHub开一个issue告诉他——这正是它变好的方式。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。