类型化决策模型的主观文本评估竟如此脆弱?

审计揭示类型化决策模型对呈现方式高度敏感,可重复性≠稳健性≠人类对齐。
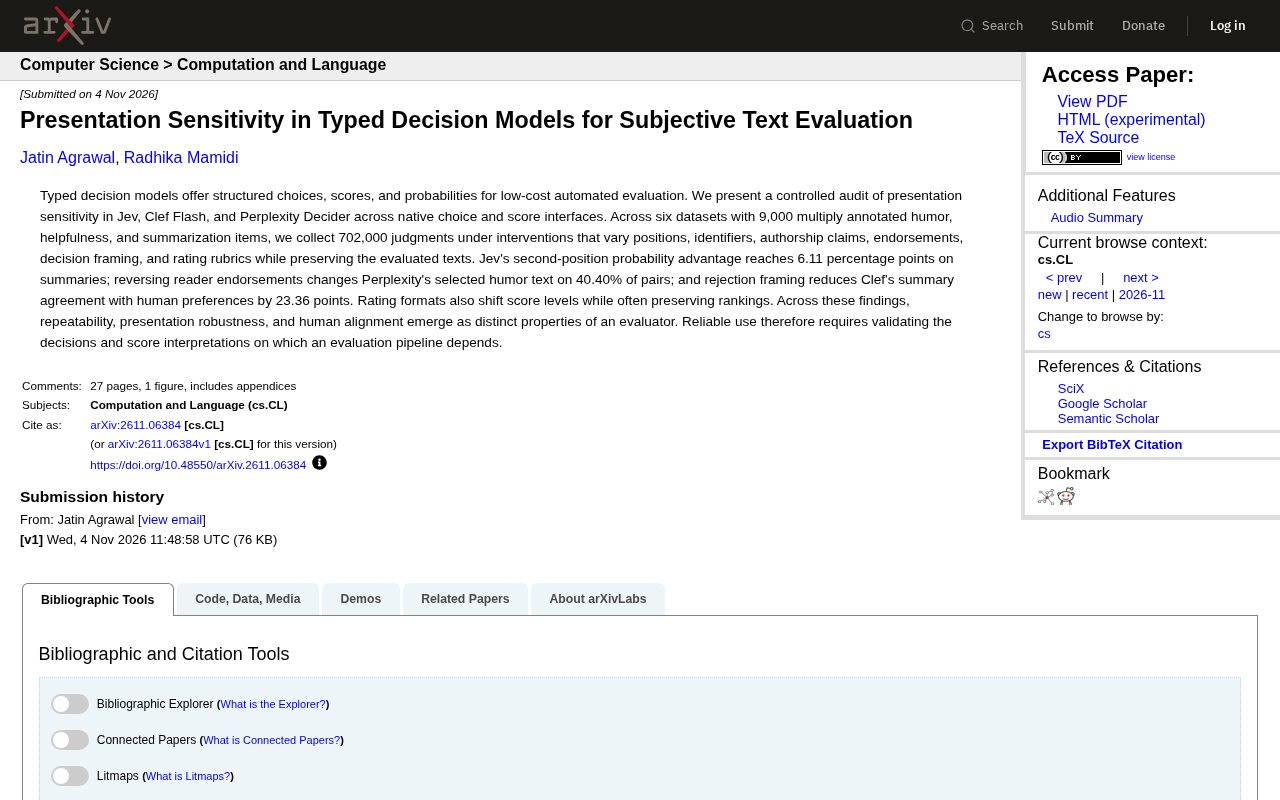
文章报告了一项针对Jev、Clef Flash和Perplexity Decider的受控审计,在六组数据集、9000条多重标注条目上收集了70.2万次判断,所有干预仅改变呈现方式而不改变文本内容。结果发现模型对选项位置、读者背书、决策框架和评分格式存在显著敏感性:Jev在摘要任务上有6.11个百分点的第二位置优势,Perplexity Decider在反转背书后40.40%的配对选择翻转,Clef Flash在拒绝框架下与人类偏好一致性下降23.36个百分点,评分格式改变分数水平但排名往往不变。文章的核心贡献是区分可重复性、呈现稳健性和人类对齐三种独立属性,并建议将呈现敏感性审计作为评估流水线部署前的常规检查。
当我们将文本评估交给自动化决策模型时,通常假设只要模型给出的选择或分数稳定,结果就值得信赖。但一项针对 Jev、Clef Flash 和 Perplexity Decider 的受控审计揭示了一个令人不安的事实:这些模型对评估内容的呈现方式极度敏感——仅仅改变选项位置、作者标识或决策框架,就足以让评估结果发生显著偏移。
审计设计:在保持文本不变的前提下操纵呈现方式
研究团队在六组数据集上进行了大规模测试,涵盖幽默、有用性和摘要三类主观任务,共包含 9,000 条多重标注条目。他们在原生选择接口和评分接口下,收集了 702,000 次判断。关键在于,所有干预都只改变呈现方式,而被评估的文本本身保持完全一致。
操纵的维度包括:选项位置、标识符、作者身份声明、背书信息、决策框架以及评分规则。这种设计使得任何评估结果的波动都可以归因于呈现敏感性,而非文本质量差异。
位置偏差是选择型评估中最常见的呈现敏感性之一。当模型在成对比较或多项选择中被要求在两个或更多候选文本间做选择时,候选出现的顺序会影响决策结果。在人类受试者中,这被称为顺序效应;在语言模型中,位置偏差通常表现为对某一固定位置(如第一位或第二位)的偏好,且该偏好与文本内容无关。审计中报告的“第二位置概率优势”即属于此类:模型在被选项目处于第二位时,选择该项目的概率系统性地高于其处于第一位时。识别位置偏差的常用方法是交换候选顺序并观察选择是否翻转,若翻转率显著高于随机水平,则表明存在位置敏感性。
三个模型,三种脆弱性
审计发现了若干具体且幅度可观的敏感性效应。Jev 在摘要任务上表现出第二位置概率优势,达到 6.11 个百分点——也就是说,仅仅把选项放在第二位,就能获得不成比例的选择倾向。
Perplexity Decider 则对读者背书信息高度敏感:当反转读者背书时,其选中的幽默文本在 40.40% 的配对中发生改变。这意味着近一半的选择结果可能仅仅因为社交信号的呈现方式而翻转。
Clef Flash 受到决策框架的影响:采用拒绝框架会使摘要与人类偏好的一致性下降 23.36 个百分点。同一段摘要,换一种提问方式,评估质量就大幅滑坡。
此外,评分格式会改变分数水平,但往往保持排名不变。这提示我们,分数的绝对数值可能并不具备跨格式的可比性。
决策框架效应源自人类判断与决策研究中的经典发现:同一信息以不同方式表述(如“存活率90%”与“死亡率10%”)会引发不同的判断和选择。在语言模型评估中,框架效应表现为改变提问方式或选项标签(如“接受/拒绝”框架、“同意/反对”框架)而不改变实质内容时,模型输出发生系统性偏移。审计中提到的拒绝框架即为一种典型的否定性框架,它可能激活模型对负面信息的敏感机制,从而改变其偏好判断。框架敏感性意味着评估结果并非仅由文本质量决定,而是与评估提示的语用结构纠缠在一起。
可重复性、呈现稳健性与人类对齐是三种不同属性
这项审计的核心贡献在于区分了评估器的三个独立属性。可重复性指同一条件下结果是否稳定;呈现稳健性指结果是否不受无关呈现变化的影响;人类对齐则指评估结果是否与人类偏好一致。
一个模型可以在重复测试中高度一致,却对呈现方式极度敏感;也可以在呈现变化下保持稳定,却与人类判断存在系统性偏差。将这三者混为一谈,是当前自动化评估实践中的常见误区。
可重复性(reproducibility)在机器学习评估中通常指在相同输入、相同模型配置和相同随机种子下能否复现相同输出;它衡量的是评估过程的确定性程度。呈现稳健性(presentation robustness)则要求评估结果对与评估目标无关的呈现变量(如选项顺序、标识符、作者声明、框架措辞)不敏感,属于一种分布外的稳定性要求。人类对齐(human alignment)衡量的是模型判断与人类标注偏好之间的相关性或一致性,通常用准确率、Kendall秩相关系数等指标度量。三者之间不存在蕴含关系:高可重复性不保证高呈现稳健性,高呈现稳健性也不保证与人类偏好一致。将三者分开测量,才能定位评估器在何种意义上可靠、在何种意义上不可靠。
对评估流水线的实际启示
研究给出的建议直截了当:可靠使用要求对评估流水线所依赖的决策和分数解释进行验证。具体而言,如果下游应用依赖于模型的选择结果,就需要测试该选择在不同呈现方式下是否稳定;如果依赖于分数阈值,就需要确认分数水平在不同评分格式下是否可比。
对于构建自动化评估系统的团队,这意味着不能仅凭模型在标准测试集上的表现就将其投入生产。呈现敏感性审计应当成为评估器部署前的常规检查项。
呈现敏感性审计在设计上类似于软件工程中的扰动测试(perturbation testing):保持核心输入不变,系统性地扰动无关维度,观察输出是否发生非预期变化。对于选择型接口,审计应至少覆盖选项位置交换、标识符替换和框架改写;对于评分型接口,则应比较不同评分量表(如1-5分与1-100分)下的分数分布与排名一致性。一个实用的检查指标是选择翻转率:在成对比较中交换呈现方式后,选择结果发生改变的比例。若翻转率显著高于零,则下游依赖该选择结果的任何决策都面临额外风险,需要引入聚合策略(如双向评估取平均)或显式控制呈现变量。
结语
类型化决策模型为低成本自动化评估提供了结构化的选择、分数和概率输出,但这项审计表明,这些输出的稳定性远没有想象中可靠。在主观文本评估场景中,呈现方式本身就是一个需要被控制的变量,而非可以忽略的噪声。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。