理论级自动形式化的忠实性对齐:FaithAlign基准解读

新研究指出自动形式化的瓶颈在忠实性,并提出理论级基准 FaithAlign。
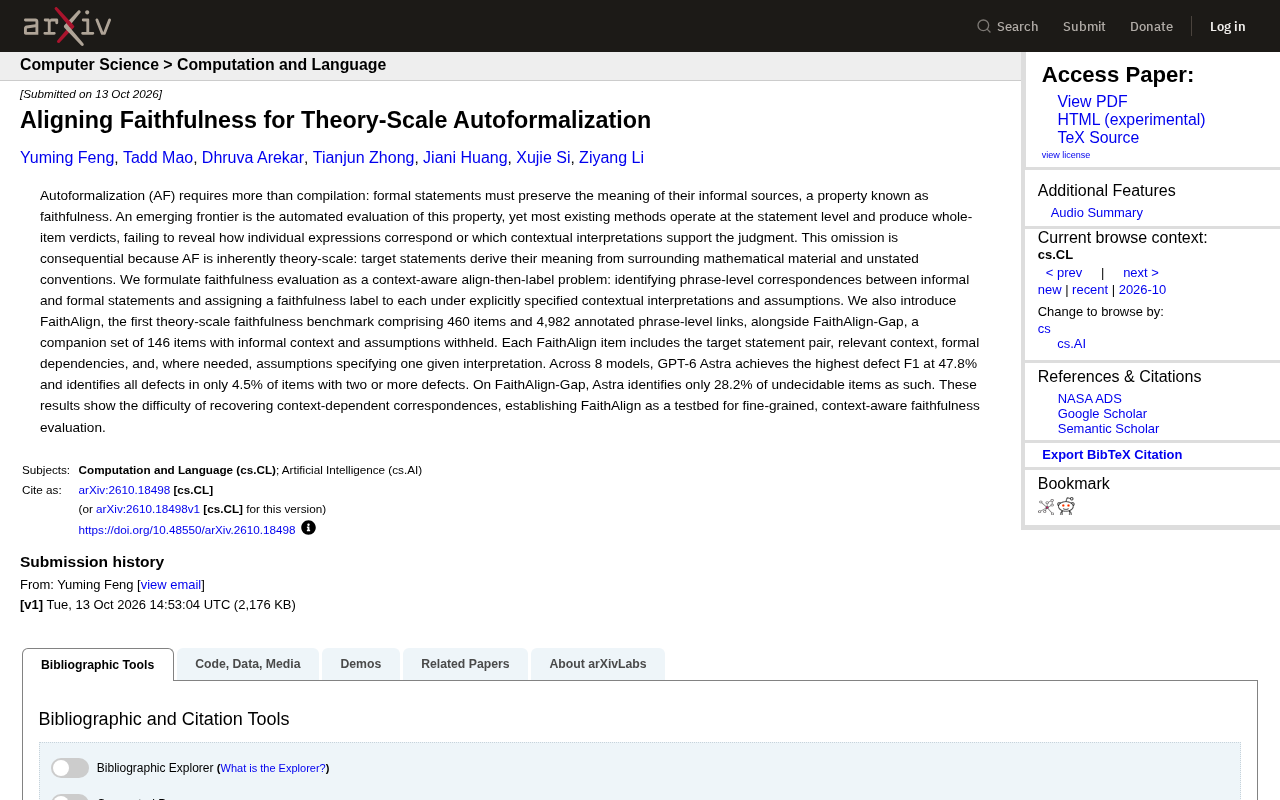
自动形式化的目标是将自然语言数学命题翻译为形式语句,但编译通过并不等于翻译正确。最新研究指出,现有语句级二元评估无法揭示短语级对应关系,在理论级场景下尤其失真。研究将忠实性评估重构为上下文感知的「对齐-再标注」问题,并提出首个理论级忠实性基准 FaithAlign,含 460 个条目和 4,982 条短语级标注链接,配套 FaithAlign-Gap 则隐去上下文与假设以测试模型识别不可判定情况的能力。在 8 个模型中,GPT-6 Astra 的缺陷 F1 最高仅为 47.8%,多缺陷条目全识别率仅 4.5%,面对不可判定条目也仅正确识别 28.2%。这些数字显示,恢复依赖上下文的对应关系极其困难,评估需从「打分」升级为「对齐」。
自动形式化不只是编译:忠实性才是真正的瓶颈
自动形式化(Autoformalization, AF)的目标是把自然语言数学命题翻译成形式化语句。但一篇最新研究指出,编译通过并不等于翻译正确——形式语句必须保留非形式来源的语义,这一属性被称为「忠实性(faithfulness)」。
现有评估方法大多停留在语句级别,只输出「整体是否忠实」的二元判断,无法揭示具体是哪个表达式对应哪个表达式,也无法说明哪些上下文解释支撑了这一判断。这个缺陷在理论级场景下被放大:目标语句的含义往往来自周围的数学材料和未明说的约定,脱离语境的评估几乎注定失真。
自动形式化(Autoformalization, AF) 是形式化数学与 AI 交叉领域的一个核心任务,其思想可追溯到 20 世纪的形式化数学实践,如 Mizar 与 Isabelle 等项目将教科书级数学逐步翻译为可机器验证的证明。传统上这类工作依赖人工,成本极高。近年来,随着大语言模型在代码与数学推理上的能力提升,AF 被视为有望规模化的路径:模型读入一段自然语言命题或证明,输出 Lean、Coq、Isabelle 等证明助手可接受的语句。
需要区分的是,AF 的产出通常分为两层:一是语法可接受,即输出能被证明助手解析、类型检查通过;二是语义正确,即形式语句表达了非形式原句实际想表达的含义。前者类似「代码能编译」,后者才是数学意义上真正「翻译对了」。长期以来,多数工作只报告编译成功率或类型检查通过率,因为这些指标客观、可自动测量,但这恰恰回避了最难也最关键的部分。
从「整体判断」到「对齐再标注」
研究团队把忠实性评估重新定义为一个上下文感知的「对齐-再标注」问题:先识别非形式语句与形式语句之间的短语级对应关系,再在明确给定的上下文解释与假设下,为每一对对应赋予忠实性标签。
这个思路改变了评估的粒度。过去是「整句对或错」,现在是「这个短语在什么假设下对应那个形式表达」。理论上更严谨,工程上也更可诊断——模型出错时,你能定位到具体表达式,而不是拿到一个模糊的失败信号。
短语级对齐(phrase-level alignment) 借鉴了自然语言处理中词对齐与结构化对齐的思路,例如统计机器翻译时代的 IBM 模型、以及后来在语义解析中用于连接自然语言片段与逻辑形式的对齐标注。其核心假设是:一个复杂语句的翻译正确性可以分解为若干局部对应关系,只要每一对「非形式片段—形式表达式」在给定上下文下都被判定为忠实,整体便更可解释、更可诊断。
「对齐-再标注」 中的「再标注」强调忠实性是条件性的:同一形式表达式在不同假设下可能忠实也可能不忠实。因此评估的输出不是单一的 True/False,而是形如「在假设 H 下,非形式短语 p 与形式表达式 e 对应且忠实」的三元结构。这种结构使错误可归因、可追溯,也为后续自动检查提供了更细的信号。
FaithAlign:首个理论级忠实性基准
论文提出了 FaithAlign,号称首个理论级忠实性基准,包含 460 个条目和 4,982 条短语级标注链接。每个条目配有目标语句对、相关上下文、形式依赖,以及(在需要时)指定某一给定解释的假设。
同时发布的还有 FaithAlign-Gap,共 146 个条目,其特点是隐去了非形式上下文与假设。这一设计直接测试模型在信息不完整时能否识别「无法判定」的情况,而不是硬给一个判断。
理论级(theory-scale) 指的是评估对象不局限于孤立的引理或练习,而是处于一个成体系的数学理论中:定义、定理、约定、记号惯例相互依赖,单条命题的含义往往由所在理论的整体框架决定。这带来两个后果:其一,脱离上下文的语句可能有多种合理形式化;其二,「忠实」与否必须相对于一组显式或隐式的背景假设来判定。
FaithAlign-Gap 中的「Gap」即指信息缺口:通过隐去非形式上下文与假设,构造出模型本应无法判定的条目。这借鉴了自然语言处理中「可回答性」与「拒答」任务的设计理念——好的系统不仅要能判断,还要能在信息不足时明确表示不确定,而不是产生看似合理的幻觉式结论。
八模型实测:最高缺陷 F1 仅 47.8%
在 8 个模型的评测中,GPT-6 Astra 取得了最高的缺陷 F1,为 47.8%。更你可能没注意到细粒度表现:在包含两个及以上缺陷的条目中,Astra 只有 4.5% 能找出全部缺陷。
在 FaithAlign-Gap 上,Astra 仅将 28.2% 的不可判定条目正确识别为「不可判定」。这说明当上下文和假设被隐去时,模型倾向于强行给出判断,而非承认信息不足。
缺陷 F1(defect F1) 是评估模型识别「不忠实对应」能力的指标,综合了精确率与召回率:既要尽量找出所有真实存在的缺陷(召回),又不能把忠实对应误判为缺陷(精确)。在忠实性评估中,这是一个偏保守的指标——它惩罚「漏报」也惩罚「误报」。
不可判定(undecidable / indeterminate) 在此处不是哥德尔意义上的不可判定,而是指在当前给定信息下无法唯一确定忠实性的情形。正确地输出「不可判定」,在评估中往往比给出一个碰巧正确的猜测更有价值,因为它反映了模型对自身知识边界的认知。Astra 仅识别 28.2% 的不可判定条目,意味着大量本应拒答的样本被强行判定为忠实或不忠实。
这组数字说明了什么
47.8% 的缺陷 F1 意味着即使最强模型,在短语级忠实性判断上仍有超过一半的缺陷被漏掉或误判。4.5% 的全缺陷识别率更直接:多缺陷条目几乎全军覆没。
这些结果指向一个核心难点——恢复依赖上下文的对应关系极其困难。形式化语句的语义往往锚定在更大范围的理论约定里,而模型缺乏显式追踪这些锚点的机制。FaithAlign 的价值正在于此:它把「上下文感知的细粒度忠实性评估」变成了一个可量化、可复现的测试床。
对自动形式化研究的启示
如果忠实性无法被可靠评估,自动形式化的产出就无法被信任,下游的定理证明与数学推理也会继承这些隐性错误。FaithAlign 揭示的差距提示两个方向:一是模型需要显式建模上下文与假设,而非隐式吸收;二是评估本身要从「打分」升级为「对齐」,让每个判断都可追溯。
对于构建数学 AI 工具链的团队,这意味着流水线中需要引入短语级对齐检查,而不是只跑一遍编译。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。