廉价模型能胜任代码审查吗?GPT-5.6 Luna对比GPT-6 Astra
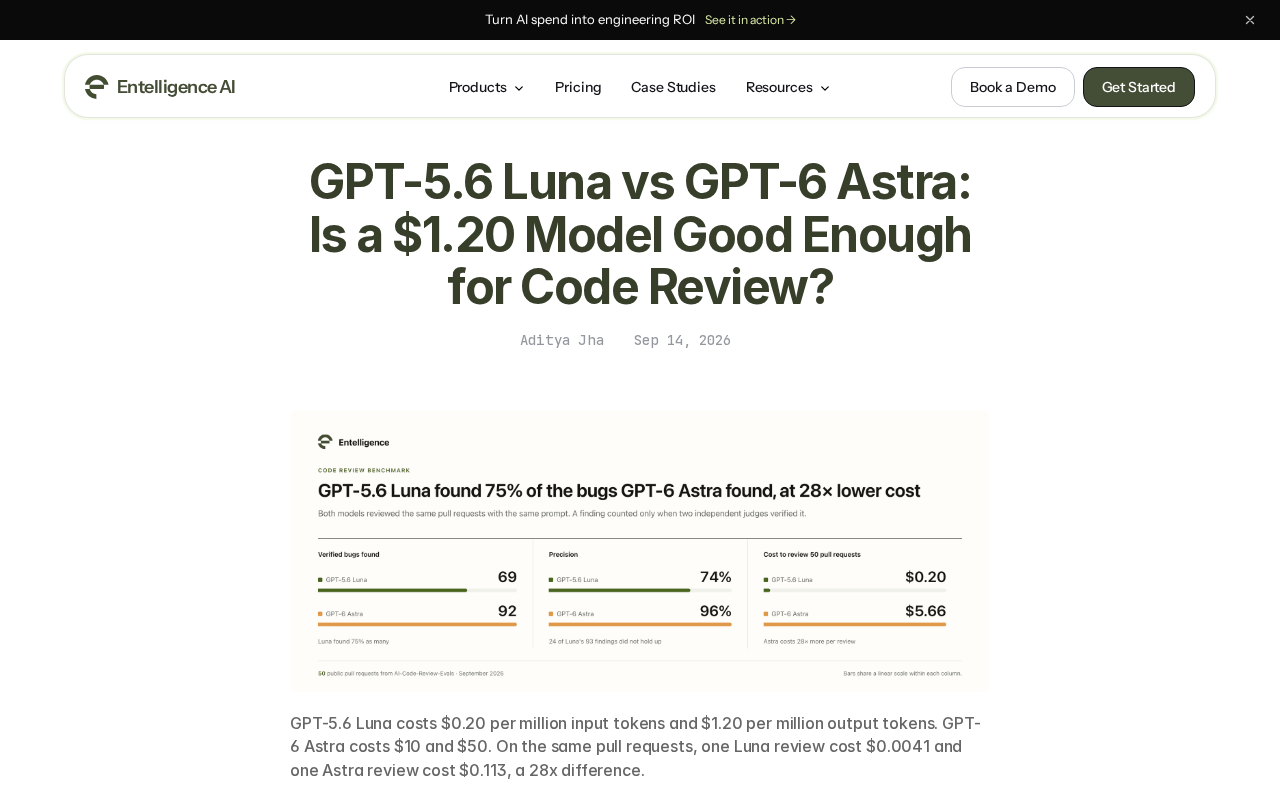
便宜AI模型能否胜任代码审查?答案取决于场景——分层路由才是正解。
Hacker News上一则关于高低价AI模型做代码审查的讨论,引出了一个工程团队普遍面临的决策难题:$1.20的廉价模型究竟够不够用?文章指出,代码审查是判别性任务,对低误报率和长上下文理解要求极高,恰好是廉价模型短板最易被放大的场景。但真正务实的解法并非非此即彼,而是分层路由:让便宜模型处理格式、风格等简单任务,将涉及安全、架构等高风险变更升级给旗舰模型。评估时应以"每美元有效发现数"而非单纯准确率为核心指标,并依托真实历史PR而非公开跑分来建立私有评测集。底线结论是:在正确场景花正确预算,永远比追逐最强模型更重要。
一个老问题的新版本:便宜模型够用吗?
Hacker News 上一篇标题为《GPT-5.6 Luna vs. GPT-6 Astra: Is a $1.20 Model Good Enough for Code Review?》的讨论引发了不少关注(55 points,64 条评论)。核心问题并不新鲜,却始终困扰着每一个把大语言模型接入开发流程的团队:当你要做的是**代码审查(Code Review)**这类高频、批量、对准确率有要求的任务时,是该用价格更低的模型,还是咬牙上更贵的旗舰?
标题里那个 "$1.20" 的数字很有意思——它把抽象的"模型能力"折算成了具体的单位成本。对于每天要跑成百上千次审查请求的工程团队来说,单次调用差几毛钱,乘以规模之后就是一笔实打实的预算差异。这也是为什么"够用就好"(good enough)在工程语境下往往比"最强"更值得认真讨论。
需要说明的是,本文基于该 Hacker News 帖子的标题与讨论热度展开分析。原帖具体的评测数据和评论细节有限,文中涉及的方法论属于对这一命题的通用性延伸,供读者参考。
代码审查为什么是个特殊场景
代码审查和普通的代码生成有着本质区别。生成任务允许一定的"创造性",即便模型给出的方案不是最优,人类还能在此基础上修改。但审查任务本质上是判别性的:模型需要判断这段代码是否存在 bug、安全隐患、性能问题或风格违规,并给出可操作的反馈。
这带来两个对模型能力的特殊要求。其一是低误报率。如果一个审查工具动辄标出大量假阳性(false positive),开发者很快就会失去信任并直接忽略它,那么再便宜也是浪费。其二是上下文理解的深度。真实项目的代码往往跨文件、跨模块,一个函数的正确性可能依赖于别处的约定。廉价模型通常在长上下文和复杂推理上表现更弱,恰恰是审查最吃紧的地方。
换句话说,代码审查是那种"便宜模型的短板会被放大"的场景,也正因如此,Luna 和 Astra 的对比才有讨论价值。
成本与能力的权衡:不是二选一
把问题简化成"贵的更好还是便宜的够用"其实是个陷阱。更务实的做法是分层路由(tiered routing):用便宜模型处理简单、高频的初筛,把复杂或高风险的变更升级给更强的模型。
这种架构在实践中已经相当常见:
- 格式与风格检查:这类规则明确、判断简单的任务,廉价模型(如 Luna 类定位)完全够用,甚至传统的静态分析工具就能覆盖。
- 逻辑与边界条件审查:涉及推理链条,便宜模型可能漏判,需要视情况升级。
- 安全与架构级评审:高风险、低容错,这类场景把预算投给旗舰模型(如 Astra 类定位)更划算——一个被漏掉的安全漏洞的代价,远超模型调用的差价。
在这个框架下,"$1.20 的模型够不够用"的答案是:取决于你让它审查什么。用错场景,再贵的模型也可能给出不靠谱的结论;用对场景,便宜模型的性价比会非常突出。
如何客观评估:别只看跑分
讨论区里这类命题最容易陷入主观印象之争。要得出可信结论,团队应该建立自己的评测集,而不是照搬公开 benchmark。建议关注几个维度:
- 真实 PR 回放:拿历史上已知有问题的 Pull Request,看模型能否识别出当时人工发现的问题。
- 误报统计:在一批"干净"的代码上运行,统计模型错误标记的比例。
- 可操作性评分:模型给出的建议是否具体、可执行,而不是泛泛而谈"建议优化"。
- 单位成本产出:把"每美元捕获的有效问题数"作为核心指标,而非单纯的准确率。
当把成本纳入分母,很多结论会发生反转。一个准确率略低但便宜五倍的模型,在"每美元有效发现"这一指标上可能反而胜出——前提是你已经用分层路由把高风险场景兜住了。
给工程团队的实用建议
对于正在评估 AI 代码审查方案的团队,与其纠结于某个具体模型版本的名号,不如把精力放在流程设计上:
- 先跑基线:用便宜模型作为默认审查器,观察它在你的代码库上的真实表现。
- 设置升级触发条件:对涉及认证、支付、数据处理等敏感目录的变更,自动升级到更强模型。
- 保留人工兜底:AI 审查是加速器而非替代品,关键合并仍需人工确认。
- 持续监控成本曲线:随着调用量增长,定期复盘分层策略是否仍然经济。
"$1.20 够不够用"这个问题,最终会随着模型迭代不断刷新答案。但底层的工程智慧不会过时:在正确的地方花正确的钱,永远比追逐最强模型更重要。
相关推荐
苹果Home引入AI摄像头功能:月费最高60美元
苹果随iOS 27和tvOS 27将Apple Intelligence引入Apple Home,为HomeKit Secure Video带来AI视频摘要功能,可生成摄像头画面的文字描述,但需订阅解锁,最高月费达60美元。
AI竞赛上升为国家安全:中美如何将技术竞争推向存亡叙事
美国财政部长称若在AI竞赛中输给中国将“没有后天”,中国外交部回击美方安全论是维护技术霸权的借口。本文分析AI竞争如何从企业博弈升级为国家安全叙事及其现实风险。
AI巨头集体"踩刹车":安全协议还是行业垄断?
OpenAI、Anthropic、Google DeepMind与SpaceX的领军人物就放缓AI开发达成共识,宣称要"把控前沿节奏"。这究竟是负责任的安全公约,还是维持寡头地位的行业卡特尔?本文剖析安全叙事与竞争逻辑之间的深层张力。