联想Yoga Pro 9N:128GB统一内存+RTX Spark的本地AI工作站

联想Yoga Pro 9N以128GB统一内存突破显存瓶颈,将高端笔记本定位为本地大模型推理工作站。
联想新推出的Yoga Pro 9N与Yoga 9N 2-in-1,最高配置128GB可与NVIDIA GPU共享的统一内存,意图将旗舰笔记本打造成兼顾本地AI推理、创意生产与游戏的复合型工作站。两款机型均搭载RTX Spark平台,Blackwell架构显卡性能对标桌面RTX 5070。Pro版侧重极致性能与存储扩展(最高4TB双SSD),2-in-1版则以更大屏幕、更大电池和灵活形态取胜,内存上限为64GB。统一内存架构打破了传统独立显存的容量天花板,使本地运行大型AI模型成为可能,但NVIDIA平台的软件生态与苹果M系列存在差异,实际推理效率仍待验证。价格尚未公布,顶配版本预计昂贵,真实散热与续航表现也有待实测。
联想推出的新一代Yoga旗舰笔记本把配置推向了一个新高度——最高128GB内存,并且这块内存可以与NVIDIA GPU共享使用。这台名为Yoga Pro 9N的机器搭载了RTX Spark平台,组合了最高20核心的CPU与Blackwell架构的RTX显卡,性能据称可以对标桌面级的RTX 5070。对AI本地运行场景而言,这种设计的意义远不止纸面参数那么简单。
统一内存:把Mac的思路搬到NVIDIA平台
真正值得关注的,是这套系统采用的统一内存架构。它的工作方式类似于苹果M系列芯片上RAM与GPU共享内存池的做法。对于游戏笔记本来说,显存通常是独立且容量有限的,这直接限制了能在本地加载的AI模型规模。
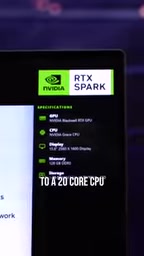
而最高128GB共享内存意味着,用户可以在本地跑起体量更大的AI模型,同时还能应对高负载的视频剪辑和3D创作。换句话说,这块超大内存池让笔记本从单纯的游戏设备,转变为可以胜任本地大模型推理的创作工作站。这也是联想这次主打的卖点——一台便携的AI与创意工作站,顺带还能打游戏。
统一内存架构(Unified Memory Architecture,UMA)的核心思想是让CPU与GPU共享同一块物理内存,消除两者之间的数据拷贝开销。在传统PC架构中,GPU拥有独立的显存(VRAM),当AI模型需要在CPU与GPU之间传递数据时,必须经历显存↔系统内存的搬运过程,这既耗时又占用带宽。苹果M系列芯片将这一架构发挥到极致,其"统一内存"允许神经网络推理框架(如MLX)直接让CPU和GPU操作同一份数据,不产生拷贝。NVIDIA在这台机器上实现的共享内存池,原理上类似,但底层实现方式不同:它依赖于现代操作系统的内存管理与PCIe/显存虚拟化技术,让GPU可以寻址更大范围的系统内存。需要注意的是,共享系统内存的带宽通常低于专用GDDR显存,因此在实际AI推理中,128GB的容量优势能否弥补带宽上的差距,是评估这套方案性能时的关键变量。
两款机型:Pro 与 2-in-1 的分工
这次联想一口气推出了两款机型,定位略有差异。
Yoga Pro 9N:常规旗舰形态
Pro版本是标准的笔记本形态,重量约1.65kg,配备15.3英寸165Hz OLED屏幕。存储方面提供两个SSD插槽,最高可配置到4TB。这台机器把重心放在性能堆料上,128GB内存+4TB存储的顶配版本是它的最高规格。
Yoga 9N 2-in-1:更灵活的变形本
另一款是Yoga 9N 2-in-1,从视频作者的评价来看,这款反而更受青睐。它的内存上限降到了64GB,但换来了更大的16英寸120Hz OLED屏幕,并且支持帐篷模式,甚至可以完全翻折成平板使用。此外,这款2-in-1还搭载了更大容量的电池。
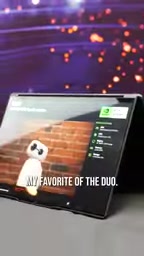
两款机型的取舍很清晰:追求极致本地AI性能和存储扩展的选Pro,更看重屏幕尺寸、形态灵活性和续航的选2-in-1。
悬而未决的价格与真实表现
联想目前尚未公布具体售价。考虑到128GB内存加4TB存储的顶配组合,这台机器的最终价格注定不会便宜,顶配版本的定价很可能相当惊人。
除了价格,真实使用中的表现同样是未知数。桌面级RTX 5070的性能能否在笔记本的散热和功耗约束下稳定释放,大内存与高性能组件对续航的影响有多大,这些都需要实际上手后才能验证。统一内存架构虽然在理论上很有吸引力,但NVIDIA平台上的软件生态与苹果M系列并不完全相同,本地AI模型的实际运行效率仍待观察。
这类产品释放了什么信号
抛开具体机型,联想这次的配置方向本身传递出一个明确趋势:本地AI能力正在成为高端笔记本的核心竞争力之一。随着越来越多用户希望在本地运行大模型而非依赖云端,显存/内存容量这个过去主要被游戏和专业创作关心的指标,开始承载AI推理的新需求。
统一内存架构的引入,正是厂商为了打破传统显存容量天花板所做的尝试。联想把游戏性能、创意生产力和形态灵活性整合进同一产品线,意图很明显——面向那些既要生产力、又要娱乐、还要本地AI能力的复合型用户。至于这套方案是否值得为之买单,还得等价格落地和真实评测揭晓。
本地大模型推理对内存容量的需求,可以用一个简单框架来理解:一个参数量为N的模型,以FP16精度加载大约需要2N字节的显存。以目前主流的开源模型Llama 3 70B为例,FP16精度下需要约140GB,量化到4-bit后仍需约35GB。这意味着传统游戏本8-16GB的独立显存完全无法胜任,即便是专业卡也面临瓶颈。128GB的共享内存池从容量角度确实能覆盖大多数当前主流开源模型(包括量化版的千亿参数模型),这是它对本地AI用户最直接的价值所在。随着模型参数量持续增长,内存容量这一指标在消费级硬件的产品竞争中将愈发重要。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。