两个AI架构实验:共享MLP与FFT非线性记忆

两项小型架构实验:共享MLP的PHSMLP与FFT加速记忆的Pilot,各有局部亮点但整体未超越Transformer。
开发者分享了PHSMLP和Pilot两项单种子、小规模神经网络架构实验。PHSMLP探索跨层共享同一个MLP,在5亿token训练下测试准确率仅落后标准Transformer不到3个百分点,参数减少13.4%,且消融实验证明pooling机制被有效利用。Pilot结合FFT计算的显式输入历史与非线性矩阵记忆,在参数匹配下语言建模困惑度比四头Transformer低16.7%,但在多选题记忆任务中表现更差,且训练速度慢约60倍、远距离上下文利用有限。作者强调两项工作均为初步探索,代码与PDF已公开,希望社区帮助改进Pilot的记忆与效率。
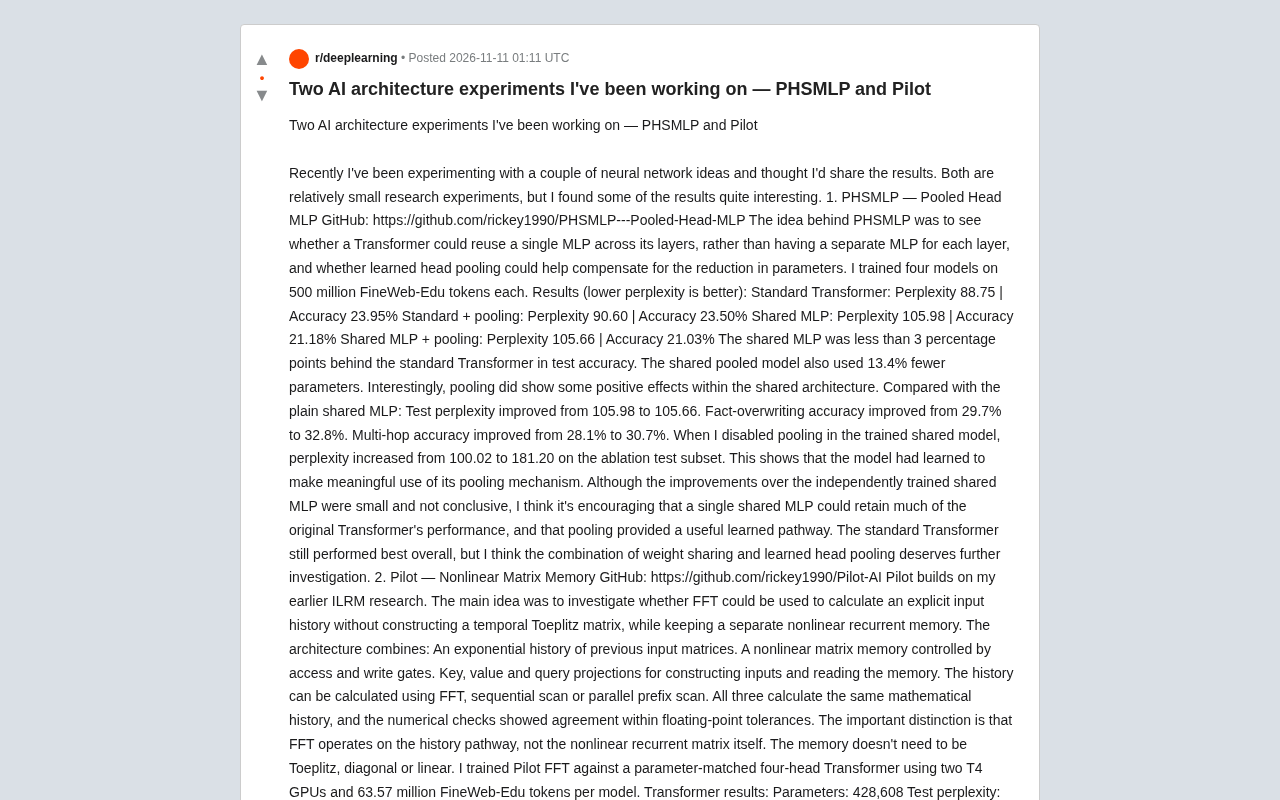
一位开发者在Reddit上分享了两项小型神经网络架构实验——PHSMLP和Pilot。两者都是单种子、小规模的研究探索,作者本人也明确表示不主张它们整体上优于Transformer,但其中一些结果值得关注。
PHSMLP:让Transformer复用同一个MLP
PHSMLP(Pooled Head MLP)的核心问题是:Transformer能否在所有层之间共享同一个MLP,而不是每层各有一个?如果共享导致参数减少,学习到的head pooling能否弥补性能损失?
作者在5亿个FineWeb-Edu token上训练了四个模型,结果如下(困惑度越低越好):
| 模型 | 困惑度 | 准确率 |
|---|---|---|
| 标准Transformer | 88.75 | 23.95% |
| 标准 + pooling | 90.60 | 23.50% |
| 共享MLP | 105.98 | 21.18% |
| 共享MLP + pooling | 105.66 | 21.03% |
共享MLP在测试准确率上落后标准Transformer不到3个百分点,同时参数减少了13.4%。这个差距对于一次激进的参数共享实验来说并不算大。
Pooling在共享架构内表现出局部价值
虽然pooling没能让共享模型追平标准Transformer,但它在共享架构内部显示出一些正面效果。相比纯共享MLP,加入pooling后:
- 测试困惑度从105.98降至105.66
- 事实覆写准确率从29.7%提升至32.8%
- 多跳推理准确率从28.1%提升至30.7%
更有说服力的证据来自消融实验:在训练好的共享模型中关闭pooling后,消融测试子集上的困惑度从100.02飙升到181.20。这说明模型确实学会了有意义地利用pooling机制,而非将其当作冗余组件。
作者也坦承,相比独立训练的共享MLP,pooling带来的提升幅度较小且不够确凿。但一个共享MLP能保留原Transformer的大部分性能,加上pooling提供了有用的学习通路,这两点组合起来值得进一步研究。
参数共享(Parameter Sharing) 是神经网络中降低模型参数量、提升泛化能力的常用技术,其核心思想是让网络中多个位置或模块复用同一组权重。在Transformer中,典型的参数共享包括跨层共享自注意力权重、共享前馈网络(FFN/MLP)等。PHSMLP探索的正是跨层共享MLP:标准Transformer每一层都有独立的MLP,参数量随层数线性增长;若所有层共享同一个MLP,这部分参数可压缩为常数。代价是模型表达能力受限,因为不同层无法学习各自专用的特征变换。共享MLP的性能损失程度,取决于任务复杂度和模型深度——浅层或简单任务中损失较小,深层或需要分层抽象的任务中损失更明显。
Head Pooling(头池化) 在PHSMLP语境下,指对多个注意力头或层间表示进行加权聚合的机制。多头注意力中,每个头关注不同的子空间;头池化通过学习到的权重将这些头的输出合并,使共享MLP能接收到经过筛选的、更具信息量的输入。与简单的平均池化或取最大值不同,可学习的头池化允许模型自适应地决定哪些头的信息更重要,从而在参数共享的约束下保留一定的表达能力。
Pilot:FFT加速的显式输入历史 + 非线性矩阵记忆
Pilot基于作者此前的ILRM研究,探索能否用FFT计算显式输入历史,而不必构造时间Toeplitz矩阵,同时保留一个独立的非线性循环记忆。
架构包含三个部分:
- 先前输入矩阵的指数历史
- 由访问门和写入门控制的非线性矩阵记忆
- 用于构造输入和读取记忆的key、value、query投影
历史计算可以用FFT、顺序扫描或并行前缀扫描完成,三者计算相同的数学历史,数值检查显示在浮点容差内一致。关键区别在于:FFT作用于历史通路,而非非线性循环矩阵本身。记忆不需要是Toeplitz、对角或线性的。
语言建模胜出,但记忆任务落败
作者用两块T4 GPU、每个模型6357万FineWeb-Edu token,将Pilot FFT与参数匹配的四头Transformer进行对比:
| 模型 | 参数量 | 困惑度 | 准确率 |
|---|---|---|---|
| Transformer | 428,608 | 126.24 | 17.61% |
| Pilot | 428,523 | 105.15 | 20.35% |
Pilot的测试困惑度比Transformer低16.7%,作者称这是一个惊喜。但它在记忆和推理测试中并未全面胜出:96道多选题中,Transformer答对17道,Pilot只答对11道。两个模型在无限制下一token答案上都得了零分,都无法可靠解决回忆、事实绑定或多跳推理任务。
Pilot对远距离上下文的利用也很有限,且在当前实现下训练速度慢约60倍。语言建模的积极结果与长期记忆、训练效率的短板同时存在。
至于名字的由来,作者说AI领域已有不少凶猛动物命名,想找个带英国关联的——英国可选的猛兽不多,于是想到了领航鲸(pilot whale),而且这本身也是该想法的领航实验。
FFT(快速傅里叶变换) 在序列建模中用于加速卷积运算。时域上的卷积等价于频域上的逐点相乘,因此对序列做FFT、与滤波器的频域表示相乘、再做逆FFT,可将卷积复杂度从O(N²)降至O(N log N)。Pilot利用这一性质计算“显式输入历史”:历史信息本质上是输入序列与某种核函数的卷积,直接在时域构造Toeplitz矩阵需要O(N²)存储和计算,而FFT路径避免了显式矩阵构造。需要注意的是,FFT只能加速线性卷积,非线性循环记忆部分仍需顺序或并行扫描处理。
Toeplitz矩阵 是一种每条对角线元素相同的矩阵,常出现在卷积和线性时不变系统的表示中。在序列模型中,若用矩阵乘法表示因果卷积(当前输出是历史输入的加权和),该矩阵就是下三角Toeplitz矩阵。构造并存储完整的Toeplitz矩阵代价高昂,因此Pilot选择用FFT隐式地计算等价结果。
困惑度(Perplexity) 是语言建模中最常用的评估指标,定义为模型对测试集每个token的平均负对数似然的指数。困惑度越低,说明模型对下一个token的预测越准确、越“不困惑”。其数值可理解为模型在每一步平均需要在多少个候选词中做选择——理想情况下等于词表大小,实际远低于此。困惑度对token化方式和词表大小敏感,因此跨模型比较时需确保使用相同的tokenizer和测试集。Pilot的困惑度105.15对比Transformer的126.24,表明在相同参数量下,Pilot对语言序列的统计规律拟合更好。
多跳推理(Multi-hop Reasoning) 指需要串联多个事实或推理步骤才能回答的问题,例如“某人的出生地的国家首都是哪里”。这类任务要求模型在上下文中定位并组合多个分散的信息片段,对长距离依赖和记忆机制要求很高。Pilot和Transformer在这些任务上均表现不佳,说明当前架构在显式记忆和组合推理方面仍有明显短板。
两个实验的共同底色
作者反复强调这些是单种子、小规模实验,需要更多测试。PHSMLP证明了共享MLP能以更少参数保留Transformer的大部分预测性能,pooling在共享架构内显示出令人鼓舞的局部收益;Pilot则证明了FFT兼容的输入历史可以与非线性循环矩阵记忆协同工作,在匹配参数量下带来语言建模的改善。
两项工作的代码、研究PDF、图表和结果都在GitHub仓库中公开,作者特别希望了解如何在不增加大量额外机制、不改变原始数学的前提下,改善Pilot的记忆和速度。对于关注高效架构和替代注意力机制的研究者来说,这两个方向提供了可复现的起点。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。