两天11亿Token:用ChatGPT-Astra复现CS:GO实测
UP主白鸭用AI两天、消耗11.8亿Token,在Unity中复现了可玩的CS:GO原型Dust0。
B站UP主白鸭以ChatGPT为核心工具,历时两天、消耗11.8亿Token,在Unity引擎中复现了一款可玩的CS:GO原型「Dust0」。其中约10.34亿Token为缓存命中,真实增量成本远低于总量数字所呈现的震撼感。Dust0已实现买枪、切枪、烟雾、换弹、离线BOT爆破及回合结算等完整流程,技术核心难点在于让离线模式、客户端预测与联机服务器共用同一套战斗规则。地图、人物、武器等美术资产均来自原版,实验价值在于重新接通资源与规则而非凭空创造内容。整个项目揭示了当前AI辅助开发的真实边界:AI大幅压低执行成本,但目标设定、结果验证与问题定位仍需人的判断力。
一次极限的AI编程实验
B站UP主白鸭做了一件颇具话题性的事:用ChatGPT的Astra模型,在两天时间里消耗11.8亿Token,尝试用Unity重新实现一款可玩的CS:GO(反恐精英)Demo,项目命名为「Dust0」。
这不是一次简单的AI写代码演示,而是一场把「想法推到可玩程序」的完整工程实践。它同时暴露了当前AI编程的能力边界与真实成本——两个维度都值得认真拆解。
11.8亿Token,究竟花在了哪里
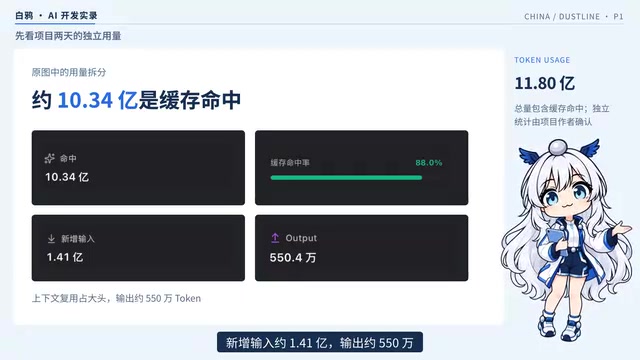
先把账单摆出来。据白鸭公布的独立统计,这个项目两天累计消耗 11.80亿 Token、8695次请求。这个数字看起来惊人,但拆开看结构更能说明问题:
- 约 10.34亿 是缓存命中(cache hit)
- 1.41亿 是新增输入
- 输出仅约 550万
换句话说,绝大部分Token并非真正的「新计算」,而是大量上下文的反复复用。在长周期、多轮迭代的编程任务里,模型需要不断携带前文的代码状态、需求约束和已知问题,缓存命中率高是必然结果。这也提醒我们:单看Token总量容易被吓到,但真实的增量成本远没有11亿那么夸张。
缓存命中(cache hit)是大语言模型API中的一种计费优化机制。当多次请求携带相同的前缀内容(如固定的系统提示、已生成的代码上下文),服务商会将这部分内容的KV缓存复用,不再重复全量计算,因此费率通常仅为普通输入Token的1/4甚至更低。在长周期编程项目中,每轮对话都需要把当前代码库状态、需求描述和历史问题一并传入,这段「前缀」高度重复,缓存命中率自然居高不下。OpenAI的Prompt Caching、Anthropic的Prompt Caching均采用类似机制。因此,在评估此类实验的实际成本时,应区分「总Token消耗」与「实际计费Token」,两者之间可能存在数倍差距。
跑起来的到底是什么
Dust0已经不是静态Demo,而是一套能连贯运行的游戏流程。据白鸭的实录展示,玩家可以进入Dust2地图,完成买枪、切枪、跑图、浇火(灭火/穿点)、换弹等操作,步枪和狙击枪各有独立的操作反馈——开镜、射击、烟雾从抛出到形成遮挡,都有对应表现。
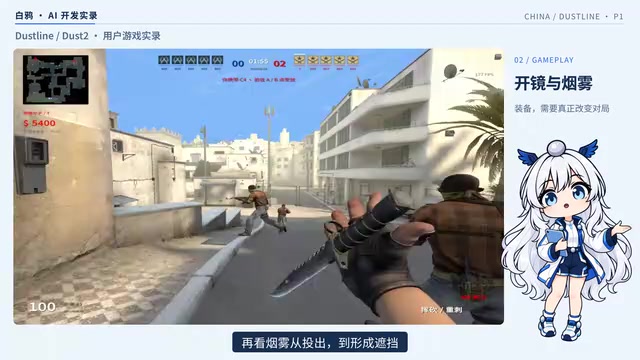
更关键的是,购买的装备要真正影响这一局的打法。移动、武器动作、道具效果必须放在同一个运行时里协同工作,而不是各自孤立的演示。项目还接入了离线BOT爆破模式,包含购买经济系统和回合结算,录像里能看到队友行动、击杀反馈和胜负提示。一局游戏的各个环节,已经开始真正衔接起来。
比画面更难的,是规则一致性
这个项目最有技术含量的部分,其实不在画面,而在底层规则的统一。
据白鸭介绍,项目把战斗逻辑放在共享的核心逻辑层里,让离线模式、客户端预测和联机服务器围绕同一套规则运作。开枪、伤害、弹药、回合这些核心机制,不能「各算各的」——否则联机时就会出现预测与服务器结果不一致的经典问题。
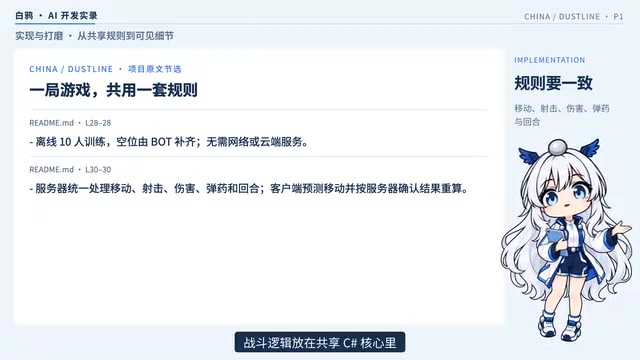
这恰恰是FPS游戏开发中最难啃的骨头。开发记录里最密集的修改,集中在这些细节上:换弹时的开镜灵敏度、人物跳跃时的持枪姿态、零层透明通道处理、烟雾生命周期、以及原生运行检查。AI生成代码之后,仍要一轮轮把可见问题修掉——这部分工作量并不比生成本身小。
客户端预测(Client-side Prediction)是多人FPS游戏网络架构中的核心技术,用于抵消网络延迟带来的操作卡顿感。其原理是:客户端不等待服务器确认,直接在本地预先执行玩家输入(如移动、开枪),呈现即时反馈;服务器随后对同一输入进行权威计算,若结果与客户端预测不符,则强制回滚并纠正。这一机制要求客户端与服务器必须运行完全相同的游戏逻辑,任何一处细微差异都会导致频繁的「橡皮筋」纠偏现象,严重破坏手感。CS系列游戏的网络模型自CS 1.6时代起便以精确的命中判定和低延迟响应著称,这也是为何规则统一性在这类项目中远比画面效果更难复现。
一个必须说清的前提:原版资源
这个成果需要一个诚实的注脚。据白鸭本人明确说明,地图、人物、武器、模型和动画都接入了原版资源。
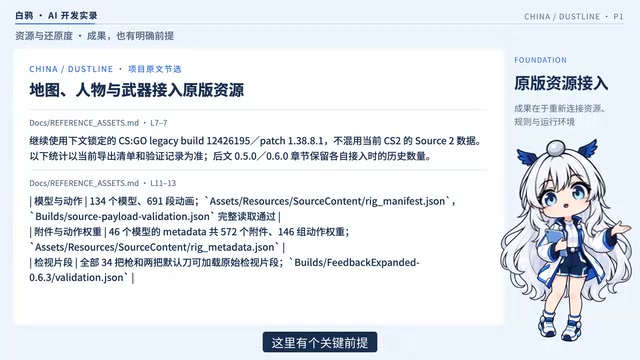
这意味着这次实验的价值,在于把「现成资源、游戏规则、运行环境」重新接起来并跑通,而不是从零创造美术内容。UP主自己也强调,不能把这些现成美术算成「模型凭空创造」,距离原版的完整体验,还差一些硬功夫——烟雾明暗、完整人物动作、部分引擎行为都仍在继续校准。
这种坦诚反而让实验更有参考价值:它划清了AI能做什么、不能做什么的边界。
AI与人的分工:谁定目标,谁干活
整个过程中,Astra承担了大量的实现与反复修改工作,但方向盘仍握在人手里。用白鸭的话说:人仍然要定目标、看结果、提问题。
这或许是这次实验最值得记住的结论。AI把编程的「执行成本」压到了极低,一个人两天就能推动一个原本需要团队周期的原型。但目标设定、结果验证、问题定位——这些需要判断力的环节,依然是人的核心价值所在。
11亿多Token值不值?答案不在数字本身,而要落到最终的真实体验:手感、稳定性和还原度,才是Dust0要面对的下一场考试。而对整个行业来说,这个实验提供了一个具象的样本——AI辅助开发的天花板正在快速抬高,但「最后一公里」的打磨,仍然离不开人。
白鸭使用的「Astra模型」指的是ChatGPT中集成的Project Astra能力,这是Google DeepMind与OpenAI各自在多模态实时交互领域的探索方向之一,但此处语境更可能指向OpenAI的某一具体API模型(如GPT-4o或o系列)。从Token消耗结构与多轮代码迭代的任务特性来看,这类长上下文编程工作流对模型的代码理解与增量修改能力要求极高,也是当前各大模型厂商重点优化的场景。将AI定位为「高速执行层」、人类保留「目标设定与结果验证」的协作模式,目前已被不少独立开发者和小型团队视为降低原型开发门槛的可行路径。
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。