量子分类器的深度与数据量:联合优化为何失效

实验发现自适应量子电路生长与训练数据量之间无可预测缩放规律,泛化边界有效但预测力极弱。
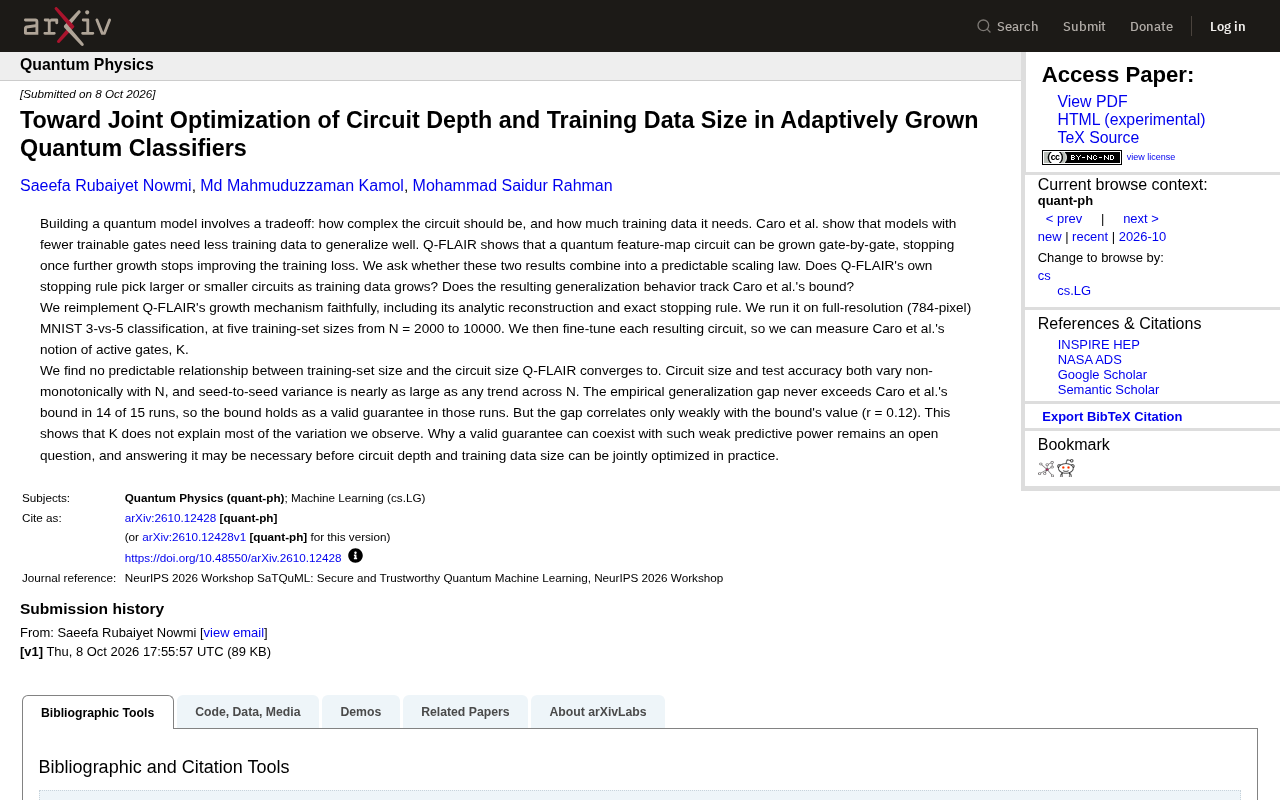
该研究复现了 Q-FLAIR 自适应生长机制,在 784 像素 MNIST 3-vs-5 任务上测试 N=2000 到 10000 五档训练集规模,并与 Caro 等人的泛化边界交叉验证。结果发现训练集大小与 Q-FLAIR 最终收敛的电路规模之间不存在可预测关系,电路规模和测试精度随 N 非单调变化,且不同随机种子间的方差几乎与跨 N 趋势一样大。Caro 边界本身在 15 次运行中 14 次成立,但边界值与实际泛化间隔的相关性仅为 r=0.12,预测力极弱。研究揭示了从理论边界到实际设计决策之间的断层。
量子机器学习常被寄予厚望,但一个核心矛盾始终存在:电路越复杂,表达力越强,代价是需要更多训练数据才能避免过拟合。Caro 等人曾给出一个理论边界——可训练门越少,泛化所需的数据就越少。Q-FLAIR 则提供了一套自适应方案:让量子特征映射电路逐门生长,直到训练损失不再下降为止。
这两个结果看起来可以拼在一起:用 Q-FLAIR 自动找到合适电路规模,再用 Caro 的边界预测泛化行为。但一篇最新研究通过完整复现实验发现,事情远没有这么简单。
两个既有结论的交叉点
研究从两个已发表结果出发。据 Caro 等人的工作,量子模型的可训练门数量(active gates,记为 K)与泛化所需训练数据量之间存在权衡关系:更少的门意味着更少的数据需求。这一结论为电路设计提供了理论依据。
另一条线索来自 Q-FLAIR。该方法可以让量子特征映射电路逐门增长,每一步都检查训练损失是否改善,一旦增长不再带来收益就停止。换言之,它自带一个停止规则来决定电路最终的大小。
研究者提出的问题是:如果把这两个结果放在一起,是否能得到可预测的缩放规律?随着训练数据量 N 增加,Q-FLAIR 会收敛到更大还是更小的电路?由此得到的泛化表现,是否遵循 Caro 等人给出的边界?
**泛化间隔(generalization gap)**是理解本文实验指标的关键概念。它通常定义为模型在训练集上的经验误差与在未见测试数据上的真实误差之差。泛化间隔越小,说明模型从训练数据到新数据的迁移能力越强;间隔过大则意味着过拟合。在量子机器学习中,由于可训练参数数量、电路纠缠结构和测量噪声等因素共同作用,泛化间隔的估计往往比经典模型更复杂。Caro 等人给出的理论边界正是对这一间隔的上界保证:在给定可训练门数量 K 和训练样本量 N 的条件下,泛化间隔以高概率不会超过某个与 K/N 相关的量。本文实验通过微调后的活跃门数量来检验这一边界是否成立,并进一步考察边界值本身能否预测实际观察到的间隔大小。
复现实验:从 MNIST 到五种数据规模
为了回答上述问题,研究团队忠实复现了 Q-FLAIR 的生长机制,包括其解析重构和精确停止规则。实验任务是在全分辨率(784 像素)的 MNIST 数据集上进行 3 与 5 的二分类。
训练集规模设置了五档,N 从 2000 到 10000。对每个收敛后的电路,研究者还进行了微调,以便按照 Caro 等人的定义测量活跃门数量 K。这样的设计使得电路规模、测试精度、泛化间隔与理论边界可以在同一框架下对比。
没有可预测的缩放规律
实验结果与预期并不一致。研究者发现,训练集大小与 Q-FLAIR 最终收敛的电路规模之间,不存在可预测的关系。
电路规模和测试精度都随 N 非单调变化——数据量增加并不必然导致电路更大或更小,精度也不随之稳定上升。更关键的是,不同随机种子之间的方差几乎与跨 N 的任何趋势一样大。这意味着即便观察到某种模式,也可能只是随机波动。
这一发现对“自适应生长能自动匹配数据量”的直觉构成了直接挑战。Q-FLAIR 的停止规则并没有在数据量变化时表现出系统性的响应。
随机种子方差在量子机器学习实验中具有特殊重要性。量子电路训练涉及参数初始化、数据采样顺序、优化器随机性甚至硬件噪声等多个随机源。当不同随机种子导致的最终电路规模或测试精度差异,与改变训练集大小 N 所产生的影响处于同一量级时,任何关于“N 增大导致电路如何变化”的结论都缺乏统计显著性。本文强调“方差几乎与跨 N 的任何趋势一样大”,实际上是在指出:在样本量有限、随机性来源众多的量子训练场景中,仅凭少数几组 N 值的平均结果很难区分真实趋势与噪声。这也解释了为何研究者采用 15 次运行来评估边界成立频率,而非依赖单次实验。
有效边界与弱预测力并存
Caro 等人的泛化边界本身在实验中仍然成立。在 15 次运行中有 14 次,经验泛化间隔没有超过该边界,说明边界作为保证是有效的。
但边界值对实际泛化间隔的预测力很弱。两者之间的相关系数仅为 r = 0.12。换句话说,K 只能解释观察到的泛化变化中的一小部分。一个有效的理论保证,同时伴随着极弱的预测能力。
研究者指出,这种“有效保证与弱预测力共存”的现象仍是一个开放问题。在能够从实践上联合优化电路深度与训练数据量之前,或许需要先回答这个问题。
相关系数 r = 0.12 的含义需要结合具体语境理解。相关系数衡量两个变量之间线性关系的强度和方向,取值在 -1 到 1 之间。r = 0.12 表示泛化边界值与实际泛化间隔之间仅有极弱的正相关,边界值的变化几乎无法解释实际间隔的波动。用决定系数衡量,边界值只能解释约 1.4% 的泛化间隔方差。在机器学习理论中,一个边界可以是“有效”的——即真实值确实不超过它——但同时“不紧”或“无预测力”,因为边界可能远高于实际值,或者其变化趋势与实际值脱节。本文的发现正属于后者:Caro 边界作为安全保证成立,但无法用来指导选择具体的电路规模或数据量。
对量子机器学习实践的启示
这项工作并不否定 Caro 等人的理论结果,也不否定 Q-FLAIR 的机制价值,但它揭示了一个被忽略的断层:从理论边界到实际设计决策之间,还缺少可操作的桥梁。
对于量子机器学习的研究者和工程师而言,这意味着不能简单假设“自动生长的电路会自动适配数据规模”。电路规模的选择可能需要更明确的先验知识或额外的验证流程。同时,泛化边界的有效性不应被等同于其预测力,两者需要分开评估。
至于如何找到那个能把电路深度与训练数据量真正联合起来的规律,论文留下的仍是一个悬而未决的问题。
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。