量子哈密顿嵌入:量子机器学习新框架

量子哈密顿嵌入将训练集编码为参数化哈密顿量,兼具理论保证与硬件演示。
文章介绍了一篇关于量子哈密顿嵌入(Quantum Hamiltonian Embeddings)的论文。该框架将经典训练数据集编码为一个参数化的有效哈密顿量,通过优化参数使近似基态定义分类规则,从而绕开传统参数化量子线路的训练困难。论文建立了高效梯度估计方法并证明了泛化保证,还在标准密码学假设下论证了该框架能实现超出高效经典算法能力的假设函数。推理阶段支持经典表示和量子表示两种方式,为不同硬件条件提供灵活性。研究团队在IBM Heron处理器上使用标准基准数据集完成了规模化演示,表明该框架具备实际运行路径,但其真实优势仍需更多数据集与硬件平台验证。
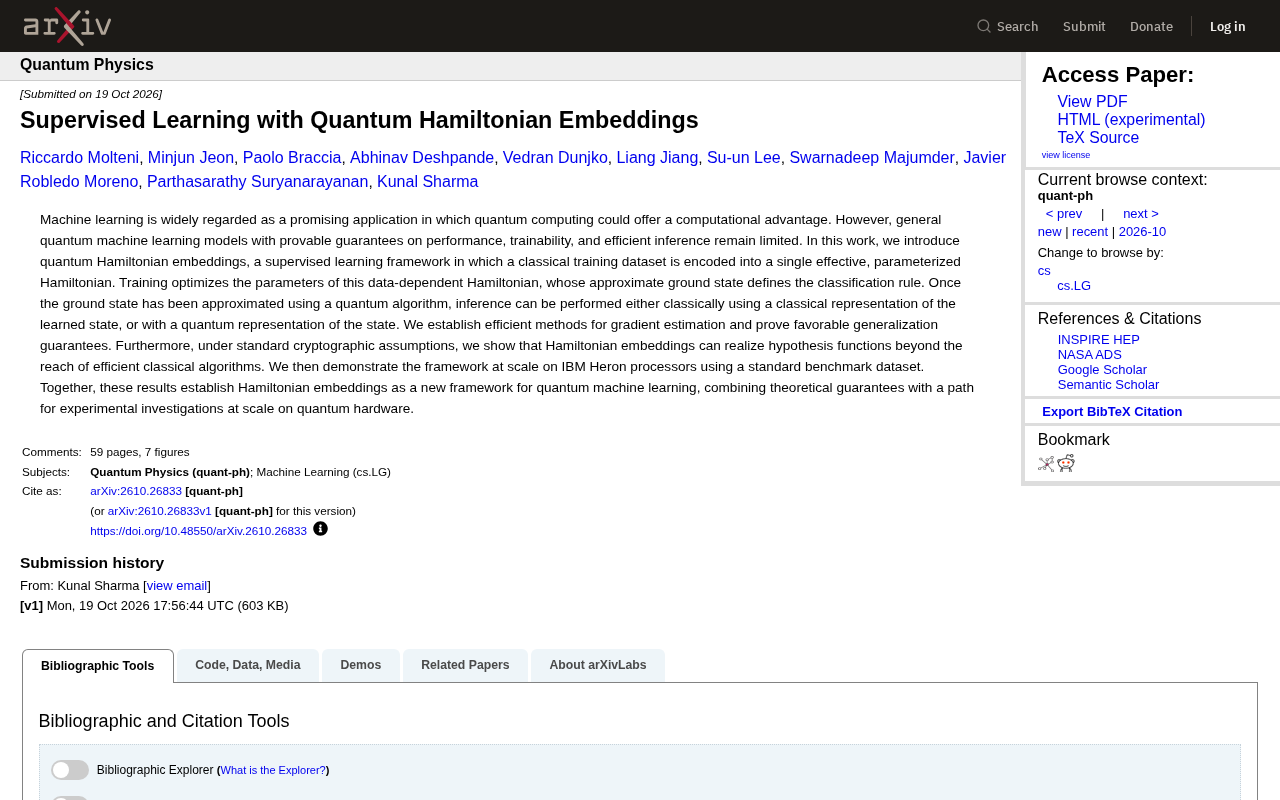
量子计算常被视为机器学习实现算力飞跃的潜在路径,但通用量子机器学习模型在性能保证、可训练性和高效推理方面始终缺乏严格证明。近期一篇论文提出的量子哈密顿嵌入(Quantum Hamiltonian Embeddings)框架,试图从理论到实验打通这条路径。该工作将经典训练数据集编码为一个参数化的有效哈密顿量,通过优化其参数使近似基态定义分类规则,并在IBM Heron处理器上完成了规模化演示。
框架核心:把数据集变成哈密顿量
传统量子机器学习通常将数据编码为量子态,再通过参数化量子线路进行处理。哈密顿嵌入的思路不同:它将整个经典训练集压缩成一个单一的、数据依赖的有效哈密顿量。训练过程就是调整这个哈密顿量的参数,使其近似基态能够反映分类边界。
这种设计的巧妙之处在于,分类规则不再依赖于某个特定的量子线路结构,而是由基态本身决定。一旦通过量子算法近似得到基态,推理阶段便有两种选择:使用学习到的态的经典表示进行经典推理,或直接使用量子表示进行量子推理。这为不同硬件条件下的部署提供了灵活性。
哈密顿量是量子力学中描述系统总能量的算符,其本征值和本征态决定了系统的能级结构与动力学演化。在量子计算语境下,寻找一个给定哈密顿量的基态(能量最低的本征态)是量子模拟、化学计算和组合优化中的核心任务,通常借助变分量子算法(如VQE)或量子相位估计来实现。将机器学习的数据集映射为哈密顿量,意味着可以把分类问题转化为寻找基态的问题:训练过程调节哈密顿量参数,推理过程则求解基态。这一视角与量子退火和伊辛模型求解组合优化问题的思路一脉相承,但哈密顿嵌入将其系统化地用于监督学习,并强调近似基态本身即可作为分类器,而无需还原出原始数据。
理论保证:梯度估计与泛化界
论文建立了高效的梯度估计方法,并证明了有利的泛化保证。这意味着该框架在训练过程中能够有效计算梯度,同时其泛化误差有理论上的上界。对于量子机器学习而言,这两点至关重要——梯度估计的可行性决定了模型是否可训练,泛化保证则决定了模型在未见数据上的表现是否可靠。
更引人注目的是,作者在标准密码学假设下证明,哈密顿嵌入能够实现超出高效经典算法能力范围的假设函数。这为量子机器学习相对于经典机器学习的计算优势提供了一个形式化论证,尽管该结论依赖于密码学假设的成立。
泛化界是统计学习理论中的核心概念,指模型在训练集上的表现与其在未见数据上的期望表现之间差距的严格上界,通常由模型复杂度(如VC维、Rademacher复杂度或假设空间的大小)和样本量共同决定。对于量子机器学习模型而言,证明非平凡的泛化界尤为困难,因为量子线路的假设空间往往难以用经典工具刻画。论文给出的泛化保证意味着,哈密顿嵌入的预测误差可以随训练样本数增加而以可控速率收敛,这为量子模型的可信部署提供了理论依据,也使其区别于许多仅凭实验表现宣称优势的量子机器学习方案。
标准密码学假设(如大整数分解困难、格问题困难或单向函数存在)是现代密码学安全性的基础,也是复杂性理论中划分计算难度的重要工具。在量子机器学习中,借助密码学假设证明“量子优势”是一种常见策略:若能证明某学习任务在假设成立时不存在高效经典算法,而量子框架可以完成,便构成了条件性的计算优势论证。这一思路的局限在于,结论的强度完全取决于假设是否成立;一旦假设被推翻或发现更高效的经典算法,优势论证便不再成立。因此,论文所述的“超出高效经典算法能力”应理解为在特定假设下的形式化陈述,而非无条件优势。
实验演示:IBM Heron处理器上的规模化运行
理论之外,研究团队在IBM Heron处理器上使用标准基准数据集进行了规模化演示。这表明哈密顿嵌入并非纯理论构造,而是具备在当前量子硬件上运行的实际路径。论文将这一框架定位为量子机器学习的新方向,兼具理论保证与在量子硬件上进行规模化实验研究的可行性。
IBM Heron是IBM于2023年底发布的新一代超导量子处理器,采用可调耦合器架构,提升了双量子比特门保真度和串扰抑制能力,是IBM量子路线图中从含噪中等规模量子(NISQ)向纠错量子计算过渡的关键硬件。在Heron上完成规模化演示,意味着实验规模超出了此前许多仅在小规模线路或模拟器上验证的量子机器学习工作。需要注意的是,当前超导硬件仍受门错误率和相干时间限制,因此论文的实验更多是展示框架的可行性路径,而非在实用规模问题上取得量子优势;基态近似所需的线路深度和量子比特数仍是决定该框架能否扩展到更大数据集的关键瓶颈。
意义与待解问题
哈密顿嵌入的价值在于它试图弥合量子机器学习理论与实验之间的鸿沟。通过将数据编码为哈密顿量,它绕开了参数化量子线路设计中一些固有的训练困难,同时提供了经典推理的退路。不过,该框架的实际优势仍需在更多数据集和硬件平台上验证,梯度估计和基态近似所需量子资源的规模也是后续研究需要回答的问题。
论文信息:Supervised Learning with Quantum Hamiltonian Embeddings,来源为arXiv预印本。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。